D·U·T Framework: Discover · Understand · Trust เตรียมเว็บให้พร้อม AI Search
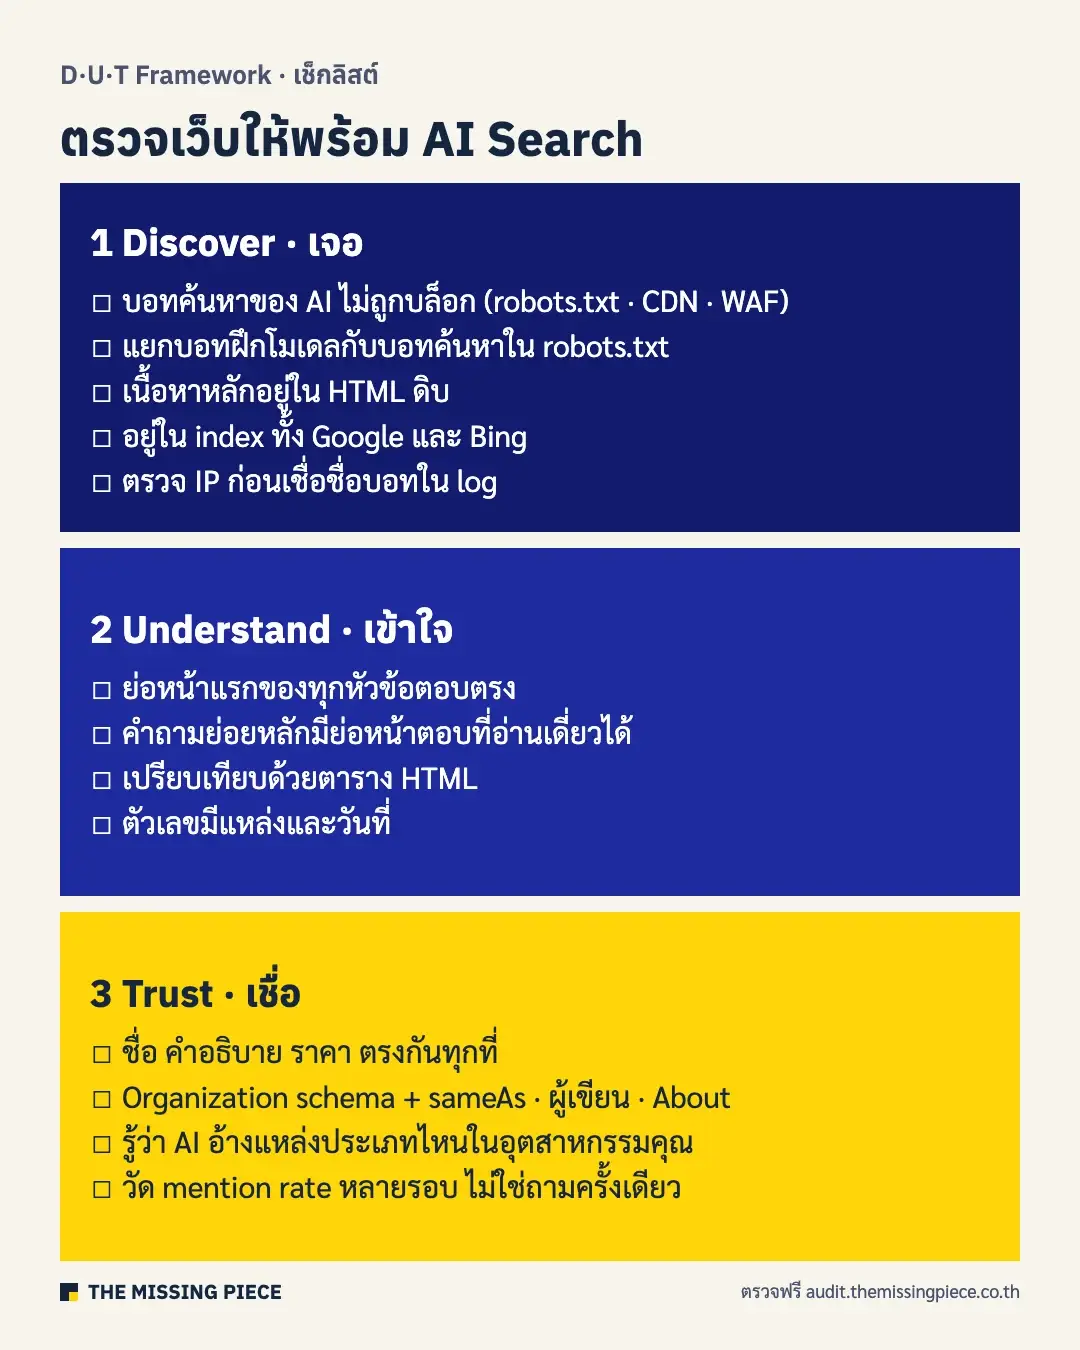
D·U·T Framework คือกรอบตรวจเว็บไซต์ 3 ชั้น ที่เว็บต้องผ่านก่อน AI จะเลือกหยิบไปตอบ: Discover ให้บอทที่ถูกตัวเข้าถึงและอ่านเนื้อหาได้ Understand ให้ย่อหน้าสำคัญถูกดึงไปตอบคำถามย่อยได้ และ Trust ให้ AI แยกออกว่าแบรนด์คุณคือใครและมีแหล่งอื่นยืนยัน
เขียนโดย ไอซ์ ศิริพงษ์ กลิ่นขจร
ผู้ก่อตั้งและ CEO ของ The Missing Piece · ผู้เรียนและผู้ฟังกว่า 2,500 คน
เผยแพร่ 1 ต.ค. 2026 · อัปเดตล่าสุด 2 พ.ย. 2026
หน้านี้เขียนสำหรับคนที่ทำ SEO มาแล้ว เราจึงไม่อธิบาย robots.txt หรือ H1 ซ้ำ แต่เน้น 3 เรื่องที่ SEO แบบเดิมไม่ได้บังคับให้คิด คือบอทของ AI มี 3 ประเภทที่ทำงานต่างกัน การถูกอ้างไม่เท่ากับการติดอันดับ และ AI เลือกแบรนด์จากสิ่งที่คนอื่นพูดถึงมากกว่าที่เว็บพูดเอง ทุกชั้นมีข้อมูลจริงจากเว็บ The Missing Piece (TMP) และ AI Visibility Index ของเรา พร้อมวิธีวัดและลำดับแก้ D·U·T คือ AI-Ready Website ฉบับปรับใหม่ที่ไอซ์ ศิริพงษ์ ใช้สอนในคลาส SEO & AI Search
สรุปสั้น (TL;DR)
D·U·T แยกงานเป็น 3 คำถามที่ AI ถามตามลำดับ: เข้าถึงหน้าได้ไหม ดึงย่อหน้าไปตอบได้ไหม และเชื่อได้ไหมว่าแบรนด์นี้คือใคร- Discover: บล็อก GPTBot ไม่ทำให้หายจาก ChatGPT แต่บล็อก OAI-SearchBot ทำให้หาย ใน log ของ TMP 19 วัน OAI-SearchBot ได้หน้าจริง 532 ครั้ง ส่วน GPTBot 19 ครั้ง และหน้าใหม่ถูก OAI-SearchBot เปิดครั้งแรกภายในราว 5 ชั่วโมง (มัธยฐาน, n = 6)
- Understand: ติด top 10 ช่วยมาก แต่ไม่ใช่ทั้งหมด ในข้อมูลไทยของ TMP 93% ของคำตอบ AI Overviews มีลิงก์จาก top 10 อย่างน้อย 1 ลิงก์ แต่ลิงก์ทั้งหมดที่อ้างอยู่ใน top 10 แค่ 36% (n = 3,022 ลิงก์) ใกล้กับผลของ Ahrefs ที่ 37.9% (มี.ค. 2026)
- Trust: สัดส่วนที่ AI อ้างเว็บแบรนด์เองต่างกันมากตามอุตสาหกรรม ใน AI Visibility Index ของ TMP ธนาคาร 54% แต่โรงแรมแค่ 15% (ยังจัดประเภทไม่ได้ 35% · ต.ค. 2026) ชั้น Trust ของแต่ละธุรกิจจึงลงแรงคนละที่
D·U·T ต่างจาก SEO ที่คุณทำอยู่ตรงไหน
D·U·T ไม่ได้แทน SEO แต่เพิ่มเงื่อนไขที่ SEO เดิมไม่ได้วัด สำหรับ Google เอง คู่มือ AI optimization ของ Google (ก.ค. 2026) บอกตรง ๆ ว่า AEO หรือ GEO คือ SEO สำหรับ Search: AI Overviews และ AI Mode ใช้ระบบจัดอันดับหลักเดิม ไม่ต้องมีไฟล์หรือ markup พิเศษ ส่วนที่ต่างจริงอยู่ที่ระบบนอก Google และขั้น "เลือกอ้าง" ที่เกิดหลังการจัดอันดับ

| ชั้น | AI ถามว่า | จุดที่ SEO เดิมมักไม่เช็ก | วัดด้วยอะไร | เกณฑ์ผ่าน (แนวทางของ TMP) | AI-Ready Check |
|---|---|---|---|---|---|
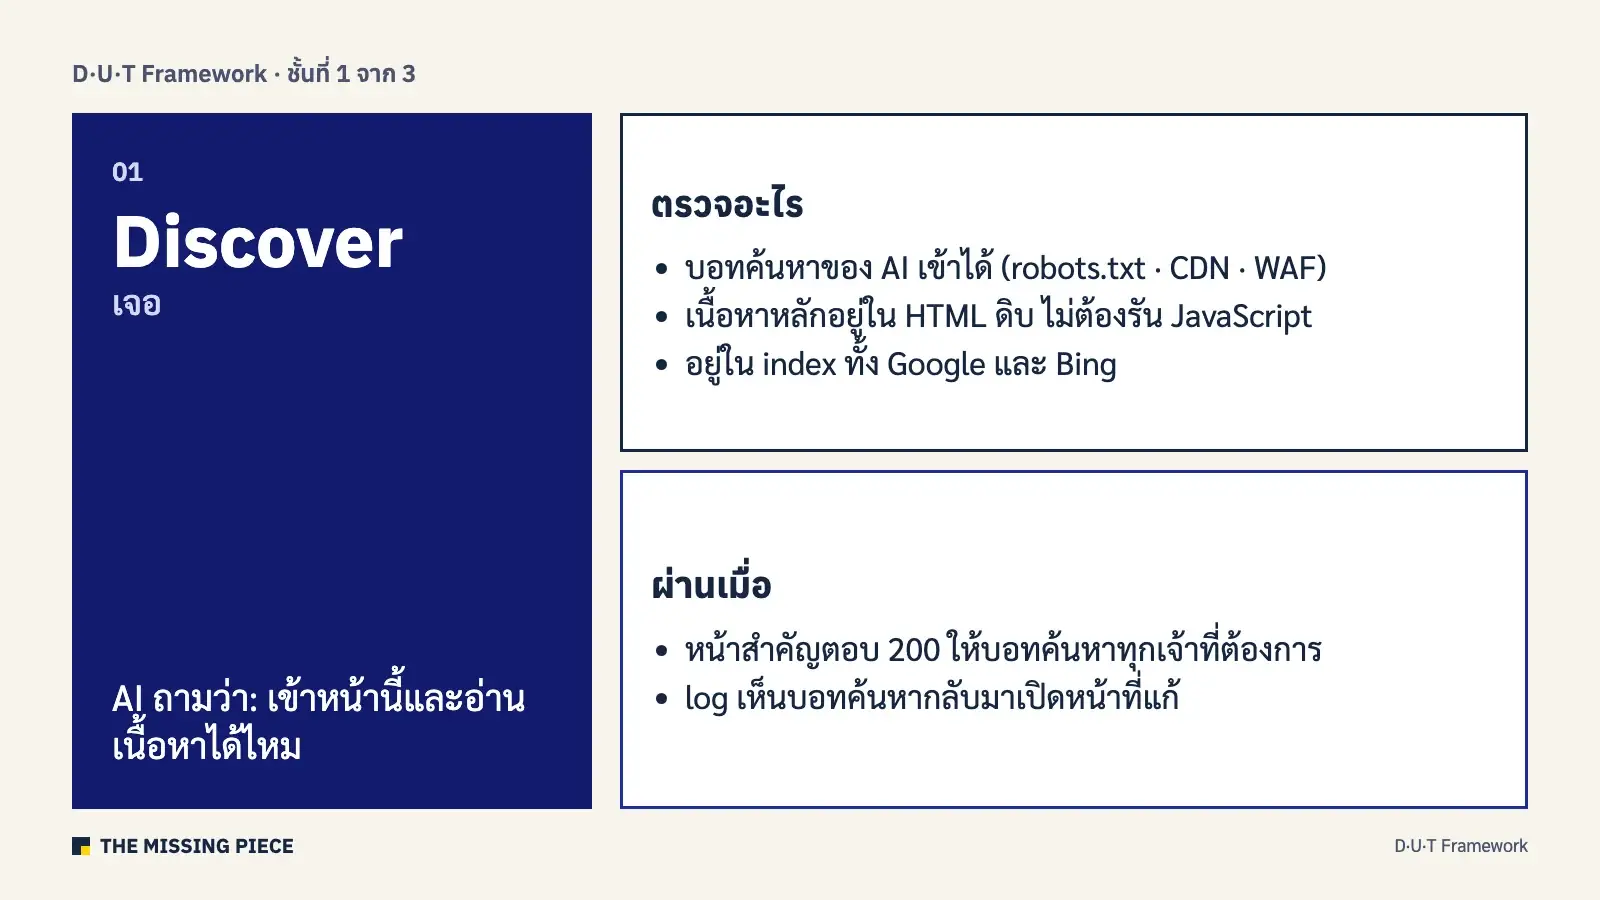
| 1. Discover (เจอ) | เข้าหน้านี้และอ่านเนื้อหาได้ไหม | บอทค้นหาของ AI ถูกบล็อกที่ CDN (เครือข่ายส่งเนื้อหา เช่น Cloudflare) หรือ WAF (ไฟร์วอลล์ระดับเว็บ) · เนื้อหาต้องรัน JavaScript · บอทเก็บ index ของ AI ไม่กลับมาเก็บฉบับใหม่ | server log แยกบอทตาม IP ที่ผู้ให้บริการประกาศ · Search Console · Bing Webmaster Tools | หน้าสำคัญตอบ 200 ให้บอทค้นหาทุกเจ้าที่ต้องการ · เนื้อหาหลักอยู่ใน HTML ดิบ · อยู่ใน index ทั้ง Google และ Bing | G1–G6 (G7 index = เช็กใน Search Console / Bing) |
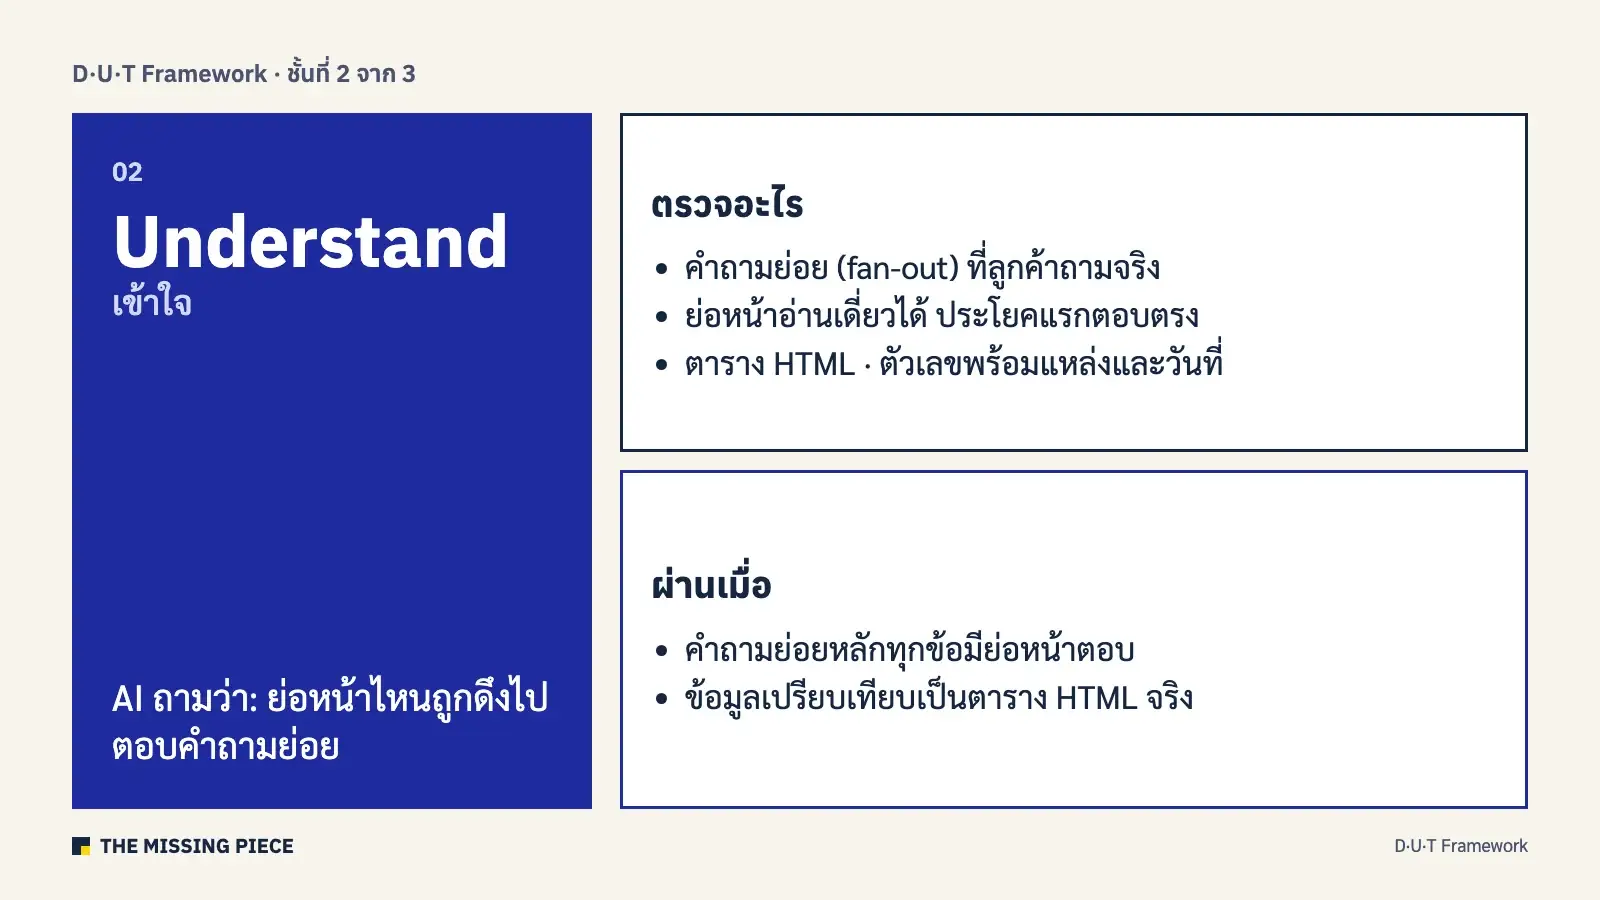
| 2. Understand (เข้าใจ) | ดึงย่อหน้าไหนไปตอบคำถามย่อยได้ | คำถามย่อย (fan-out) ที่มองไม่เห็นในเครื่องมือคีย์เวิร์ด · ย่อหน้าที่ต้องอ่านทั้งหน้าถึงเข้าใจ | Search Console (รายงาน Generative AI = impression อย่างเดียว) · ติดตามคำตอบ AI ด้วยชุดคำถามเดิม | ทุกคำถามย่อยหลักมีย่อหน้าตอบที่อ่านเดี่ยวได้ · ข้อมูลเปรียบเทียบเป็นตาราง HTML (AI SEO For Dummies บทที่ 11–12) | C1–C8 |
| 3. Trust (เชื่อ) | แบรนด์นี้คือใคร และใครยืนยัน | entity ไม่ชัด (ชื่อสะกดหลายแบบ ไม่มี sameAs) · ไม่มีคนอื่นพูดถึงในหน้าที่ AI ใช้ตัดสินใจ | Organization schema + Rich Results Test · mention rate / citation rate จากคำตอบ AI จริง (n รอบ + ช่วงความเชื่อมั่น) | ชื่อ/คำอธิบายแบรนด์ตรงกันทุกที่ · มี mention ในแหล่งประเภทที่ AI อ้างในอุตสาหกรรมคุณ | E1–E5 (ส่วนบนเว็บ) |
ชั้น 1 Discover: บอทที่ถูกตัวเข้าถึงหน้าที่ถูกฉบับไหม
Discover คือชั้นที่ทำให้บอทที่ AI ใช้ตอบคำถามเข้าถึงและอ่านเนื้อหาฉบับล่าสุดได้ สำหรับคนทำ SEO จุดที่เปลี่ยนคือคำว่า "บอทของ AI" ไม่ได้มีตัวเดียว ทุกเจ้าหลักแยกบอทเป็น 3 ประเภทที่ทำงานต่างกัน และการตั้งค่าผิดประเภทคือความผิดพลาดที่เราเห็นบ่อยในชั้นนี้
บอทของ AI มี 3 ประเภท: ฝึกโมเดล · ทำ index ค้นหา · ผู้ใช้สั่ง
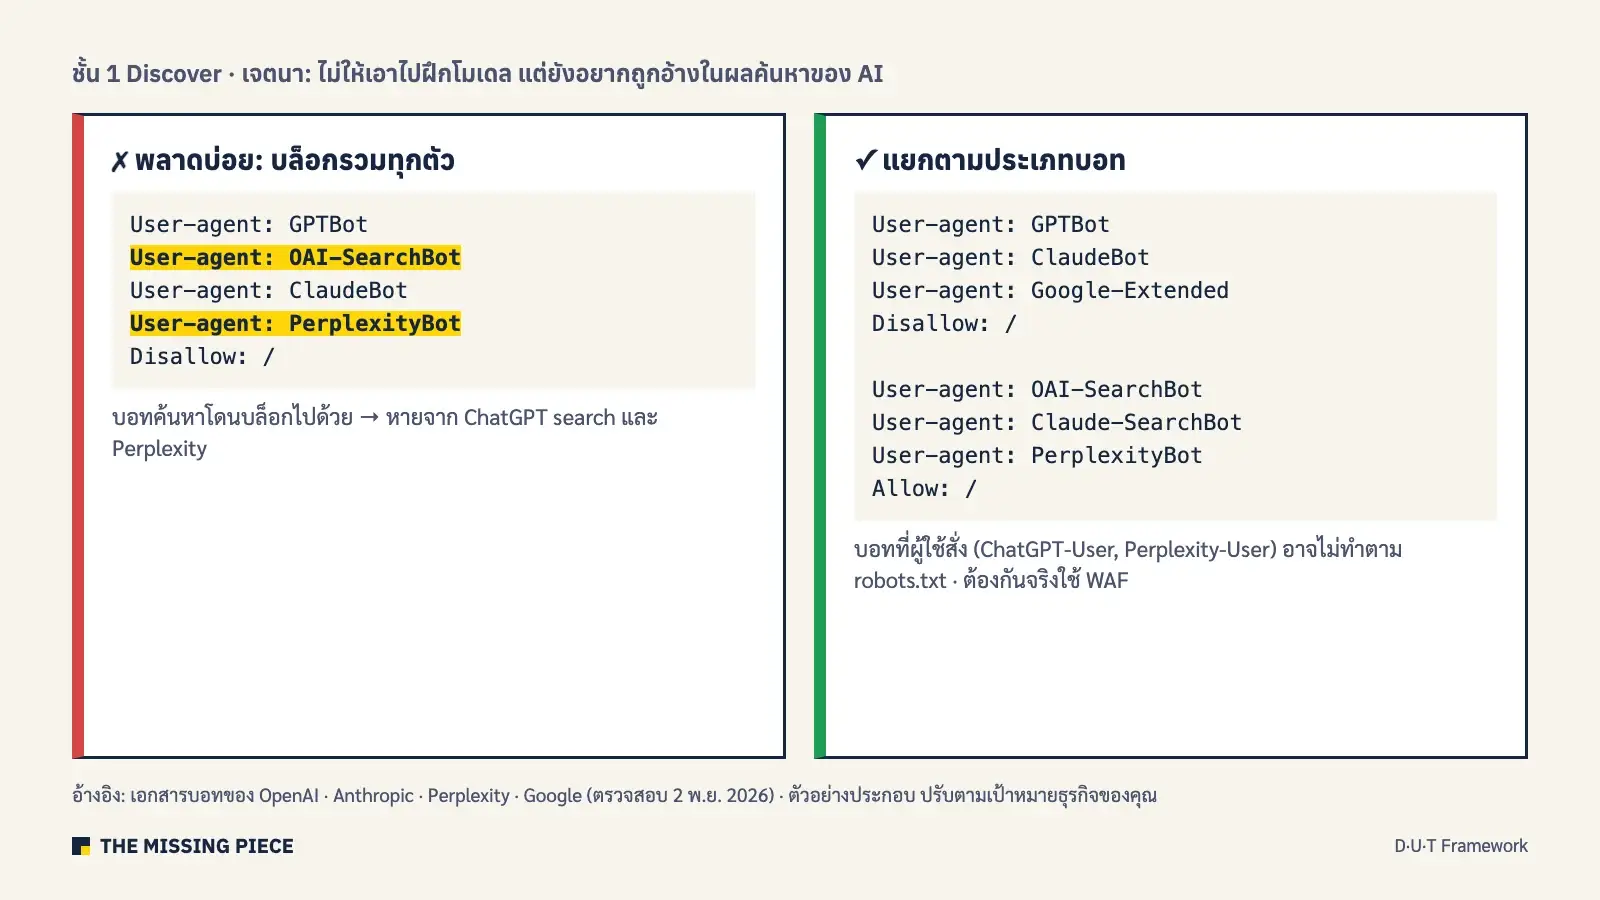
บอทฝึกโมเดล (training) เก็บข้อมูลไปสอนโมเดล บอทค้นหา (search index) เก็บหน้าไว้ให้ระบบค้นหาของ AI ใช้อ้าง และบอทที่ผู้ใช้สั่ง (user-triggered) เปิดหน้าสดตอนผู้ใช้ถาม การบล็อกบอทฝึกโมเดลไม่ทำให้หายจากคำตอบ AI (ยกเว้นบอทที่ใช้ทั้งสองอย่าง เช่น meta-externalagent) แต่การบล็อกบอทค้นหาทำให้หายจากผลค้นหาของเจ้านั้น ส่วนบอทที่ผู้ใช้สั่ง ผู้ให้บริการหลายเจ้าระบุว่า robots.txt อาจไม่มีผล
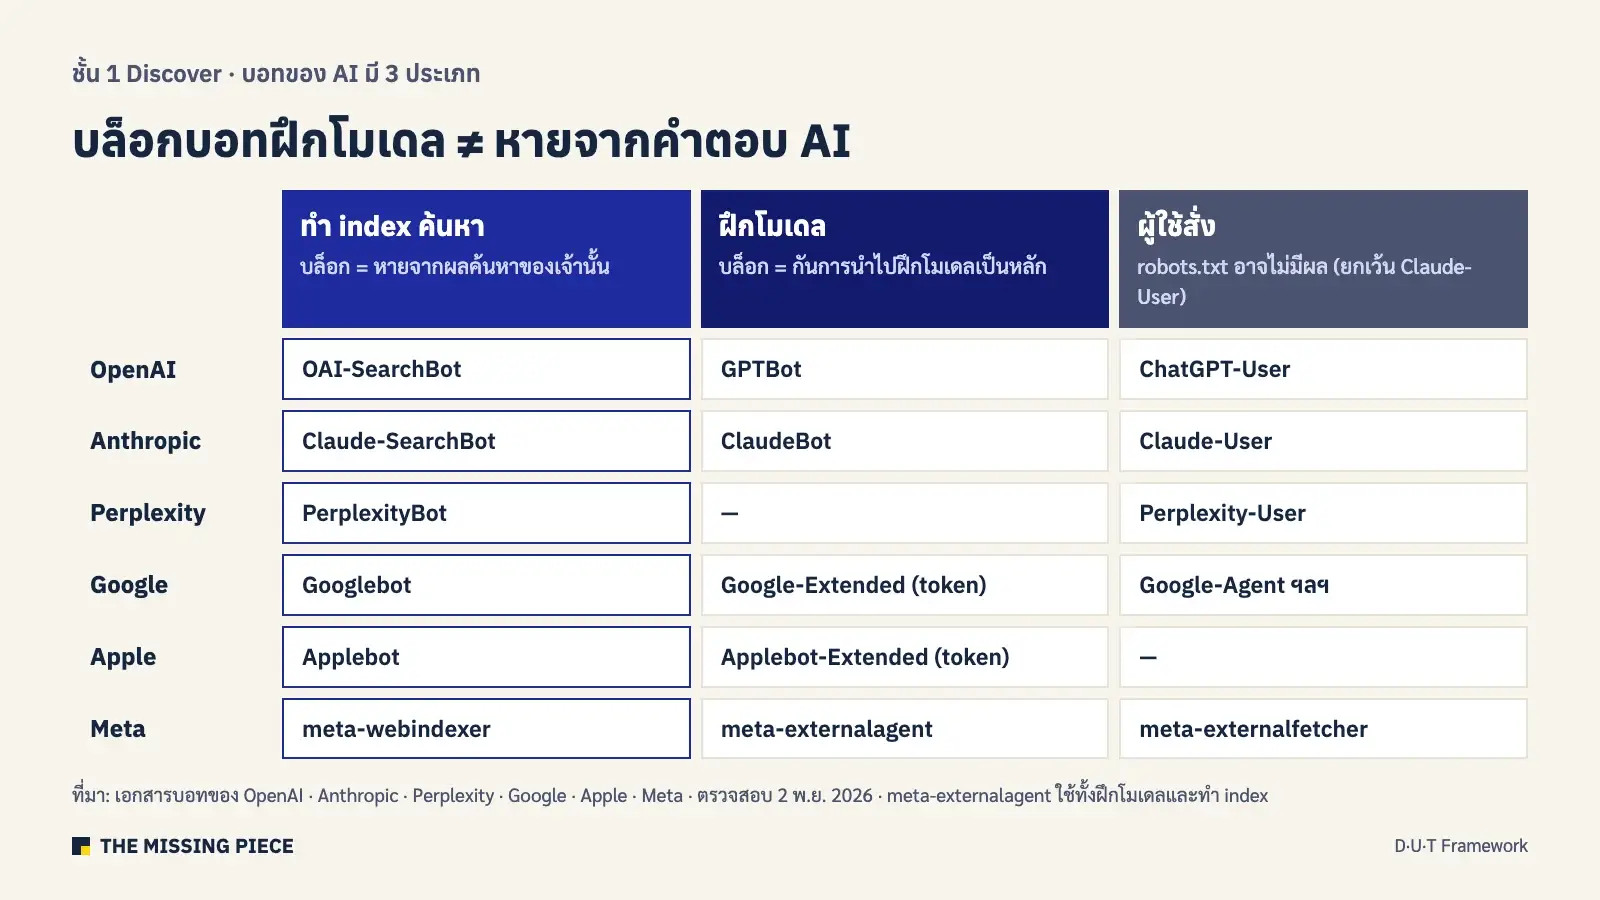
| ผู้ให้บริการ | ฝึกโมเดล | ทำ index ค้นหา | ผู้ใช้สั่ง (robots.txt) |
|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot (บล็อกแล้วไม่ขึ้นใน ChatGPT search · มีผลราว 24 ชม.) | ChatGPT-User — "robots.txt rules may not apply" |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User — ทำตาม robots.txt |
| Perplexity | — (ระบุว่า PerplexityBot ไม่ใช้ฝึกโมเดล) | PerplexityBot | Perplexity-User — โดยทั่วไปไม่ทำตาม robots.txt |
| Google-Extended (เป็นแค่ token ไม่มีบอทของตัวเอง) | Googlebot (ตัวเดียวทั้ง Search, AI Overviews และ AI Mode) | fetcher ที่ผู้ใช้สั่ง เช่น Google-Agent — โดยทั่วไปไม่ทำตาม robots.txt | |
| Apple | Applebot-Extended (token · ไม่ crawl เอง) | Applebot (Siri, Spotlight, Safari) | — |
| Meta | meta-externalagent (ฝึกโมเดลและทำ index) | meta-webindexer | meta-externalfetcher — อาจข้าม robots.txt |
รายละเอียดที่คนทำ SEO มักไม่รู้:
- Google-Extended ไม่คุม AI Overviews: token นี้คุมการนำข้อมูลไปฝึก Gemini และการใช้อ้างอิง (grounding) ใน Gemini Apps และ Vertex AI เท่านั้น ไม่มีผลต่อ Search ถ้าต้องการไม่ให้หน้าไปอยู่ใน AI Overviews และ AI Mode ต้องใช้ nosnippet, data-nosnippet หรือ max-snippet ระดับหน้า หรือตั้งค่า "Search generative AI" ใน Search Console (ค่าเริ่มต้น = รวม · ใช้ได้ทั่วโลกตั้งแต่ 31 ส.ค. 2026 · ไม่คุมการฝึกโมเดล) ซึ่งคู่มือ AI optimization ของ Google ระบุว่าเว็บต้อง "included" ในค่านี้จึงจะมีสิทธิ์แสดงใน AI features การบล็อก Googlebot ทำให้หายจาก Search ทั้งหมด ไม่ใช่แค่ AI
- Bing แยก "ฝึกโมเดล" กับ "grounding" แล้ว (ประกาศ 30 ต.ค. 2026 · มีผล 1 ก.พ. 2027): ตั้ง ai-grounding:disallowextended ระดับหน้าได้ เพื่อให้ Copilot ใช้หน้าได้ แต่บริการ grounding ของบุคคลที่สามใช้ไม่ได้
- token กลาง __usage_ai-training (ร่างมาตรฐาน IETF ยังไม่ final): Bing จะเริ่มอ่านตั้งแต่ 1 ก.พ. 2027 และ Google ระบุว่าตั้งใจจะรองรับต้นปี 2027
- CDN ตั้งค่าแทนคุณได้: Cloudflare บล็อกบอท AI เป็นค่าเริ่มต้นสำหรับโดเมนใหม่ตั้งแต่ 1 ก.ค. 2025 และ ก.ย. 2026 เพิ่มตัวเลือกบล็อกเฉพาะการฝึกโมเดล เว็บที่อยู่หลัง Cloudflare จึงต้องเช็กหน้าตั้งค่าบอท ไม่ใช่ดูแค่ robots.txt
ข้อมูลจริงของ TMP: บอทไหนเข้าเว็บเรา
log บอทของ TMP 19 วัน (14 ต.ค.–2 พ.ย. 2026) นับได้ 1,658 ครั้ง ฝั่ง OpenAI เข้ามากที่สุด และไม่พบบอทของ Perplexity หรือบอท crawl ของ Anthropic เลยในช่วงนี้
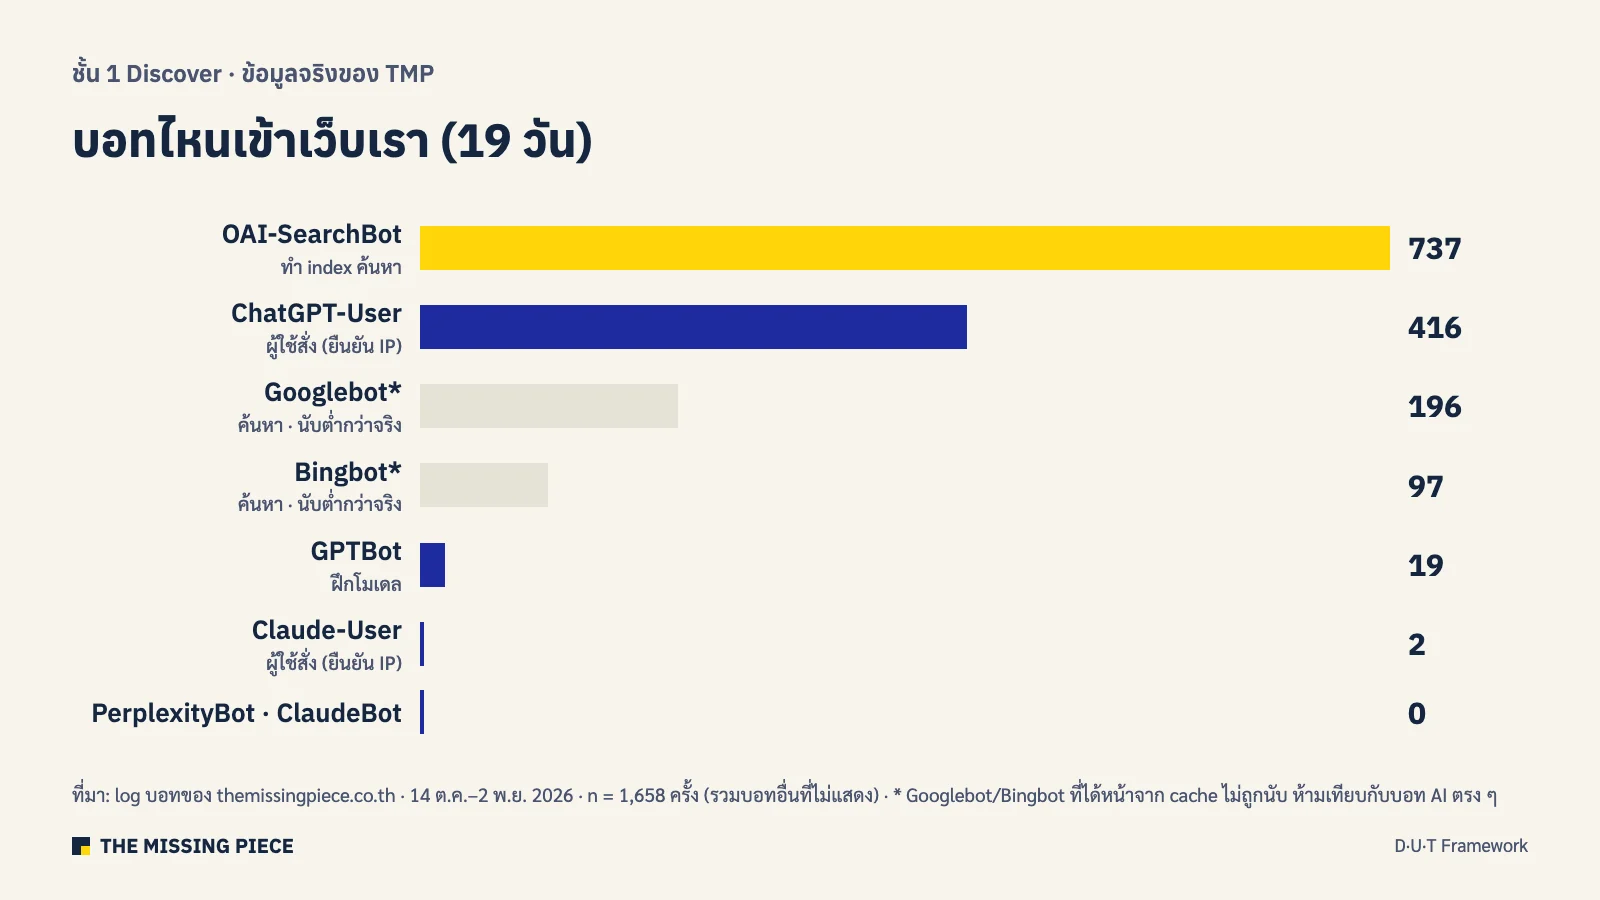
| บอท | ประเภท | ครั้ง | % ของที่นับได้ |
|---|---|---|---|
| OAI-SearchBot | ทำ index ค้นหา | 737 | 44.5% |
| ChatGPT-User (ยืนยัน IP แล้ว) | ผู้ใช้สั่ง | 416 | 25.1% |
| Googlebot | ค้นหา (นับต่ำกว่าจริง) | 196 | 11.8% |
| Bingbot | ค้นหา (นับต่ำกว่าจริง) | 97 | 5.9% |
| GPTBot | ฝึกโมเดล | 19 | 1.1% |
| Claude-User (ยืนยัน IP แล้ว) | ผู้ใช้สั่ง | 2 | 0.1% |
| user-agent อ้างชื่อแต่ตรวจ IP ไม่ผ่าน (ChatGPT-User 13 · GoogleOther 52 · Claude-User 17) | — | 82 | 4.9% |
| อื่น ๆ (meta-externalagent 93 · Amazonbot 14 · Applebot 2) | — | 109 | 6.6% |
| PerplexityBot · Perplexity-User · ClaudeBot · Claude-SearchBot | — | 0 | 0% |
4 เรื่องที่อ่านได้จาก log นี้:
- บอทค้นหาของ OpenAI เปิดหน้ามากกว่าบอทฝึกโมเดลราว 28 เท่า: นับเฉพาะครั้งที่ได้หน้าจริง OAI-SearchBot 532 ครั้ง ส่วน GPTBot 19 ครั้ง คนที่บล็อก GPTBot แล้วคิดว่าตัดตัวเองออกจาก ChatGPT จึงเข้าใจกลับด้าน
- ChatGPT-User 416 ครั้ง (ยืนยัน IP แล้ว) คือสัญญาณการถูกใช้ตอบจริง ไม่ใช่การเก็บ index เกิดจากการใช้งานผ่าน ChatGPT (รวม GPTs และ agent) ที่ระบบเปิดหน้าเราขณะตอบ ตัวเลขนี้จึงใกล้กับ "ความต้องการ" มากกว่ายอด crawl
- บอทค้นหาของ AI เปิดทั้งหน้าใหม่และ URL เดิมที่ถูกย้ายแล้ว จึงควรเช็กว่าลิงก์ภายในและ sitemap ไม่พาบอทผ่าน redirect และปลายทาง redirect ชี้ตรงในทอดเดียว
- มี user-agent ที่อ้างว่าเป็น ChatGPT-User, GoogleOther และ Claude-User แต่ IP ไม่ตรงกับรายการที่ผู้ให้บริการประกาศ อย่าเชื่อชื่อใน log จนกว่าจะตรวจกับไฟล์รายการ IP (OpenAI, Google, Anthropic, Perplexity และ Apple ประกาศเป็น JSON)
หน้าใหม่ถูกเจอเร็ว แต่หน้าเดิมที่แก้ไม่ถูกเก็บใหม่ (การทดลองของ TMP ที่ยังดำเนินอยู่)
การค้นพบหน้าใหม่กับการเก็บฉบับใหม่ของหน้าเดิมเป็นคนละปัญหากัน ใน log ของ TMP หน้าใหม่ถูก OAI-SearchBot เปิดครั้งแรกหลัง publish มัธยฐาน 4.9 ชั่วโมง (n = 6 หน้า ช่วง 0.4–44 ชั่วโมง) และ 11 จาก 11 หน้าที่ออกช่วงเดียวกันถูกเปิดภายใน 2 วัน แต่ในการทดลองกับหน้าเดิมที่แก้เนื้อหา หลังส่ง IndexNow ไป 7 วัน (24–31 ต.ค. 2026) Bing ยังแสดงฉบับเดิม OAI-SearchBot ไม่กลับมาเปิดหน้านั้นเลย และ ChatGPT ค้นเว็บแทบไม่อ้างหน้านั้น (0–1 จาก 240 คำตอบต่อวัน) ทั้งที่ ChatGPT-User เปิดหน้าสดได้ปกติ
ข้อจำกัด: หน้าใหม่ n = 6 · เว็บอายุราว 1 เดือน · "เปิด" ไม่เท่ากับ "อ้าง" · การทดลองยังดำเนินอยู่: รอบถัดไป (เพิ่มลิงก์ภายในเข้าหน้า + ส่ง IndexNow ซ้ำ) วัดผล 5 และ 8 พ.ย. 2026 และจะอัปเดตผลหลัง 8 พ.ย.
สิ่งที่ใช้ได้ทันที: อย่าคิดว่า IndexNow แก้ทุกอย่าง IndexNow ส่งถึง Bing, Yandex, Naver, Seznam, Yep และ Amazon แต่ไม่ถึง Google หน้าเดิมที่แก้ข้อมูลสำคัญ (ราคา วันที่ เงื่อนไข) ควรได้ลิงก์ภายในใหม่จากหน้าที่บอทเข้าบ่อย และตามดูใน log ว่าบอทค้นหากลับมาเปิดจริงไหม
JavaScript: ข้อกำหนด ไม่ใช่เรื่องเสริม
บอทของ AI ส่วนใหญ่ไม่รัน JavaScript งานศึกษาของ Vercel และ MERJ (ธ.ค. 2024) บนเครือข่าย Vercel พบว่าบอทของ OpenAI และ Anthropic ดาวน์โหลดไฟล์ JavaScript แต่ไม่รัน ยกเว้น Gemini ที่ใช้โครงสร้างของ Googlebot และ AppleBot และบอทของ ChatGPT กับ Claude เจอหน้า 404 ราว 34% เทียบกับ Googlebot 8% สำหรับระบบนอก Google การ render ฝั่ง server (SSR หรือหน้า static) จึงเป็นเงื่อนไขขั้นต่ำ (AI SEO For Dummies บทที่ 10 แนะนำให้เทียบหน้า HTML ดิบกับหน้าที่ render แล้วในการตรวจ · The Art of SEO บทที่ 7 วาง rendering และ redirect เป็นงานพื้นฐานของเว็บที่ค้นหาได้ ส่วนบทที่ 4 ให้ใช้ server log เป็นแหล่งข้อมูลหลัก)
บอทเข้าเยอะไม่ได้แปลว่าได้ traffic
Cloudflare วัดอัตราการ crawl ต่อการส่งคนกลับมาเว็บ (ม.ค. → ก.ค. 2025): Anthropic 38,066 ครั้งต่อ 1 visit · OpenAI 1,091 · Perplexity 195 · Google 5.4 ตัวเลขนี้ไม่ได้บอกให้บล็อก แต่บอกว่าการวัดผลชั้น Discover ต้องดูการถูกอ้าง ไม่ใช่ยอด crawl (ข้อจำกัด: แอปมือถือมักไม่ส่ง referrer จึงทำให้ referral ของบางเจ้าต่ำกว่าจริง)
ความผิดพลาดที่คนมีประสบการณ์ก็ยังพลาดในชั้น Discover
- บล็อก GPTBot แล้วเข้าใจว่าออกจาก ChatGPT search หรือบล็อก OAI-SearchBot ไปพร้อมกันโดยไม่ตั้งใจ ด้วยกฎ wildcard
- เลือกบล็อกแบบเต็มที่ CDN แทนตัวเลือกบล็อกเฉพาะการฝึกโมเดล ซึ่งเสี่ยงกันบอทที่ใช้ทั้งค้นหาและ AI อย่าง Googlebot ไปด้วย
- เชื่อ user-agent ใน log โดยไม่ตรวจ IP
- ใช้ robots.txt กันบอทที่ผู้ใช้สั่ง ซึ่งหลายเจ้าไม่ทำตาม ถ้าต้องกันจริงต้องใช้ WAF
- คิดว่า IndexNow ไปถึง Google หรือคิดว่าส่งแล้วบอทของ AI จะกลับมาเก็บฉบับใหม่ทันที
- ปล่อย 404 และ redirect ทอดยาว ซึ่งงานของ Vercel และ MERJ (ธ.ค. 2024) พบว่าบอทของ ChatGPT ใช้การเปิดหน้าไปกับ redirect 14% เทียบกับ Googlebot 1.5%
- property ลูกใน Search Console รับค่า exclude ของ "Search generative AI" มาจาก property แม่โดยไม่รู้ตัว
ลำดับแก้ตามผลกระทบ: (1) บอทค้นหาที่ถูกบล็อกที่ CDN/WAF หรือ robots.txt → (2) เนื้อหาหลักที่ต้องรัน JavaScript → (3) index ใน Bing (สำหรับ Copilot และระบบที่ใช้ Bing) → (4) redirect และ 404 ที่บอทเจอใน log → (5) sitemap และลิงก์ภายในเข้าหน้าที่แก้ข้อมูลสำคัญ
ชั้น 2 Understand: ย่อหน้าไหนของคุณถูกดึงไปตอบคำถามย่อย
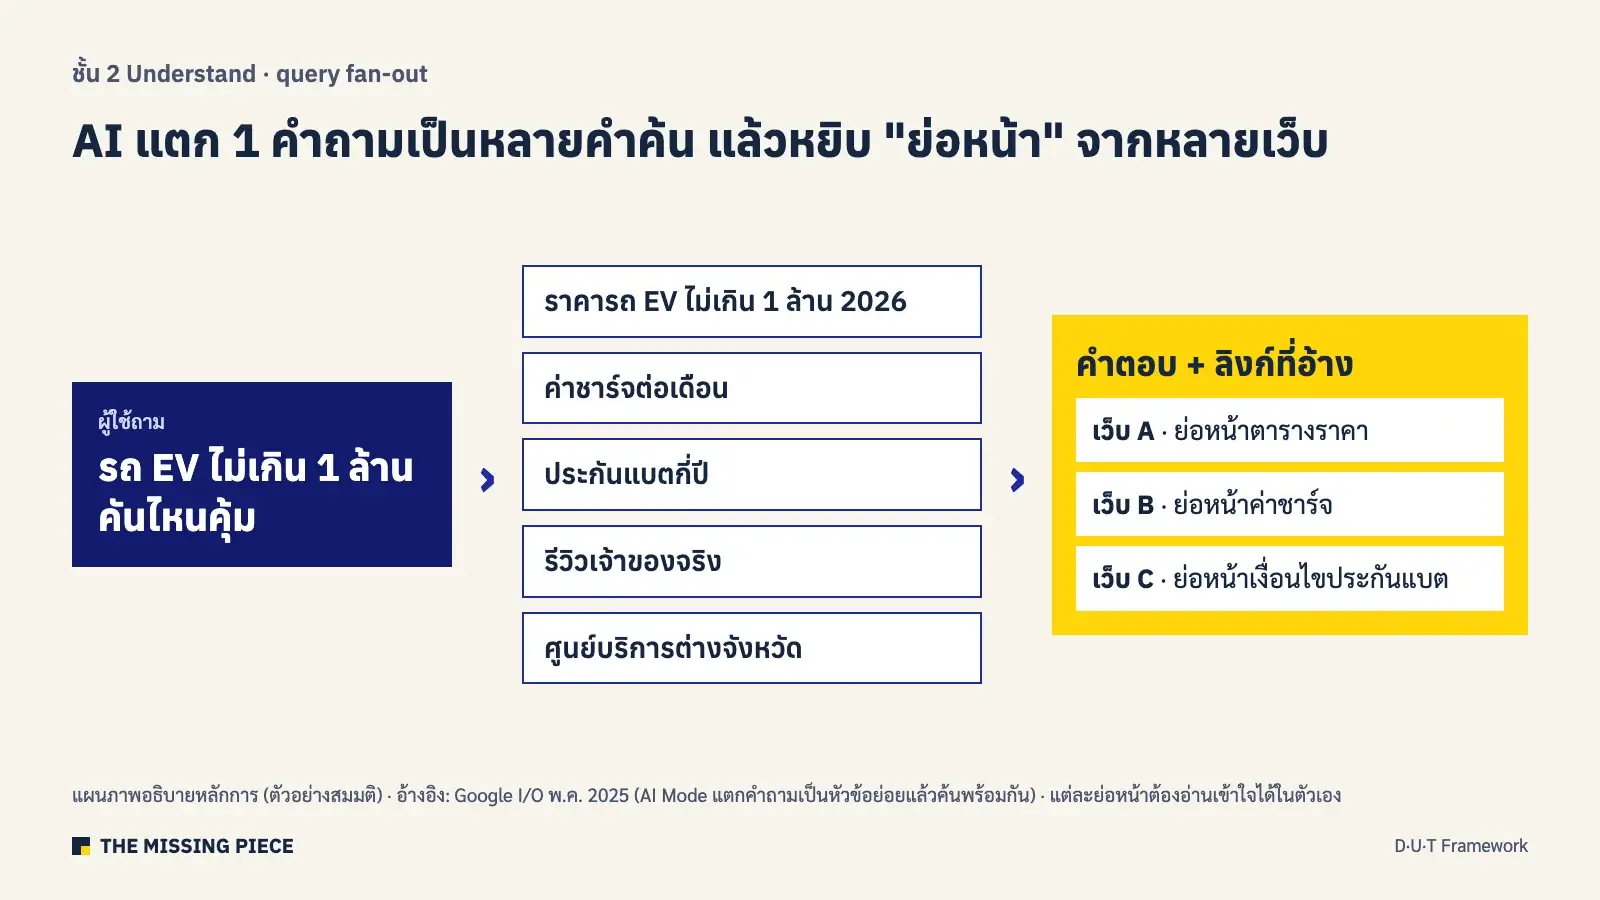
Understand คือชั้นที่ทำให้ระบบ AI ดึงย่อหน้าของคุณไปตอบได้ สิ่งที่เปลี่ยนจาก SEO เดิมคือหน่วยที่แข่งกันไม่ใช่ทั้งหน้ากับคีย์เวิร์ดหลัก แต่เป็นย่อหน้ากับคำถามย่อยจำนวนมากที่ AI แตกออกจากคำถามเดียว ซึ่งเครื่องมือคีย์เวิร์ดส่วนใหญ่มองไม่เห็น
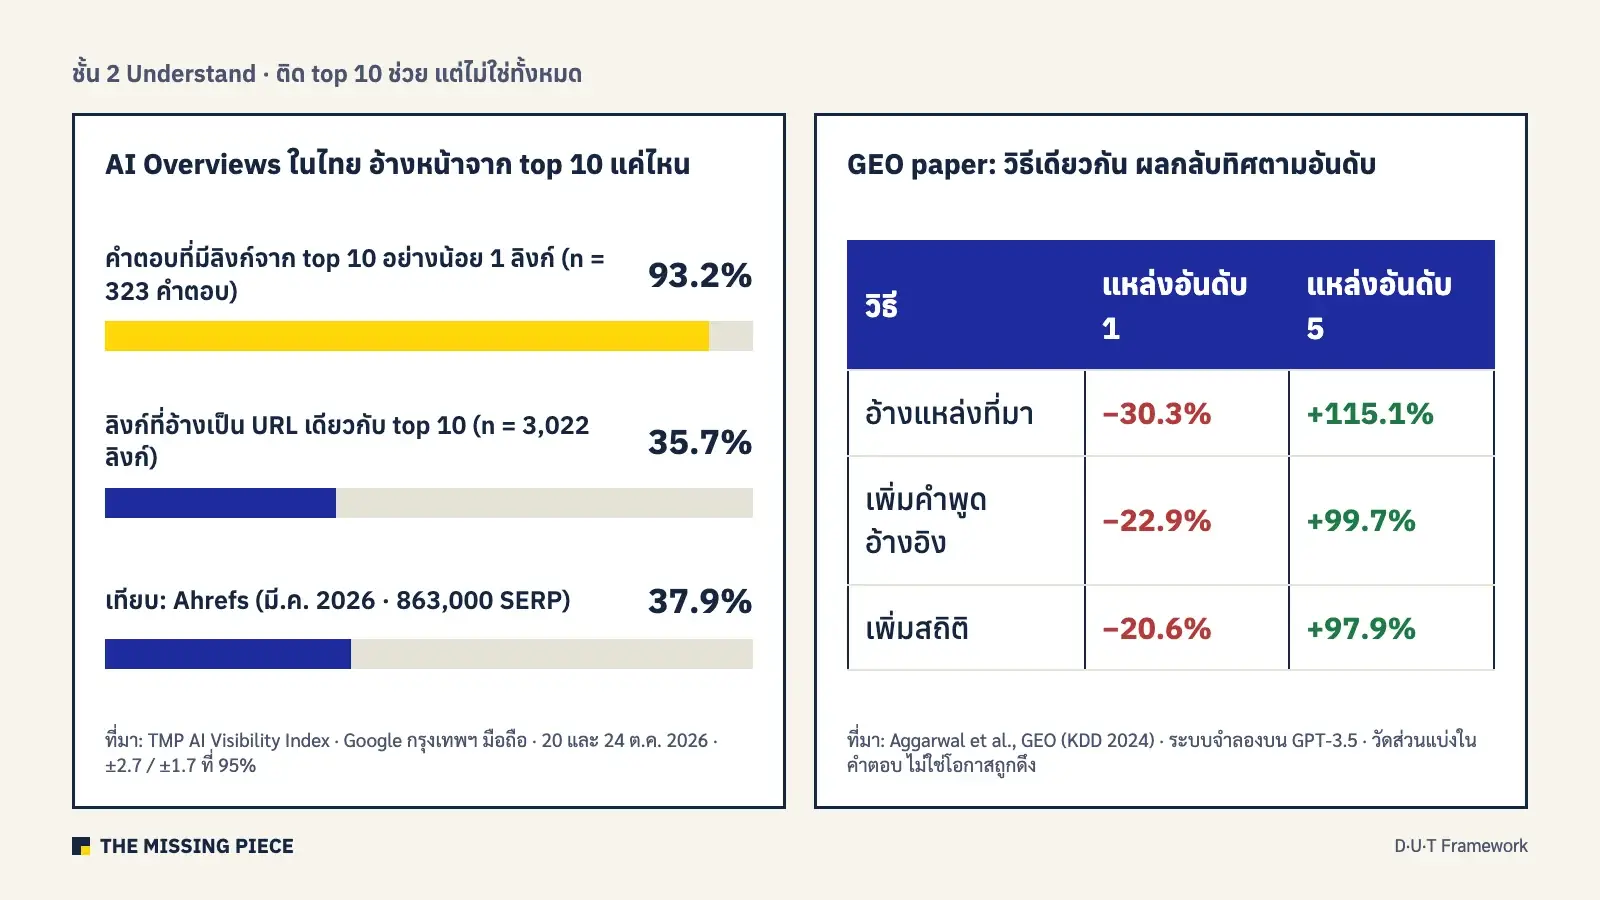
ติด top 10 ช่วย แต่ AI อ้างหน้านอก top 10 เกินครึ่ง
AI Overviews ยังพึ่งการจัดอันดับ แต่ไม่ใช่อันดับของคำค้นหลักอย่างเดียว ข้อมูลไทยของ TMP กับงานวิจัยต่างประเทศชี้ไปทางเดียวกัน
| แหล่ง | ข้อมูล | ผล |
|---|---|---|
| TMP AI Visibility Index (ไทย · Google กรุงเทพฯ มือถือ · 20 และ 24 ต.ค. 2026) | 323 คำตอบ AI Overviews · 3,022 ลิงก์ | 93.2% (±2.7) ของคำตอบมีลิงก์จาก top 10 อย่างน้อย 1 ลิงก์ · แต่ลิงก์ที่เป็น URL เดียวกับ top 10 แค่ 35.7% (±1.7) · โดเมนเดียวกับ top 10 50.7% |
| Ahrefs (2 มี.ค. 2026) | 863,000 SERP · ~4 ล้าน URL ที่ AIO อ้าง | 37.9% ของลิงก์ที่ AIO อ้างติด top 10 · 31% อยู่นอก top 100 · ลดจากราว 76% ใน ก.ค. 2025 |
| TMP AI Citation #1 (2 ต.ค. 2026 · หัวข้อ AI Search 20 คำถาม · ผลเบื้องต้น) | 163 หน้า organic | หน้าอันดับ 1–3 ถูก AIO อ้าง 63% เทียบอันดับ 4–10 46% (p = 0.035) |
อ่านอย่างไร: อันดับยังสำคัญ แต่อันดับที่นับคืออันดับของคำถามย่อยที่ AI แตกออกมา (query fan-out) ซึ่งคุณไม่เห็น Google ยืนยันว่า AI Mode แตกคำถามเป็นหัวข้อย่อยแล้วค้นพร้อมกัน และ Deep Search ค้นได้หลายร้อยครั้ง (Google I/O, พ.ค. 2025) อ่านกลไกเต็มได้ที่ Query Fan-Out คืออะไร
ข้อจำกัด: แต่ละงานใช้ตัวหารและวิธี parse ต่างกัน · ข้อมูลต่างประเทศส่วนใหญ่เป็นภาษาอังกฤษ · ข้อมูล TMP 1 รอบต่ออุตสาหกรรม
Google บอกอะไรเรื่อง "เขียนให้ AI" และไม่ได้บอกอะไร
Google ระบุ (คู่มือ AI optimization, ก.ค. 2026) ว่าไม่ต้องแบ่งเนื้อหาเป็นชิ้น (chunking) ไม่มีความยาวที่เหมาะที่สุด ไม่ใช้ llms.txt หรือ markup พิเศษ และการสร้างหน้าแยกสำหรับคำถามย่อยแต่ละแบบอาจเข้าข่าย scaled content abuse Google มีระบบ passage ranking ที่ระบุส่วนของหน้าได้อย่างเป็นทางการ แต่ไม่ได้บอกว่าระบบนี้เชื่อมกับ AI Overviews สำหรับระบบนอก Google ยังไม่มีงานวิจัยแบบควบคุมที่น่าเชื่อถือเรื่อง chunking การเขียนย่อหน้าให้อ่านเดี่ยวได้จึงเป็นหลักการเขียนที่ดี ไม่ใช่สูตรที่พิสูจน์แล้ว
งานวิจัย GEO: ได้ผลกับผู้ท้าชิง แต่อาจทำร้ายเบอร์ 1
งานวิจัย GEO (Aggarwal และคณะ, KDD 2024) ทดสอบการปรับเนื้อหา 9 แบบกับระบบตอบคำถามจำลองบน GPT-3.5 พบว่าการเพิ่มคำพูดอ้างอิง (quotation) เพิ่มสถิติ และอ้างแหล่งที่มา ทำให้เนื้อหาได้พื้นที่ในคำตอบมากขึ้นราว 30–40% ส่วนการยัดคีย์เวิร์ดได้ผลแย่กว่าไม่ทำอะไรเลย รายละเอียดที่คนมักไม่พูดถึงคือผลขึ้นกับอันดับของแหล่ง
| วิธี | แหล่งอันดับ 1 | แหล่งอันดับ 5 |
|---|---|---|
| อ้างแหล่งที่มา (Cite Sources) | −30.3% | +115.1% |
| เพิ่มคำพูดอ้างอิง (Quotation) | −22.9% | +99.7% |
| เพิ่มสถิติ (Statistics) | −20.6% | +97.9% |
ข้อจำกัด: ระบบจำลองบนโมเดลปี 2023–24 · ปรับเนื้อหาหลังขั้นดึงข้อมูลแล้ว จึงวัด "ส่วนแบ่งในคำตอบ" ไม่ใช่ "โอกาสถูกดึง" · ไม่ได้วัดผลต่ออันดับ · ใช้ GPT ตัดสินคะแนน
ใช้อย่างไร: ถ้าหน้าคุณยังไม่ใช่แหล่งหลักของคำถามนั้น ตัวเลขที่มีแหล่งและคำพูดอ้างอิงคือคันโยกที่มีหลักฐาน ถ้าเป็นแหล่งหลักอยู่แล้ว ให้วัดก่อนและหลังแก้ ไม่ใช่ใส่ตามสูตร
ข้อมูลจริงของ TMP: ลักษณะของหน้าที่ถูกอ้าง
งานวิจัย AI Citation #1 ของ TMP (2–3 ต.ค. 2026 · คำถามเรื่อง AI Search ภาษาไทย 20 ข้อ · หน้าที่ถูกอ้าง n = 224) พบลักษณะเดียวที่ต่างอย่างมีนัยสำคัญ คือตาราง HTML: ในหน้าที่ Perplexity อ้างแบบแทรกในเนื้อคำตอบ 52% มีตาราง เทียบกับ 30% ของหน้าที่อยู่แค่ในรายการแหล่งท้ายคำตอบ (n = 91 กับ 73 หน้า, p = 0.007) ลักษณะอื่นที่พบในหน้าที่ถูกอ้างส่วนใหญ่ เช่น มีรายการ (95%) มีวันที่ (85%) มีชื่อผู้เขียน (68%) และ H2 แบบคำถาม (67%) เป็นพื้นฐานที่แทบทุกหน้ามี ไม่ใช่ตัวที่ทำให้ชนะ ส่วน FAQPage schema (22%) ไม่ต่างกัน
ข้อจำกัด: หัวข้อเดียว · 1 รอบ · ตรวจลักษณะด้วยโปรแกรม · ไม่มีกลุ่มเทียบหน้าที่ไม่ถูกอ้างทั่วไป · ทดสอบ 22 ลักษณะโดยไม่ปรับค่าการเทียบหลายครั้ง → ใช้เป็นข้อสังเกตเบื้องต้น
วัดชั้น Understand อย่างไร
- Search Console รายงาน Generative AI (มิ.ย. 2026): มีแค่ impression ไม่มีคลิก CTR หรืออันดับ และนับหลายลิงก์จากเว็บเดียวในคำตอบเดียวเป็น 1 impression
- ติดตามคำตอบ AI ด้วยชุดคำถามเดิม: แยกคำถามที่มีและไม่มีชื่อแบรนด์ (AI SEO For Dummies บทที่ 5) และดูว่าหน้าไหนถูกอ้าง ไม่ใช่แค่ว่าแบรนด์ถูกเอ่ยไหม วิธีเลือกคำถามอยู่ใน วิธีเลือกและติดตาม prompt
ความผิดพลาดที่คนมีประสบการณ์ก็ยังพลาดในชั้น Understand
- วัดแค่อันดับของคำค้นหลัก แล้วสรุปว่าหน้าพร้อมสำหรับ AI
- สร้างหน้าแยกให้คำถามย่อยทุกแบบ ซึ่ง Google ระบุว่าอาจเป็น scaled content abuse
- ใส่ FAQPage schema เพื่อหวังผลกับ AI ทั้งที่ Google เลิกแสดง FAQ rich result แล้ว และข้อมูล TMP ไม่พบความต่าง
- ใส่สถิติและแหล่งอ้างอิงตามสูตร GEO ในหน้าที่เป็นแหล่งหลักอยู่แล้ว โดยไม่วัดก่อนและหลัง
- ซ่อนคำตอบสำคัญไว้ในรูป แท็บ หรือส่วนที่ต้องคลิก
ลำดับแก้ตามผลกระทบ: (1) หน้าสำคัญที่ยังไม่ตอบคำถามที่ลูกค้าถามจริง (ราคา เงื่อนไข ขั้นตอน) → (2) ข้อมูลเปรียบเทียบที่ยังไม่เป็นตาราง HTML → (3) ย่อหน้าที่ต้องอ่านทั้งหน้าถึงเข้าใจ → (4) ตัวเลขที่ไม่มีแหล่งและวันที่
ชั้น 3 Trust: AI รู้ไหมว่าคุณคือใคร และใครยืนยัน
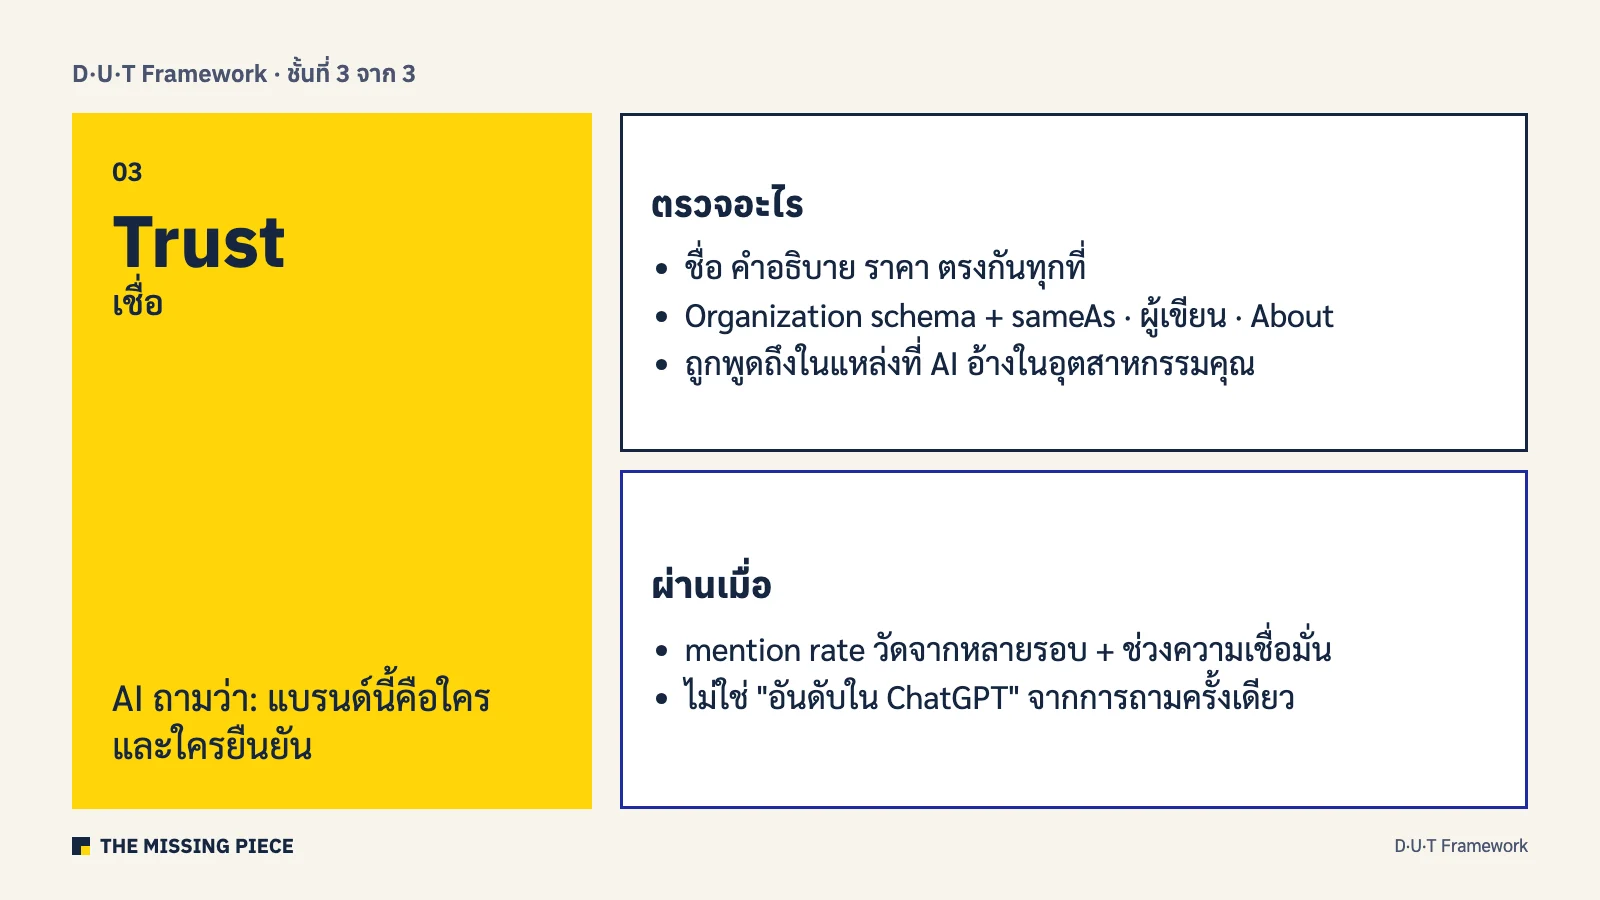
Trust คือชั้นที่ทำให้ AI แยกแบรนด์คุณออกจากชื่ออื่นได้ และมีแหล่งภายนอกยืนยันสิ่งที่เว็บบอก ชั้นนี้มี 2 ส่วน คือ entity บนเว็บที่คุณคุมเองได้ และการถูกพูดถึงนอกเว็บ ซึ่งงานของ Ahrefs พบว่าสัมพันธ์กับการถูกเอ่ยชื่อมากกว่า backlink
Entity บนเว็บ: ทำเพื่อแยกตัวตน ไม่ใช่คันโยกของ AI
Organization schema ช่วยให้ Google ระบุและแยกแยะองค์กร และมีผลต่อโลโก้และ knowledge panel Google ระบุว่าไม่มี property บังคับ แต่แนะนำ name, alternateName, legalName, url, logo, sameAs, address และ contactPoint โดย sameAs คือ URL ของหน้าที่ยืนยันตัวตนเดียวกัน เช่น โปรไฟล์ทางการ ในขณะเดียวกัน Google บอกว่า structured data ไม่จำเป็นสำหรับ AI features และการเน้น schema มากเกินไปเป็นความเชื่อผิด ไม่มีเอกสารทางการบอกว่า schema ถูกใช้เลือกแหล่งใน AI Overviews จึงควรมองเป็นงานสุขอนามัยของ entity: ชื่อเดียว คำอธิบายเดียว ลิงก์ไปโปรไฟล์ที่ถูกต้อง (AI SEO For Dummies บทที่ 13 และ 16–17 แนะนำให้ใช้ข้อเท็จจริงแบรนด์ชุดเดียวกันทุกที่)
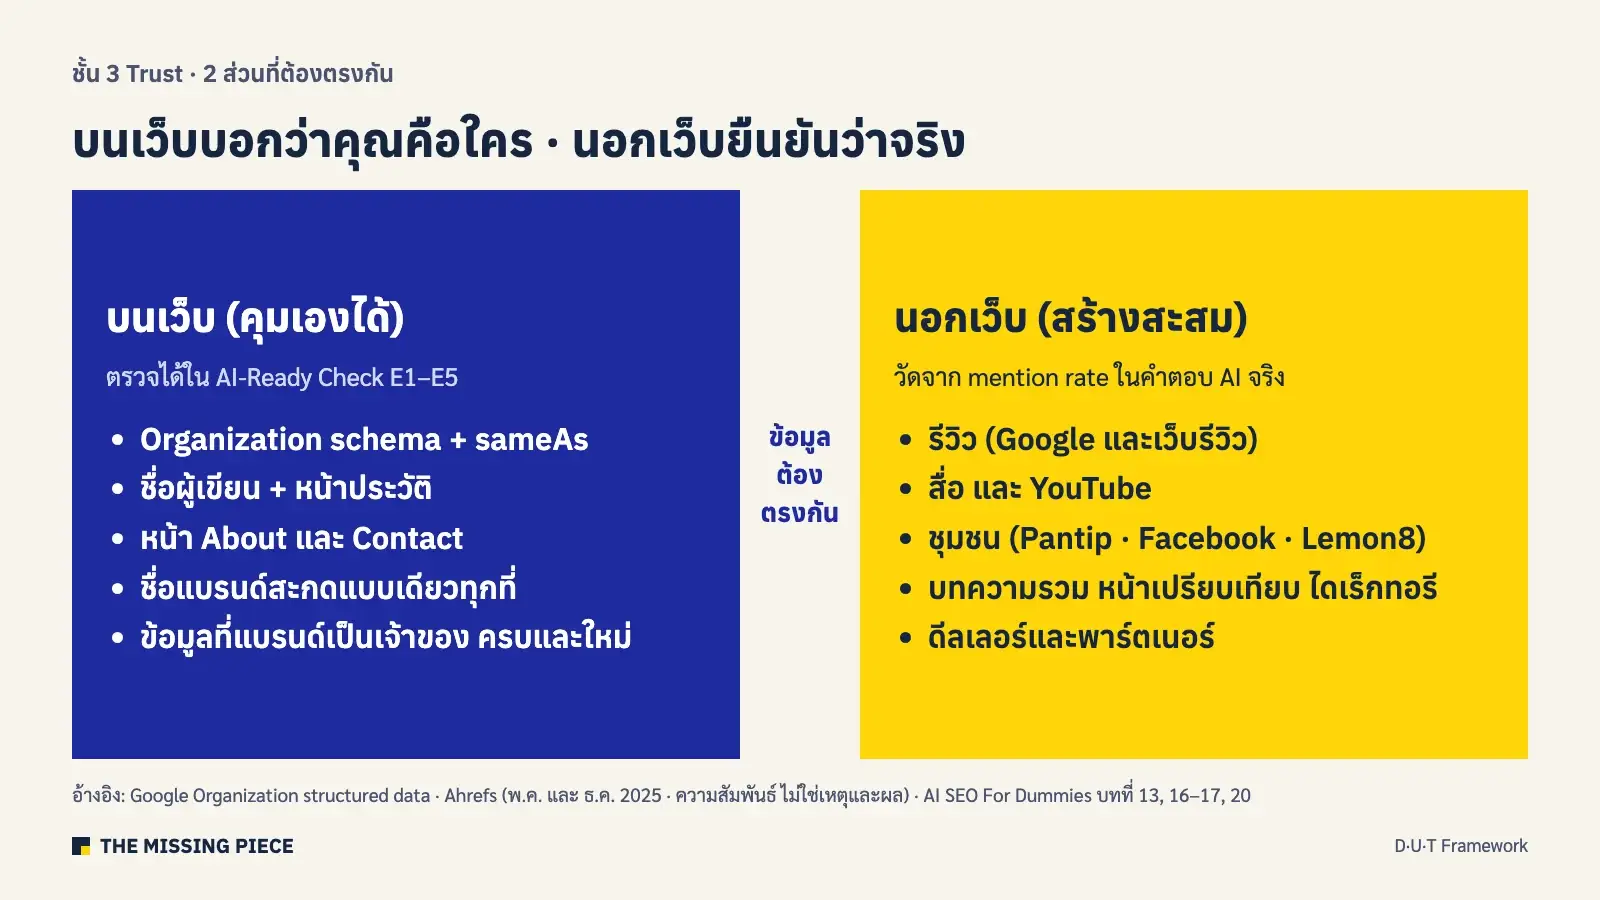
การถูกพูดถึงนอกเว็บ: สัมพันธ์แรงที่สุด แต่เป็น correlation
งานศึกษาของ Ahrefs กับ 75,000 แบรนด์ (พ.ค. 2025) พบว่าการถูกพูดถึงบนเว็บอื่น (branded web mentions) สัมพันธ์กับการถูกเอ่ยชื่อใน AI Overviews ที่ 0.664 ส่วน backlink 0.218 งานต่อเนื่อง (ธ.ค. 2025) พบว่าการถูกพูดถึงบน YouTube สัมพันธ์สูงที่สุดราว 0.737 และ AI Mode เป็นแพลตฟอร์มที่ขึ้นกับแบรนด์มากที่สุด งานวิจัยของมหาวิทยาลัยโทรอนโต (arXiv 2509.08919, ก.ย. 2025) พบว่าระบบ AI อ้างสื่อของบุคคลที่สาม (earned media) 69–92% ตามหมวด และ GPT เปลี่ยนชุดโดเมนที่อ้างแทบทั้งหมดเมื่อเปลี่ยนภาษา ข้อหลังนี้ชี้ว่า (เป็นการอนุมานของเรา งานนี้ไม่ได้ทดสอบภาษาไทย) ชื่อเสียงในสื่อภาษาอังกฤษอาจไม่ย้ายมาที่คำตอบภาษาไทยเอง
ข้อจำกัด: ทั้งหมดเป็นความสัมพันธ์ ไม่ใช่เหตุและผล · ตัวอย่างเป็นแบรนด์ใหญ่ · ขนาดแบรนด์มีผลกับทุกตัวแปร · งานโทรอนโตใช้ตลาดสหรัฐฯ และแคนาดา
ข้อมูลจริงของ TMP: AI อ้างเว็บประเภทไหนในไทย
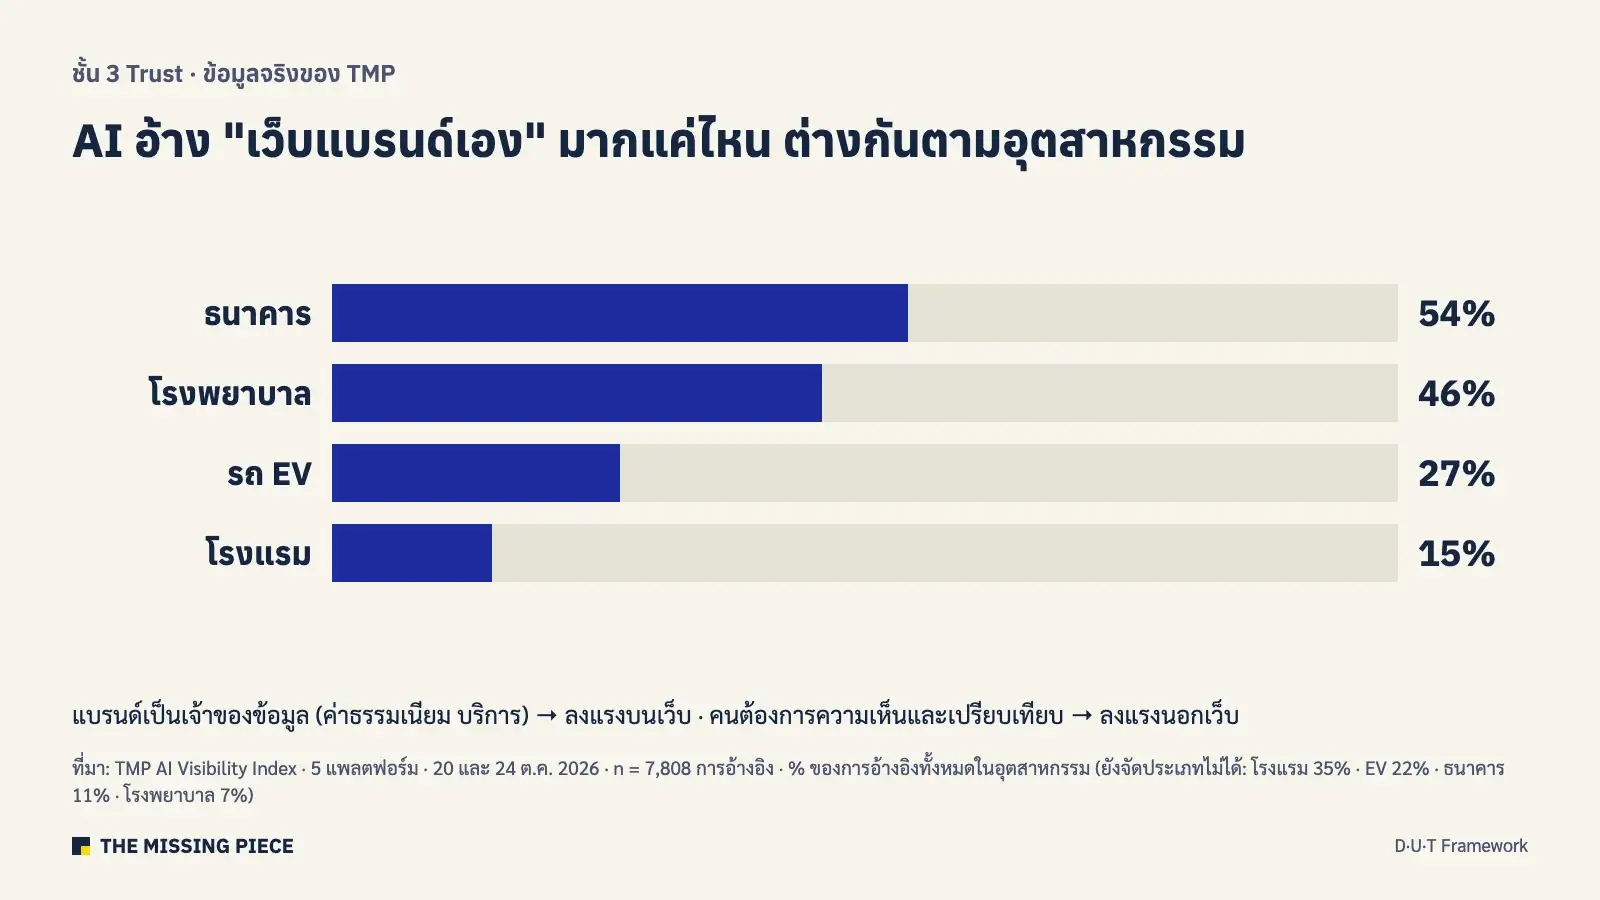
AI Visibility Index ของ TMP (4 อุตสาหกรรม · 5 แพลตฟอร์ม: AI Overviews, AI Mode, ChatGPT ค้นเว็บ, Gemini และ Perplexity · 20 และ 24 ต.ค. 2026 · n = 7,808 การอ้างอิง) พบว่าเว็บแบรนด์เป็นแหล่งที่ถูกอ้างมากที่สุดเมื่อแบรนด์เป็นเจ้าของข้อมูล แต่สัดส่วนต่างกันมากตามอุตสาหกรรม
| ประเภทแหล่งที่ AI อ้าง | รวม (เฉพาะที่จัดประเภทได้) | ธนาคาร | โรงพยาบาล | รถ EV | โรงแรม |
|---|---|---|---|---|---|
| เว็บแบรนด์ | 43.5% | 54% | 46% | 27% | 15% |
| เว็บเปรียบเทียบ/รีวิว | 16.4% | 12% | 4% | 15% | 21% |
| ชุมชน/โซเชียล | 13.4% | 9% | 10% | 15% | 10% |
| สื่อ | 13.1% | 6% | 6% | 17% | 14% |
| รัฐ/สถาบัน | 9.0% | 7% | 19% | 3% | 1% |
| ยังไม่จัดประเภท | — | 11% | 7% | 22% | 35% |
อ่านอย่างไร: ธนาคารและโรงพยาบาล เว็บแบรนด์คือแหล่งหลัก เพราะแบรนด์เป็นเจ้าของข้อมูลอย่างค่าธรรมเนียม ดอกเบี้ย และบริการ ชั้น Trust บนเว็บ (ข้อมูลครบ ตรง ทันสมัย) จึงคุ้มที่สุด ส่วนโรงแรมและรถ EV ที่คนต้องการความเห็นและการเปรียบเทียบ AI ไปที่เว็บรีวิว สื่อ และชุมชนมากกว่า ชั้น Trust นอกเว็บจึงเป็นงานหลัก ผลไทยนี้ต่างจากงานโทรอนโต (ซึ่งจัดประเภทแหล่งต่างกัน) ที่พบ earned media สูงในทุกหมวด ซึ่งชี้ว่าต้องดูข้อมูลของอุตสาหกรรมและภาษาของตัวเองก่อนตัดสินว่าจะลงแรงที่ไหน
วัดชั้น Trust อย่างไร: เลิกวัด "อันดับใน ChatGPT"
คำตอบของ AI แกว่งมากจนการวัดอันดับไม่มีความหมาย งานของ SparkToro และ Gumshoe (ม.ค. 2026 · 2,961 รอบ) พบว่ารายชื่อแบรนด์ชุดเดียวกันกลับมาซ้ำไม่ถึง 1 ใน 100 รอบ และเรียงลำดับเดียวกันไม่ถึง 1 ใน 1,000 รอบ สิ่งที่วัดได้จริงคือ mention rate (สัดส่วนคำตอบที่เอ่ยชื่อแบรนด์) และ citation rate (สัดส่วนคำตอบที่ลิงก์ไปเว็บ) จากหลายรอบ พร้อมช่วงความเชื่อมั่น มาตรฐานงานวิจัยของ TMP คือ 50 คำถาม × อย่างน้อย 2 รอบต่อกลุ่ม ซึ่งให้ค่าคลาดเคลื่อนราว ±14% ที่ความเชื่อมั่น 95% ถ้าใช้ 20 คำถามให้ถือเป็นผลเบื้องต้น (AI SEO For Dummies บทที่ 8 แนะนำให้วัดซ้ำก่อนสรุปผล)
ความผิดพลาดที่คนมีประสบการณ์ก็ยังพลาดในชั้น Trust
- รายงาน "อันดับในคำตอบ AI" จากการถามครั้งเดียว
- ปั่น mention ปลอม ซึ่ง Google ระบุว่าระบบ spam ทำงานต่อต้านอยู่แล้ว
- ใช้ชื่อแบรนด์หลายแบบ (ไทย อังกฤษ ตัวย่อ) โดยไม่มี alternateName และ sameAs เชื่อม
- ทำ PR แต่ไม่ได้อยู่ในหน้าที่คนใช้ตัดสินใจ เช่น บทความรวม "ที่สุด" หน้าเปรียบเทียบ และไดเร็กทอรี ที่ AI อ้างอยู่แล้ว (AI SEO For Dummies บทที่ 20)
- ลงแรงนอกเว็บก่อนเว็บแบรนด์ตอบข้อมูลที่ตัวเองเป็นเจ้าของได้ครบ
ลำดับแก้ตามผลกระทบ: (1) ข้อเท็จจริงแบรนด์ชุดเดียวกันทุกที่ (ชื่อ หมวด คำอธิบาย ราคา) → (2) Organization schema ที่ถูกต้องพร้อม sameAs → (3) หาให้เจอว่า AI อ้างแหล่งประเภทไหนในอุตสาหกรรมคุณ → (4) ลงแรงกับแหล่งประเภทนั้น เริ่มจากหน้าที่ AI อ้างอยู่แล้ว
ตรวจเว็บคุณด้วย D·U·T ใน 30 วินาที
วิธีที่เร็วที่สุดในการรู้ว่าเว็บคุณติดชั้นไหน คือตรวจด้วย AI-Ready Check เครื่องมือฟรีของ The Missing Piece ที่ตรวจหน้าเว็บ 19 ข้อจาก HTML ที่เว็บส่งมาจริง แล้วแยกผลตาม 3 ชั้นของกรอบนี้ ไม่ต้องสมัครและไม่ต้องให้อีเมล เครื่องมือตรวจชั้น Discover และ Understand ได้ครบ และตรวจชั้น Trust เฉพาะส่วนบนเว็บ ส่วนนอกเว็บต้องวัดจากคำตอบ AI จริงตามหัวข้อด้านบน
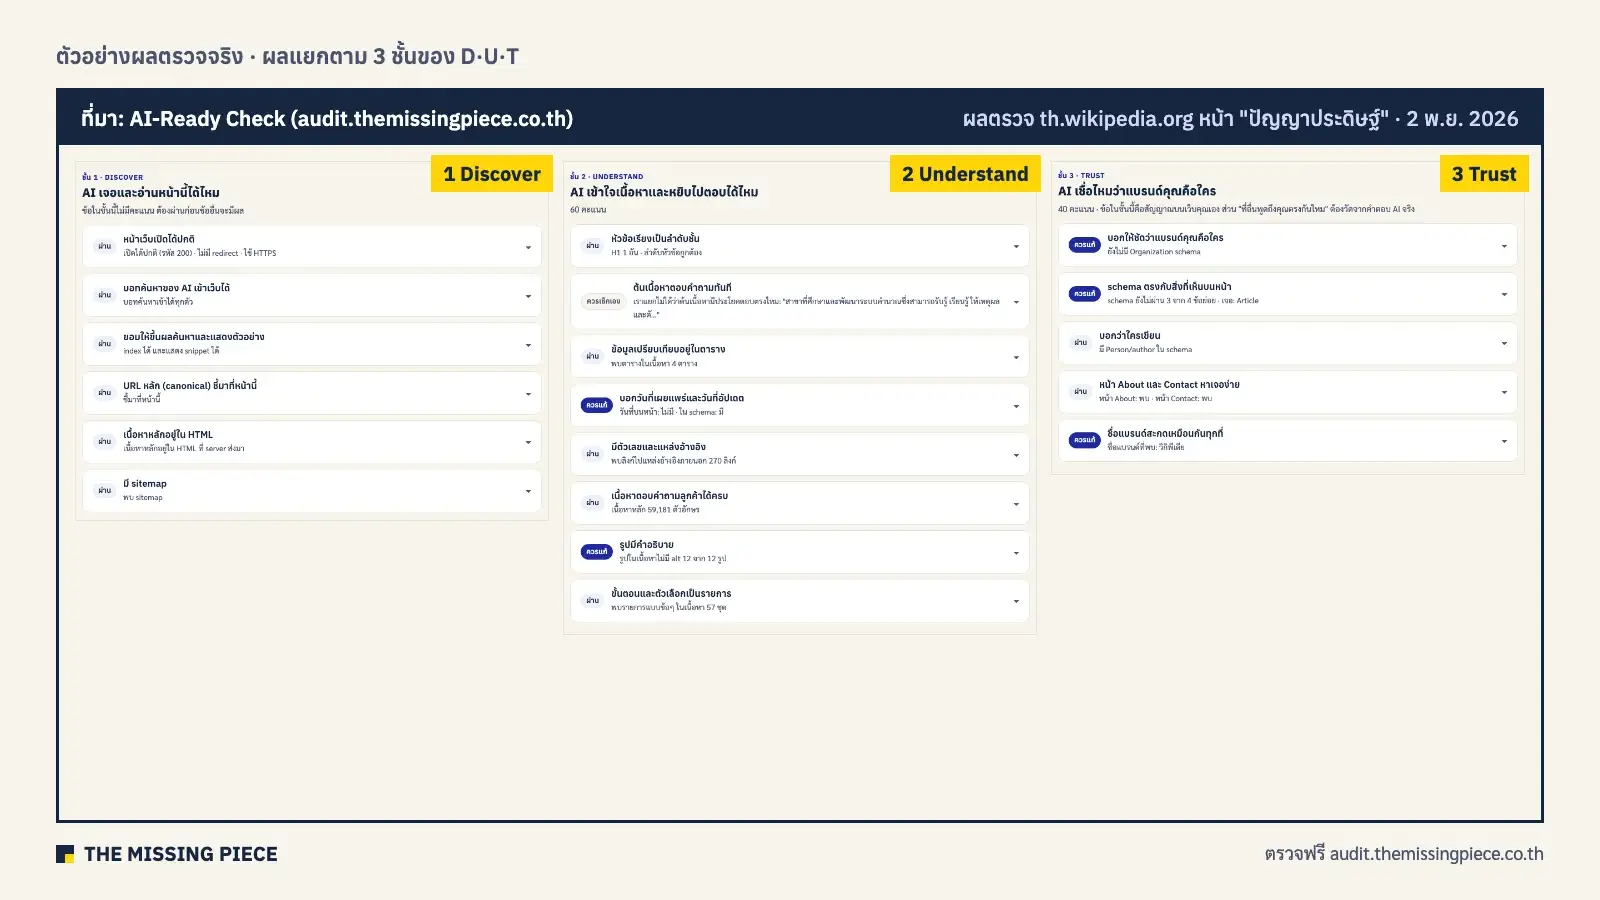
ใส่ URL หน้าที่อยากให้ลูกค้าเจอที่สุด อ่านผลเริ่มจาก Discover แล้วแก้ตามวิธีแก้ทีละขั้น จากนั้นตรวจซ้ำและดู log ว่าบอทค้นหากลับมาเปิดหน้าจริงไหม
คะแนนบอกความพร้อมของหน้าเว็บ ไม่ใช่การันตีว่า AI จะอ้างถึงคุณ ถ้าอยากลงมือกับเว็บของตัวเองพร้อมผู้สอน ดูคอร์ส Agentic SEO & AI Search (2 วัน) (คอร์สของ The Missing Piece เอง) ที่ลงมือทำกับเว็บจริงของคุณในห้อง
คำถามที่พบบ่อย
D·U·T Framework ต่างจาก AI-Ready Website อย่างไร
D·U·T Framework คือ AI-Ready Website ฉบับปรับใหม่บน URL เดิม เนื้อหาหลักยังเป็น 3 ส่วนเหมือนเดิม แต่เปลี่ยนชื่อชั้นตามคำถามที่ AI ถามตัวเอง (เจอ เข้าใจ เชื่อ) เพิ่มวิธีวัดและเกณฑ์ผ่านของแต่ละชั้น และผูกทุกข้อเข้ากับเกณฑ์ตรวจของ AI-Ready Check
ต้องทำ llms.txt ไหม
llms.txt เป็นข้อเสนอที่ยังไม่ใช่มาตรฐานทางการ และ Google ระบุว่าไม่จำเป็นสำหรับ Google Search (มิ.ย. 2026) และไม่มีการปรับแต่งพิเศษที่จำเป็นสำหรับ AI Overviews ในมุมมองผม ทำได้เพราะต้นทุนต่ำและอาจช่วยเครื่องมือ AI บางตัว แต่อย่าคาดหวังว่าจะทำให้ถูกอ้างอิงมากขึ้นทันที
ควรบล็อก AI bot ไหม
ขึ้นกับเป้าหมายธุรกิจ และต้องแยกบอท 3 ประเภทให้ออก การบล็อกบอทค้นหาอย่าง OAI-SearchBot, Claude-SearchBot หรือ PerplexityBot ทำให้หายจากผลค้นหาของเจ้านั้น ส่วนการบล็อก GPTBot, ClaudeBot หรือ Google-Extended กันการนำข้อมูลไปฝึกโมเดลเป็นหลัก และบอทที่ผู้ใช้สั่งหลายเจ้าไม่ทำตาม robots.txt ถ้าต้องกันจริงต้องใช้ WAF
ทำ D·U·T แล้วจะเห็นผลเมื่อไหร่
ชั้น Discover เห็นผลเร็วที่สุด: ใน log ของ TMP หน้าใหม่ถูกบอทค้นหาของ ChatGPT เปิดภายในไม่กี่ชั่วโมง แต่หน้าเดิมที่แก้เนื้อหาอาจไม่ถูกเก็บฉบับใหม่นานกว่า 2 สัปดาห์ (ทดลอง 1 หน้าของ TMP) และ Google เองก็อาจใช้เวลาหลายวันขึ้นไปกว่าจะกลับมาเก็บหน้า ชั้น Trust ใช้เวลานานที่สุด ควรตั้ง baseline ก่อนแก้ แล้ววัด mention rate และ citation rate ด้วยชุดคำถามเดิม
อ่านต่อ
แหล่งอ้างอิง
ข้อมูลของ The Missing Piece
- log บอทของ themissingpiece.co.th (14 ต.ค.–2 พ.ย. 2026 · n = 1,658)
- TMP AI Visibility Index ต.ค. 2026 (4 อุตสาหกรรม · 5 แพลตฟอร์ม · n = 7,808 การอ้างอิง)
- TMP AI Citation #1 (2–3 ต.ค. 2026 · n = 224 หน้า) · ผลการทดสอบ
เอกสารทางการ
- Google Search Central — AI features and your website
- Google Search Central — AI optimization guide (ก.ค. 2026)
- Google — Google's common crawlers (อัปเดต 30 ต.ค. 2026)
- Google — User-triggered fetchers
- Google — Organization structured data
- Google — A guide to Google Search ranking systems (passage ranking)
- Google — AI Mode update, Google I/O (พ.ค. 2025)
- Search Console Help — Search generative AI setting
- Search Console Help — Generative AI performance report
- OpenAI — Overview of OpenAI crawlers
- Anthropic — Does Anthropic crawl data from the web
- Perplexity — Perplexity Crawlers
- Apple — About Applebot
- Meta — Web crawlers
- Bing — Clearer preferences for training and grounding (30 ต.ค. 2026)
- IndexNow FAQ
- schema.org — sameAs
- llmstxt.org — The /llms.txt file (ข้อเสนอโดย Jeremy Howard, Answer.AI, ก.ย. 2024)
งานวิจัยและรายงาน
- Vercel & MERJ — The rise of the AI crawler (ธ.ค. 2024)
- Cloudflare — Content Independence Day (1 ก.ค. 2025)
- Cloudflare — The crawl-to-click gap (ส.ค. 2025)
- Cloudflare — Accountable mixed-use AI crawlers (ก.ย. 2026)
- Aggarwal et al. — GEO: Generative Engine Optimization (KDD 2024)
- Ahrefs — AI Overview citations and the top 10 (มี.ค. 2026)
- Ahrefs — AI Overview brand correlation, 75K brands (พ.ค. 2025)
- Ahrefs — AI brand visibility correlations (ธ.ค. 2025)
- Chen, Wang, Chen, Koudas — earned vs owned media in AI search (arXiv 2509.08919, ก.ย. 2025)
- SparkToro × Gumshoe — AIs are highly inconsistent when recommending brands (ม.ค. 2026)
หนังสือ
- Nathan Gotch, AI SEO For Dummies (Wiley, 2026) — บทที่ 5 (ฐานข้อมูลคำถาม), บทที่ 8 (วัดซ้ำ), บทที่ 10 (AI-Readiness Checkup), บทที่ 11–12 (โครงหน้าและหน้าที่แบรนด์คุมเรื่องเล่า), บทที่ 13 (entity alignment), บทที่ 16–17 (ข้อเท็จจริงแบรนด์และโปรไฟล์), บทที่ 20 (mentions และ citations)
- Eric Enge, Stephan Spencer, Jessie Stricchiola, The Art of SEO, 4th ed. (O'Reilly, 2023) — บทที่ 4 (เครื่องมือและข้อมูล รวม server log), บทที่ 7 (robots.txt, canonical, sitemap, rendering) และบทที่ 10 (หน้าไม่ถูก index)