สรุปสั้น (TL;DR)
ถ้าอยากถูก AI อ้างอิง ต้องเปิด bot ที่ใช้ค้นหา (OAI-SearchBot, Claude-SearchBot, PerplexityBot, Googlebot และ Bingbot) ส่วน bot ที่ใช้ฝึกโมเดล (GPTBot, ClaudeBot, CCBot, Google-Extended) บล็อกได้โดยไม่หายจาก ChatGPT search และ AI Overviews AI bot แบ่งเป็น 3 งาน คือ ฝึกโมเดล ค้นหาเพื่อตอบ และเปิดหน้าตามคำสั่งผู้ใช้ ถ้าบล็อกผิดงาน เว็บอาจหายจากคำตอบของ ChatGPT หรือ Perplexity โดยไม่รู้ตัว
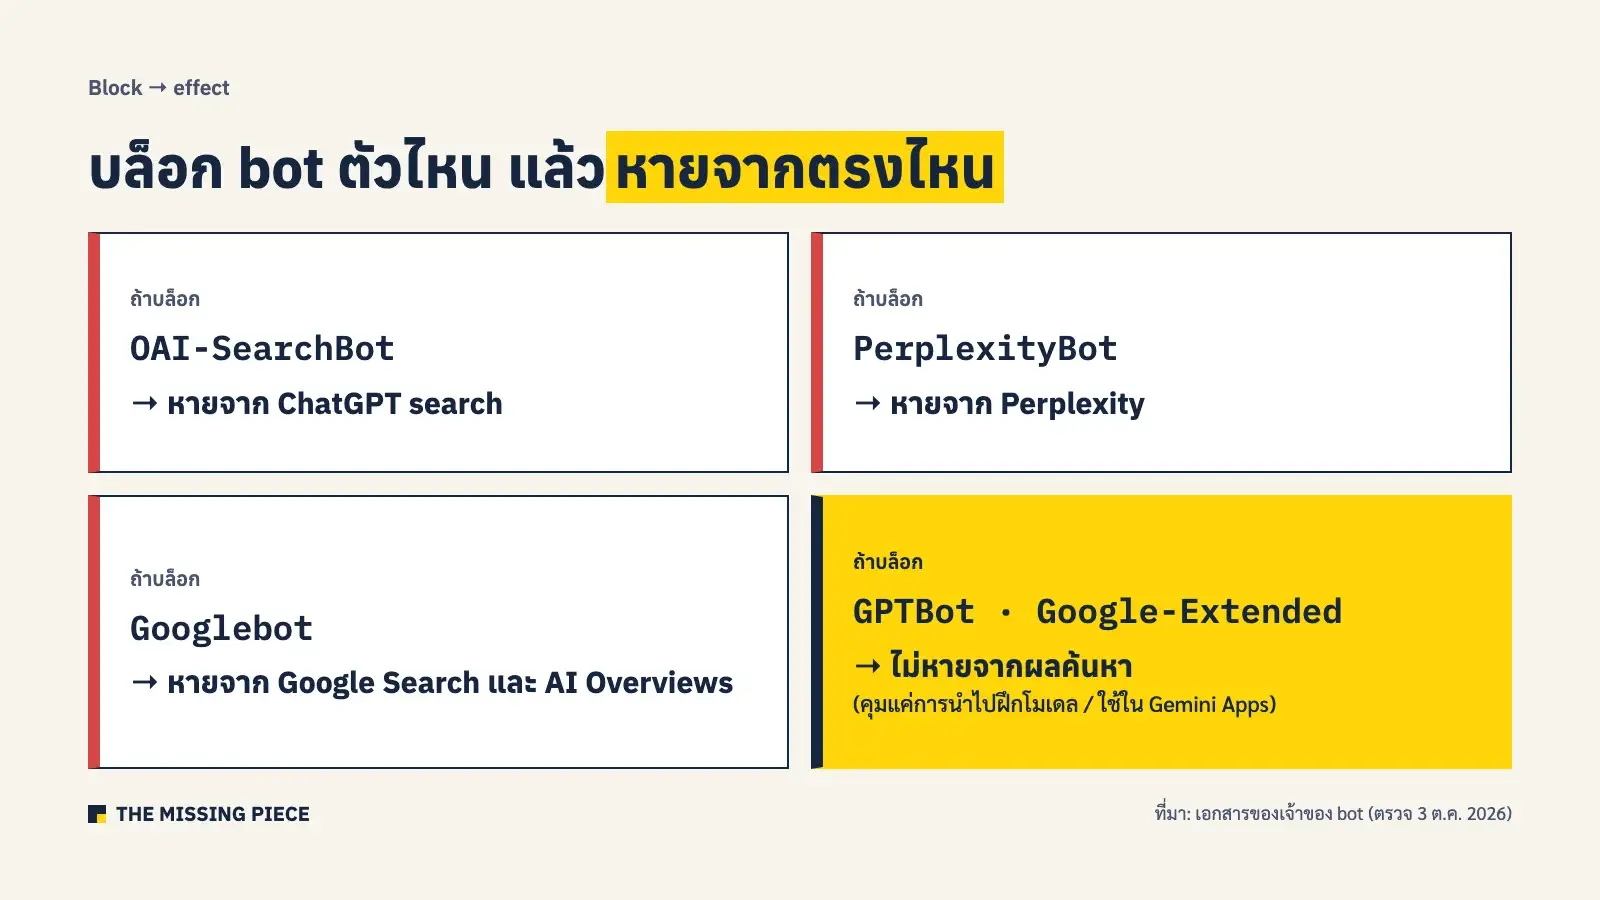
- บล็อก GPTBot ได้โดยไม่หายจาก ChatGPT search ตราบที่ไม่บล็อก OAI-SearchBot
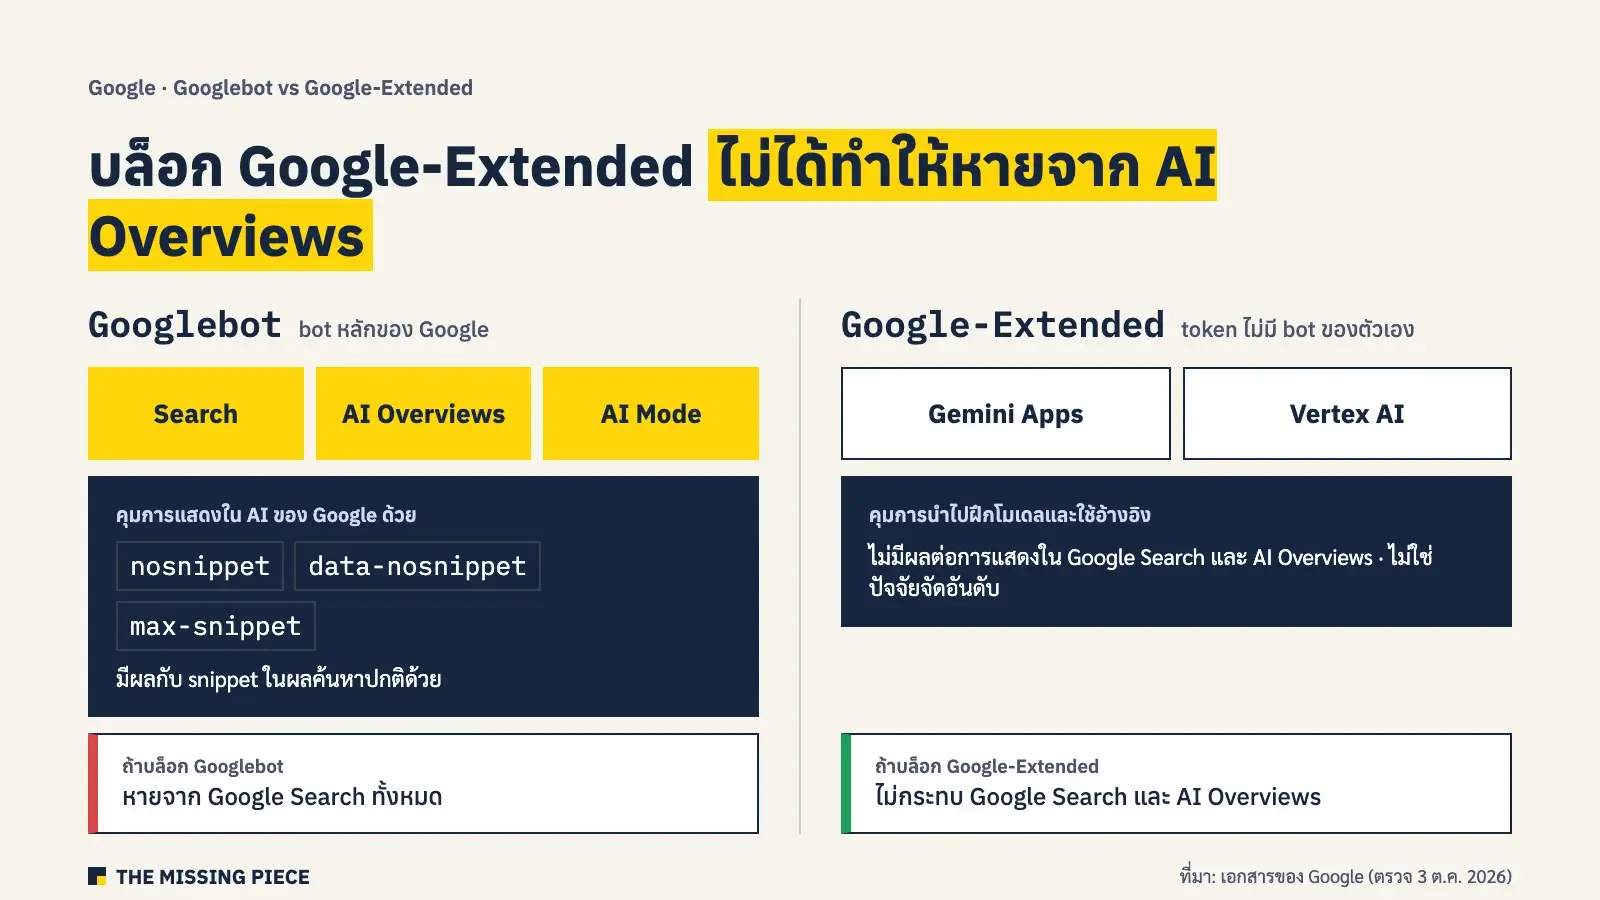
- บล็อก Google-Extended ไม่ได้ทำให้หายจาก AI Overviews เพราะ AI Overviews ใช้ Googlebot
- bot ที่เปิดหน้าตามคำสั่งผู้ใช้ เช่น ChatGPT-User และ Perplexity-User อาจไม่ทำตาม robots.txt
สารบัญ
- AI bot มีกี่แบบ
- ตาราง AI bot 9 บริษัทหลัก (ต.ค. 2026)
- GPTBot กับ OAI-SearchBot ต่างกันยังไง
- บล็อก Google-Extended แล้วหายจาก AI Overviews ไหม
- ควรบล็อก AI bot ไหม
- ตัวอย่าง robots.txt สำหรับ AI bot พร้อมใช้ 3 แบบ
- ความผิดพลาดที่พบบ่อย
- เว็บไทยตั้งค่า AI bot กันแค่ไหน
- ตั้งถูกแล้ว ทำไม AI ยังเข้าไม่ได้
- แก้ robots.txt บน WordPress และตรวจผล
- คำถามที่พบบ่อย
AI bot มีกี่แบบ
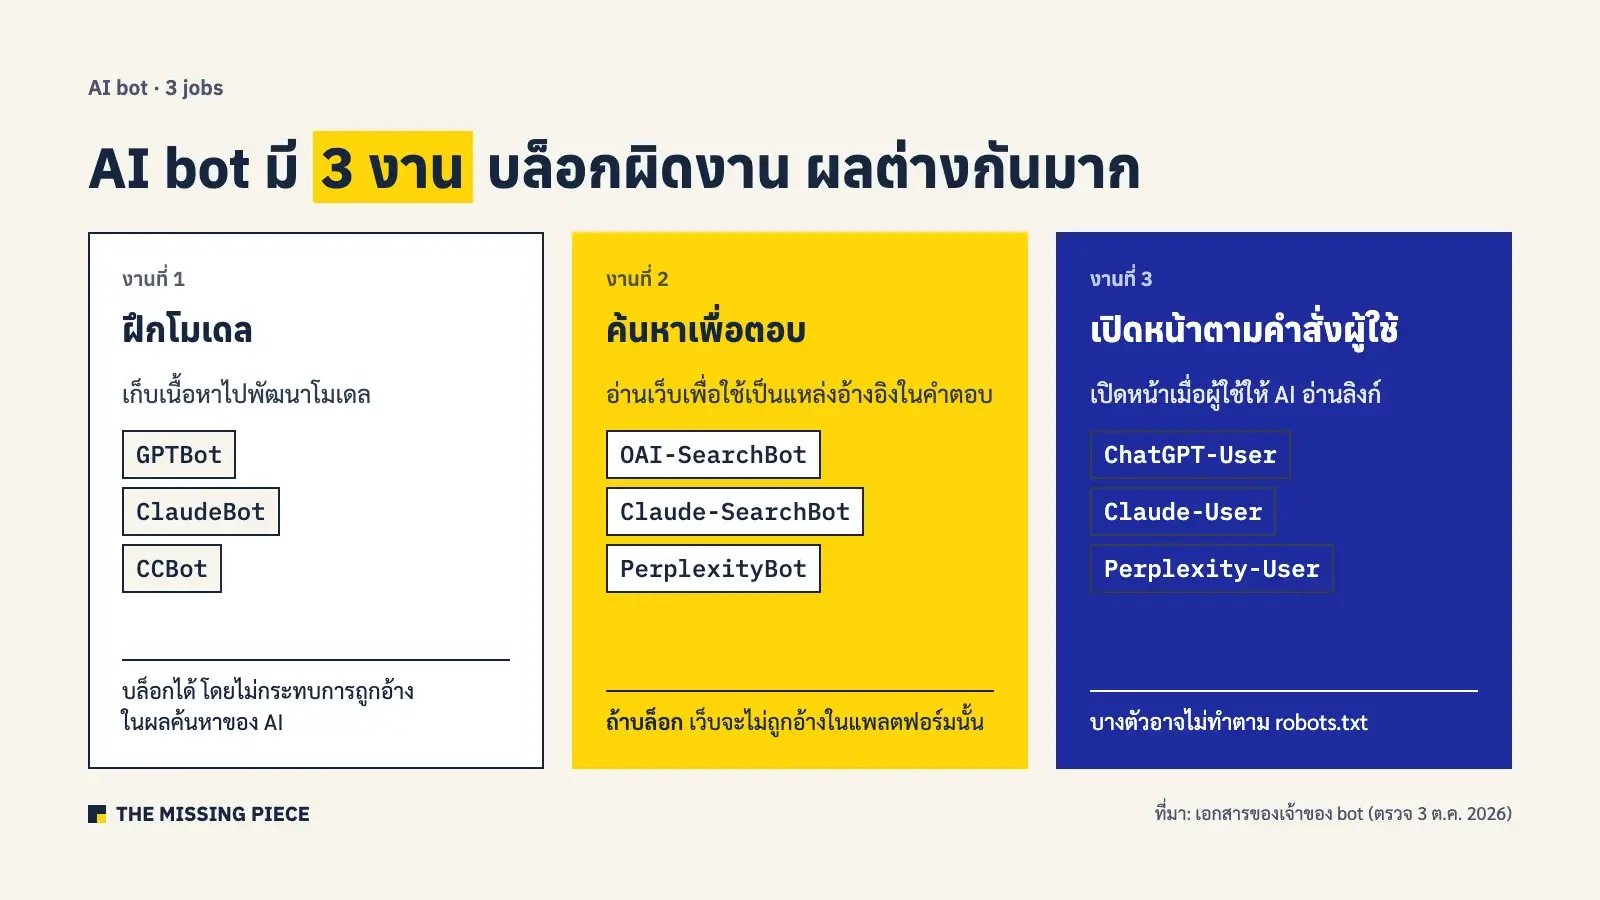
AI bot แบ่งได้ 3 งาน คือ bot ที่เก็บข้อมูลไปฝึกโมเดล bot ที่ค้นหาเพื่อเอาไปตอบในผลค้นหาของ AI และ bot ที่เปิดหน้าเว็บเมื่อผู้ใช้สั่ง บริษัทเดียวกันมักมี bot แยกตามงาน การบล็อก bot ตัวหนึ่งจึงไม่ได้แปลว่าบล็อก AI ของบริษัทนั้นทั้งหมด ดูภาพรวมของ AI Search ก่อนได้ที่ AI Search คืออะไร
- ฝึกโมเดล — เก็บเนื้อหาไปพัฒนาโมเดล เช่น GPTBot, ClaudeBot, CCBot บล็อกได้โดยไม่กระทบการถูกอ้างในผลค้นหาของ AI
- ค้นหาเพื่อตอบ — อ่านเว็บเพื่อใช้เป็นแหล่งอ้างอิงในคำตอบ เช่น OAI-SearchBot, Claude-SearchBot, PerplexityBot ถ้าบล็อก เว็บจะไม่ถูกอ้างในแพลตฟอร์มนั้น
- เปิดหน้าตามคำสั่งผู้ใช้ — เปิดหน้าเมื่อผู้ใช้ให้ AI อ่านลิงก์ เช่น ChatGPT-User, Claude-User, Perplexity-User บางตัวอาจไม่ทำตาม robots.txt
ตาราง AI bot 9 บริษัทหลัก (ข้อมูล ณ ต.ค. 2026)
ตารางนี้รวม bot ของ AI หลัก 9 บริษัท ตรวจจากเอกสารของเจ้าของ bot เมื่อ 3 ต.ค. 2026 คอลัมน์ “ทำตาม robots.txt” ใช้คำอธิบายของเจ้าของ bot เอง จำนวน bot เพิ่มขึ้นเรื่อยๆ เช่น ปี 2026 OpenAI เพิ่ม OAI-AdsBot และ Google เพิ่ม Google-Agent เราจะตรวจตารางนี้ซ้ำทุกไตรมาส
| บริษัท | bot (User-agent = ชื่อที่ bot ใช้แนะนำตัว) | งาน | ทำตาม robots.txt | ถ้าบล็อก |
|---|---|---|---|---|
| OpenAI | GPTBot | ฝึกโมเดล | ทำตาม | ไม่กระทบการถูกอ้างใน ChatGPT search |
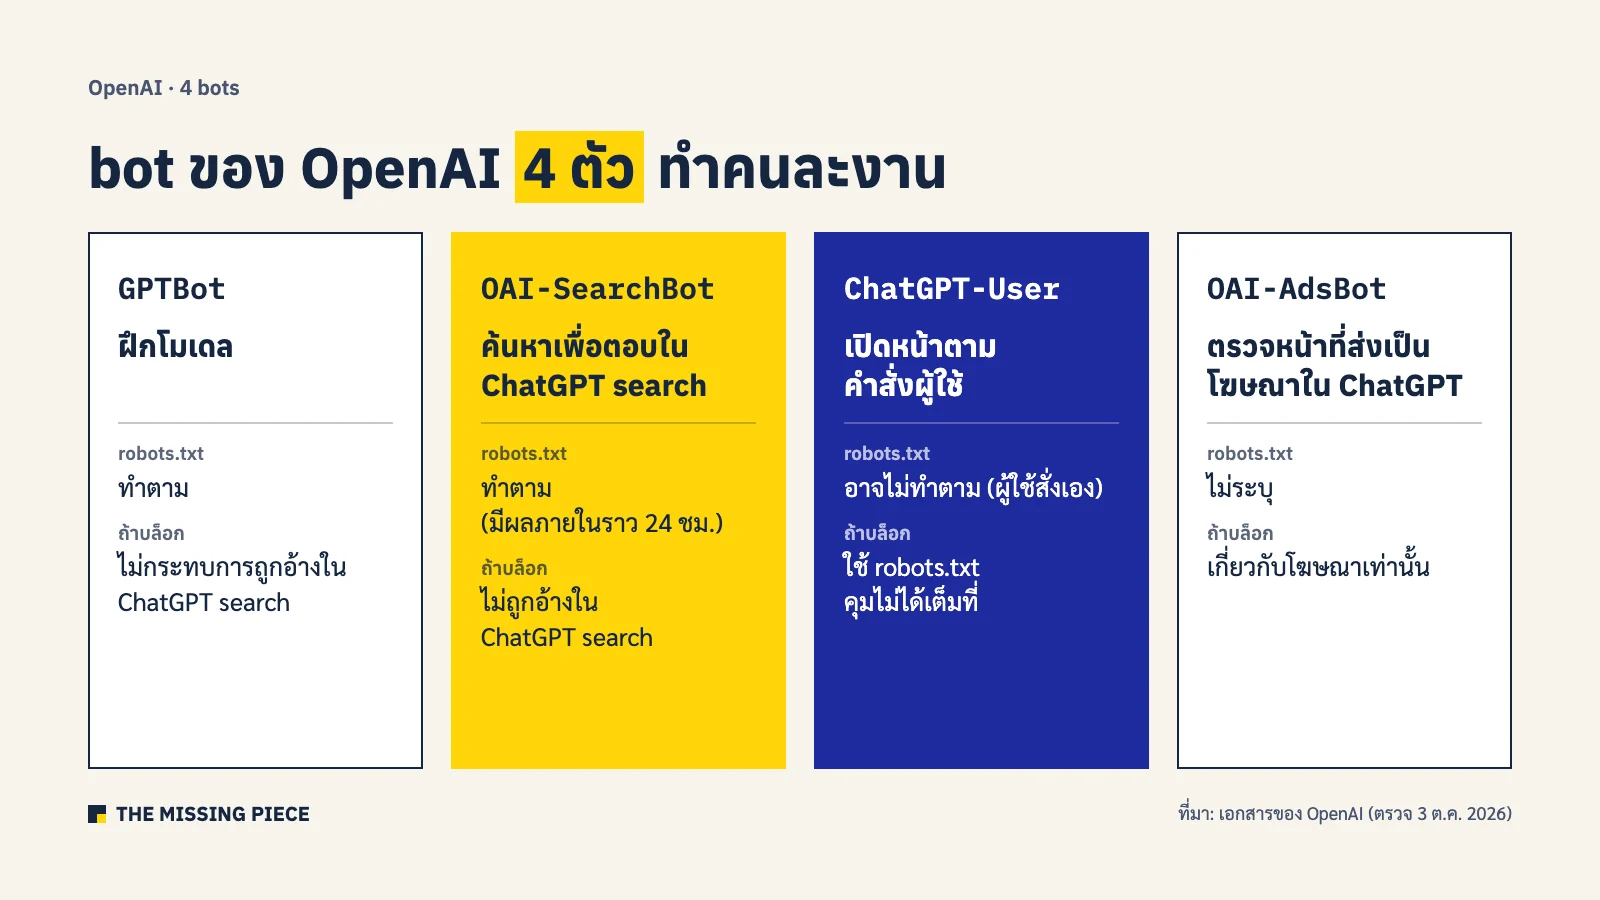
| OpenAI | OAI-SearchBot | ค้นหาเพื่อตอบใน ChatGPT | ทำตาม (มีผลภายในราว 24 ชม.) | ไม่ถูกอ้างใน ChatGPT search (อาจยังแสดงเป็นลิงก์นำทาง) |
| OpenAI | ChatGPT-User | เปิดหน้าตามคำสั่งผู้ใช้ | อาจไม่ทำตาม (ผู้ใช้สั่งเอง) | ใช้ robots.txt คุมไม่ได้เต็มที่ |
| OpenAI | OAI-AdsBot | ตรวจหน้าที่ส่งเป็นโฆษณาใน ChatGPT | ไม่ระบุ | เกี่ยวกับโฆษณาเท่านั้น |
| Anthropic | ClaudeBot | ฝึกโมเดล | ทำตาม (รองรับ Crawl-delay) | ไม่กระทบการค้นหาของ Claude |
| Anthropic | Claude-SearchBot | ค้นหาเพื่อตอบใน Claude | ทำตาม | อาจลดการถูกอ้างใน Claude |
| Anthropic | Claude-User | เปิดหน้าตามคำสั่งผู้ใช้ | ทำตาม | Claude เปิดหน้าตามคำขอผู้ใช้ไม่ได้ |
| Perplexity | PerplexityBot | ค้นหาเพื่อตอบ (ไม่ใช้ฝึก) | ทำตาม | ไม่ถูกอ้างใน Perplexity |
| Perplexity | Perplexity-User | เปิดหน้าตามคำสั่งผู้ใช้ | โดยทั่วไปไม่ทำตาม | ใช้ robots.txt คุมไม่ได้ |
| Googlebot | Google Search รวม AI Overviews และ AI Mode | ทำตาม | หายจาก Google Search ทั้งหมด | |
| Google-Extended | ชื่อควบคุมใน robots.txt (ไม่มี bot วิ่งจริง) คุมการฝึกและ grounding ใน Gemini Apps และ Vertex AI | ทำตาม (ไม่มี bot ของตัวเอง) | ไม่กระทบ Google Search และ AI Overviews | |
| Google-Agent และ fetcher ที่ผู้ใช้สั่ง | เปิดหน้าตามคำสั่งผู้ใช้ | โดยทั่วไปไม่ทำตาม | ใช้ robots.txt คุมไม่ได้ | |
| Microsoft | Bingbot | Bing และคำตอบของ Copilot | ทำตาม | หายจาก Bing และ Copilot · คุมเฉพาะ Copilot ด้วย meta NOARCHIVE/NOCACHE |
| Apple | Applebot / Applebot-Extended | ค้นหา / token คุมการฝึกโมเดลของ Apple | ทำตาม | Applebot-Extended ไม่กระทบการแสดงในการค้นหาของ Apple |
| Meta | meta-externalagent | ฝึกโมเดลและทำดัชนีให้ผลิตภัณฑ์ของ Meta | ทำตาม (มีผลภายใน 24 ชม.) | ไม่ถูกเก็บไปฝึกโมเดลของ Meta (การค้นหาของ Meta AI ใช้ Meta-WebIndexer แยกต่างหาก) |
| Common Crawl | CCBot | ชุดข้อมูลเปิดที่ AI หลายเจ้านำไปฝึก | ทำตาม | ไม่อยู่ในชุดข้อมูลรอบถัดไป |
| ByteDance | Bytespider | ฝึกโมเดลและผลิตภัณฑ์ของ ByteDance | ByteDance ระบุว่าทำตาม (รายงาน TollBit H1 2026 ผ่าน PPC Land พบว่าบางครั้งไม่ทำ) | ไม่ถูกเก็บข้อมูล |
รายการ IP ทางการสำหรับตรวจ bot จริง: openai.com/gptbot.json · openai.com/searchbot.json · openai.com/chatgpt-user.json · claude.com/crawling/bots.json · perplexity.com/perplexitybot.json · developers.google.com/static/search/apis/ipranges/googlebot.json · bing.com/toolbox/bingbot.json · search.developer.apple.com/applebot.json · index.commoncrawl.org/ccbot.json (Meta และ ByteDance ไม่ได้เผยแพร่)
GPTBot กับ OAI-SearchBot ต่างกันยังไง
GPTBot เก็บข้อมูลไปฝึกโมเดลของ OpenAI ส่วน OAI-SearchBot อ่านเว็บเพื่อใช้เป็นแหล่งอ้างอิงใน ChatGPT search คุณจึงบล็อก GPTBot ได้โดยไม่หายจาก ChatGPT search ตราบที่ไม่บล็อก OAI-SearchBot OpenAI มี bot 4 ตัว และเผยแพร่รายการ IP ของแต่ละตัวไว้ให้ตรวจว่า bot ที่เข้าเว็บเป็นของจริง ถ้าอยากรู้ต่อว่าทำยังไงให้ ChatGPT แนะนำแบรนด์ อ่านได้ที่ ChatGPT SEO คืออะไร
ความเข้าใจผิดเรื่องนี้พบได้แม้ในคำตอบของ AI เอง เมื่อเราค้น “gptbot” ใน Google (3 ต.ค. 2026) AI Overview ตอบว่า GPTBot ช่วยให้เว็บแสดงใน ChatGPT search ซึ่งไม่ตรงกับเอกสารของ OpenAI (ผลจากการค้นครั้งเดียว คำตอบของ AI เปลี่ยนได้ทุกครั้ง) และเมื่อค้น “บล็อก ai bot robots.txt” AI Overview ให้ตัวอย่างไฟล์ที่บล็อก OAI-SearchBot และ PerplexityBot ด้วย ถ้าคัดลอกไปใช้ เว็บจะหายจาก ChatGPT search และ Perplexity
บล็อก Google-Extended แล้วหายจาก AI Overviews ไหม
ไม่หาย Google-Extended คุมเฉพาะการนำเนื้อหาไปฝึกโมเดลและใช้เป็นข้อมูลอ้างอิงตอนตอบ (grounding) ใน Gemini Apps และ Vertex AI Google ระบุว่า token นี้ไม่มีผลต่อการแสดงใน Google Search และไม่ใช่ปัจจัยจัดอันดับ ส่วน AI Overviews และ AI Mode ใช้ข้อมูลจาก Googlebot ถ้าอยากจำกัดเนื้อหาที่แสดงใน AI ของ Google ต้องใช้ meta nosnippet, data-nosnippet หรือ max-snippet ซึ่งมีผลกับ snippet ในผลค้นหาปกติด้วย
ควรบล็อก AI bot ไหม
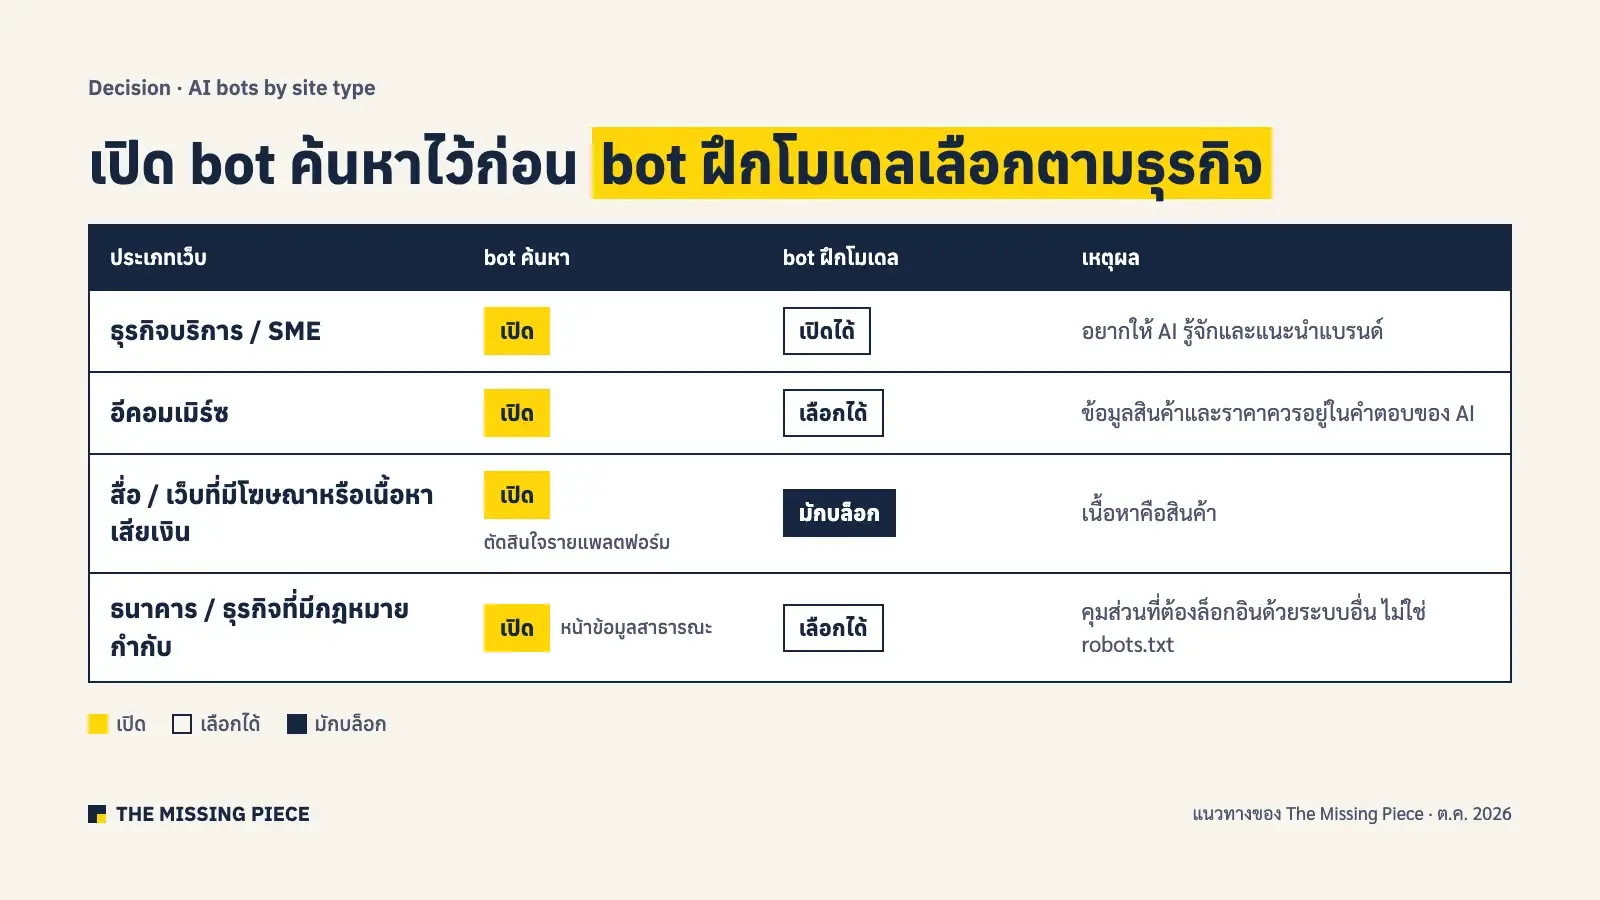
ธุรกิจส่วนใหญ่ควรเปิดให้ bot ที่ใช้ค้นหาเข้าได้ และตัดสินเรื่อง bot ฝึกโมเดลตามประเภทธุรกิจ เพราะ bot ค้นหาคือทางที่ทำให้เว็บถูกอ้างในคำตอบของ AI ส่วน bot ฝึกโมเดลไม่ได้ส่งคนเข้าเว็บโดยตรง เว็บที่ขายเนื้อหาจึงมีเหตุผลที่จะบล็อก ขณะที่เว็บธุรกิจทั่วไปเสียน้อยกว่าถ้าเปิดไว้ ข้อมูลของ Ahrefs (ก.ย. 2026) สะท้อนเรื่องนี้ ในกลุ่มเว็บใหญ่ของเยอรมนี ออสเตรีย และสวิตเซอร์แลนด์ เว็บข่าว 61% บล็อก GPTBot แต่ร้านค้าบล็อกเพียง 6% และ AI SEO For Dummies (บทที่ 22) ก็เตือนว่าการบล็อก AI bot แบบเหมารวมไม่ใช่ทางเลือกที่ดีเสมอ
| ประเภทเว็บ | bot ค้นหา | bot ฝึกโมเดล | เหตุผล |
|---|---|---|---|
| ธุรกิจบริการ / SME | เปิด | เปิดได้ | อยากให้ AI รู้จักและแนะนำแบรนด์ |
| อีคอมเมิร์ซ | เปิด | เลือกได้ | ข้อมูลสินค้าและราคาควรอยู่ในคำตอบของ AI |
| สื่อ / เว็บที่มีโฆษณาหรือเนื้อหาเสียเงิน | เปิด (ตัดสินใจรายแพลตฟอร์ม) | มักบล็อก | เนื้อหาคือสินค้า |
| ธนาคาร / ธุรกิจที่มีกฎหมายกำกับ | เปิดหน้าข้อมูลสาธารณะ | เลือกได้ | คุมส่วนที่ต้องล็อกอินด้วยระบบอื่น ไม่ใช่ robots.txt |
ความเห็นของผม (ไอซ์): สำหรับธุรกิจส่วนใหญ่ ผมแนะนำให้เปิดบ้านรับ bot ที่ใช้ค้นหาไว้ก่อน เพราะถ้า AI อ่านเว็บเราไม่ได้ ก็ไม่มีทางถูกอ้างอิง ส่วน bot ที่ใช้ฝึกโมเดลเป็นเรื่องที่แต่ละธุรกิจเลือกได้
ตัวอย่าง robots.txt สำหรับ AI bot พร้อมใช้ 3 แบบ
ตามมาตรฐาน robots.txt (RFC 9309) bot ที่เจอกลุ่มชื่อตัวเองจะใช้กฎของกลุ่มนั้นอย่างเดียว และไม่ดูกลุ่ม * อีก ตัวอย่างทั้ง 3 แบบจึงเลี่ยงปัญหานี้ แบบ ก ไม่ตั้งกลุ่ม AI เลย ส่วนแบบ ข และ ค ตั้งกลุ่ม AI เพื่อปิดทั้งเว็บ (Disallow: /) ถ้าคุณตั้งกลุ่ม AI เพื่อเปิด ต้องคัดลอกบรรทัด Disallow ของกลุ่ม * ไปใส่ในกลุ่มนั้นด้วยทุกบรรทัด เปลี่ยน /wp-admin/ และ yourdomain.com ให้ตรงกับเว็บของคุณ
แบบ ก: เปิดให้ bot ค้นหาและ bot ฝึกโมเดล
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://yourdomain.com/sitemap_index.xml
ไม่ต้องใส่ชื่อ AI bot เลย ทุกตัวจะใช้กฎของกลุ่ม *
แบบ ข: เปิดค้นหา ปิดฝึกโมเดล
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

# bot ฝึกโมเดล: ปิด
User-agent: GPTBot
User-agent: ClaudeBot
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Bytespider
Disallow: /

Sitemap: https://yourdomain.com/sitemap_index.xml
bot ค้นหาอย่าง OAI-SearchBot, Claude-SearchBot และ PerplexityBot ไม่มีกลุ่มของตัวเอง จึงใช้กฎของกลุ่ม * และเข้าเว็บได้ตามปกติ ข้อควรรู้: Google-Extended คุมทั้งการฝึก Gemini และการใช้เนื้อหาเป็นข้อมูลอ้างอิงตอนตอบ (grounding) ใน Gemini Apps และ Vertex AI การปิดจึงทำให้ Gemini Apps ไม่ใช้เว็บเราตอบด้วย แต่ไม่กระทบ Google Search และ AI Overviews ถ้าอยากให้ Gemini Apps อ้างเว็บ ให้ลบบรรทัด User-agent: Google-Extended ออก
แบบ ค: ปิด AI bot หลักทั้งหมด ยกเว้น Google และ Bing
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

User-agent: GPTBot
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: ClaudeBot
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: CCBot
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: meta-externalagent
User-agent: Meta-WebIndexer
User-agent: Amazonbot
User-agent: Bytespider
Disallow: /

Sitemap: https://yourdomain.com/sitemap_index.xml
แบบนี้เว็บจะยังแสดงใน Google รวม AI Overviews และใน Bing รวม Copilot แต่จะไม่ถูกอ้างใน ChatGPT search (อาจยังขึ้นเป็นลิงก์นำทาง), Claude, Perplexity และ Gemini Apps ส่วน bot ที่ผู้ใช้สั่ง เช่น ChatGPT-User และ Perplexity-User อาจยังเข้ามาอยู่ดี
robots.txt ของ The Missing Piece เองเปิดให้ AI bot เกือบทุกตัว (ปิดเฉพาะ Bytespider) และใส่ชื่อ AI bot แยกกลุ่มไว้ และเคยพลาดเรื่องเดียวกับที่เตือนไว้ข้างบน คือกลุ่ม AI ไม่ได้ซ้ำกฎกันหน้าค้นหาภายใน (/?s=, /search/ และ /*?replytocom=) ทำให้ AI bot และ Bingbot เข้าหน้าค้นหาภายในได้ เราแก้แล้วเมื่อ 3 ต.ค. 2026
กลุ่ม AI ในไฟล์ของเราหลังแก้:
User-agent: OAI-SearchBot
User-agent: ChatGPT-User
User-agent: GPTBot
User-agent: Claude-SearchBot
User-agent: Claude-User
User-agent: ClaudeBot
User-agent: PerplexityBot
User-agent: Perplexity-User
User-agent: Google-Extended
User-agent: Applebot-Extended
User-agent: Bingbot
Allow: /
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php
Disallow: /?s=
Disallow: /search/
Disallow: /*?replytocom=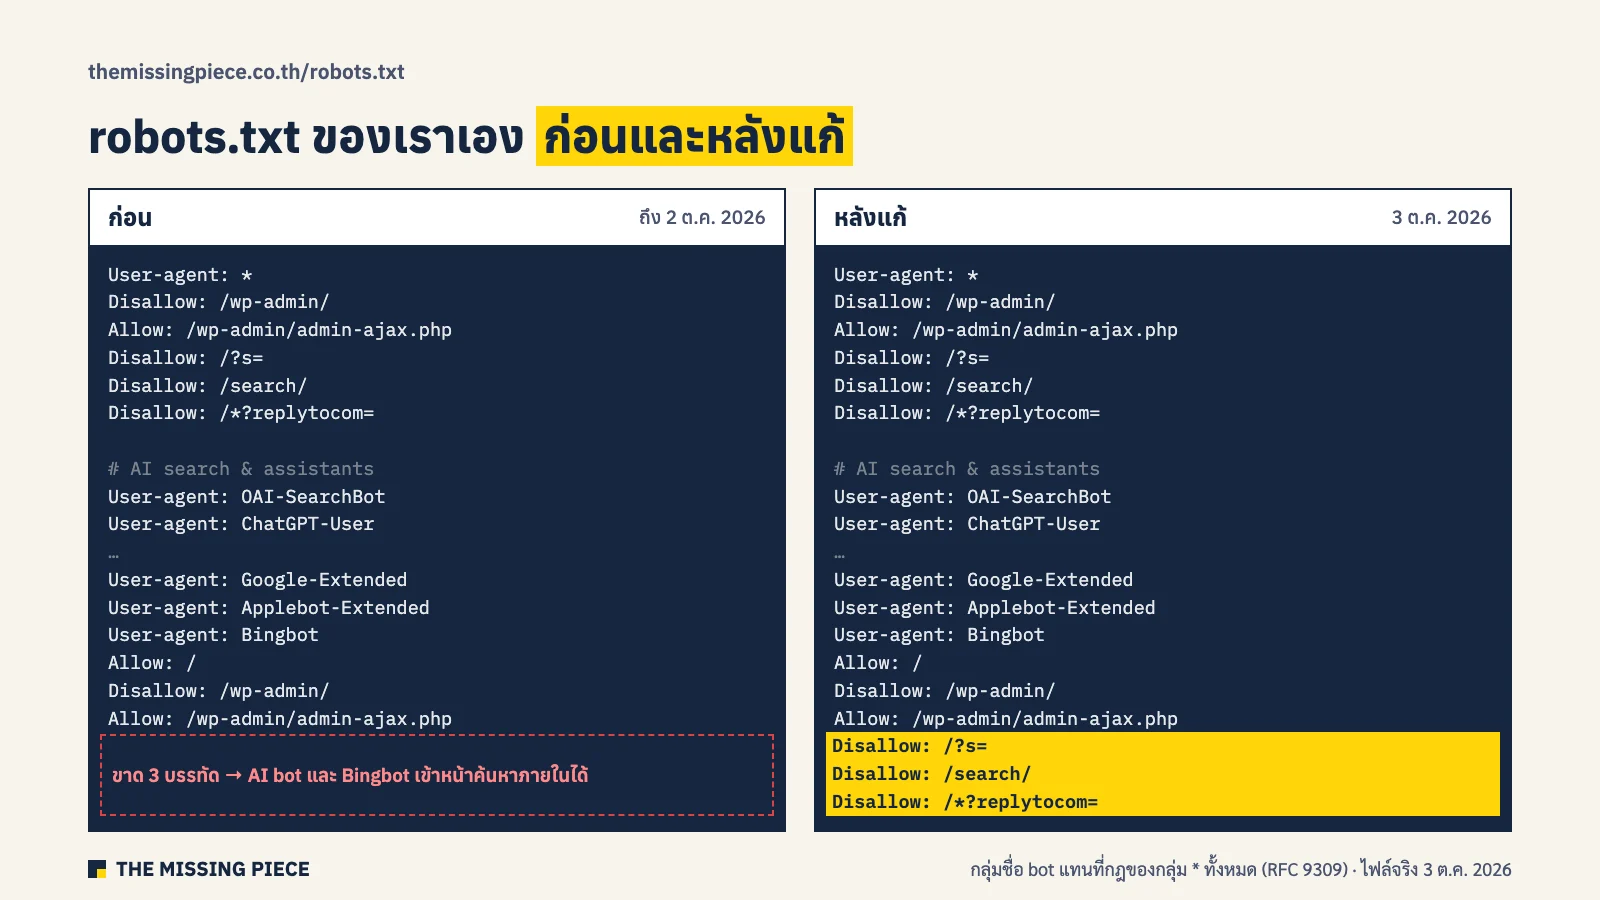
ความผิดพลาดที่พบบ่อย
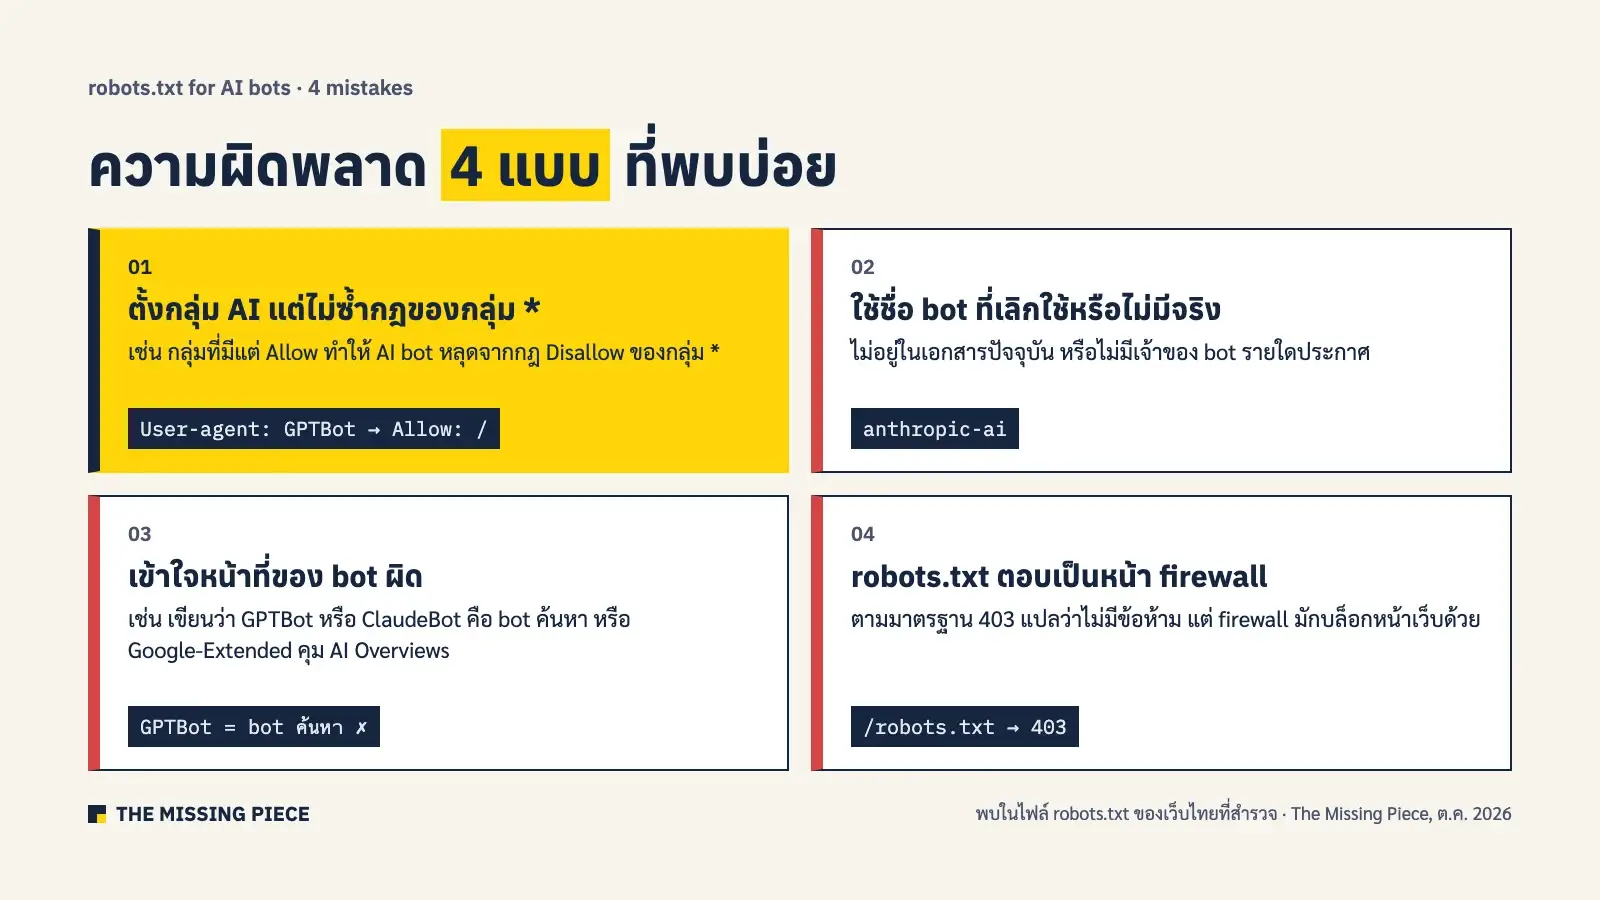
ความผิดพลาดที่พบบ่อยที่สุดคือการตั้งกลุ่มชื่อ AI bot แล้วลืมว่ากลุ่มนั้นแทนที่กฎของกลุ่ม * ทั้งหมด เราพบความผิดพลาด 4 แบบนี้ในไฟล์ robots.txt ของเว็บไทยที่สำรวจ (ต.ค. 2026) รวมถึงในไฟล์ของเราเองก่อนแก้
- ตั้งกลุ่ม AI แต่ไม่ซ้ำกฎ Disallow ของกลุ่ม * — เช่น กลุ่มที่มีแต่ Allow ไม่ได้เปิดอะไรเพิ่ม แต่ทำให้ AI bot หลุดจากกฎ Disallow ของกลุ่ม
* - ใช้ชื่อ bot ที่เลิกใช้หรือไม่มีจริง — เช่น anthropic-ai ซึ่งไม่อยู่ในเอกสารปัจจุบันของ Anthropic หรือชื่อที่ไม่มีเจ้าของ bot รายใดประกาศ
- เข้าใจหน้าที่ของ bot ผิด — เช่น เขียนว่า GPTBot หรือ ClaudeBot คือ bot ค้นหา หรือ Google-Extended คุม AI Overviews
- robots.txt ตอบเป็นหน้า firewall — ตามมาตรฐาน robots.txt ที่ตอบ 403 แปลว่าไม่มีข้อห้าม แต่ firewall ตัวเดียวกันมักบล็อกหน้าเว็บด้วย bot จึงเข้าไม่ได้ทั้งเว็บ
เว็บไทยตั้งค่า AI bot กันแค่ไหน
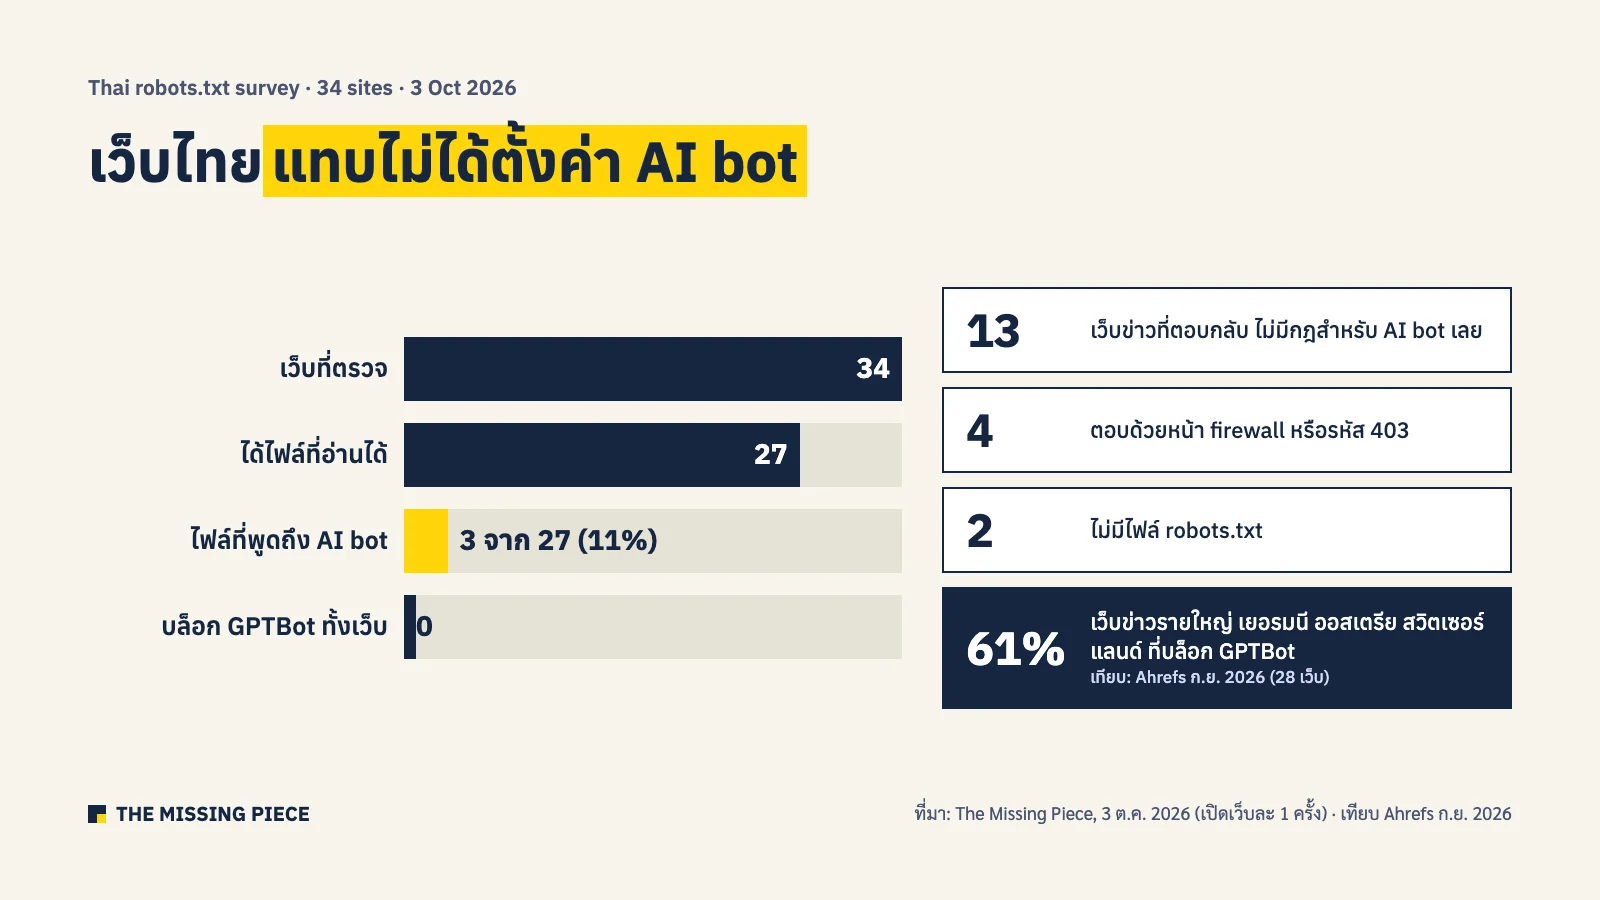
น้อยมาก เราตรวจ robots.txt ของเว็บไทย 34 เว็บ (3 ต.ค. 2026, เปิดเว็บละ 1 ครั้ง) ได้ไฟล์ที่อ่านได้ 27 ไฟล์ มีเพียง 3 ไฟล์ (11%) ที่พูดถึง AI bot และไม่มีเว็บไหนบล็อก GPTBot ทั้งเว็บ เว็บข่าวและสื่อไทยทั้ง 13 เว็บที่ตอบกลับไม่มีกฎสำหรับ AI bot เลย เทียบกับงานวิจัยของ Ahrefs (ก.ย. 2026) ที่พบว่าเว็บข่าวรายใหญ่ในเยอรมนี ออสเตรีย และสวิตเซอร์แลนด์ 61% (จาก 28 เว็บ) บล็อก GPTBot
- 4 เว็บตอบกลับด้วยหน้า firewall หรือรหัส 403 แทนไฟล์ robots.txt
- 2 เว็บไม่มีไฟล์ robots.txt (bot เข้าได้ทุกหน้า)
- 1 เว็บเปิดไม่ได้ภายในเวลาที่กำหนด (timeout)
- ข้อจำกัด: ตัวอย่างเล็ก และเราเปิดด้วยเครื่องมือของเรา ไม่ใช่ bot จริง bot ที่มาจาก IP ทางการอาจได้ผลต่างกัน
ตั้ง robots.txt ถูกแล้ว ทำไม AI ยังเข้าไม่ได้
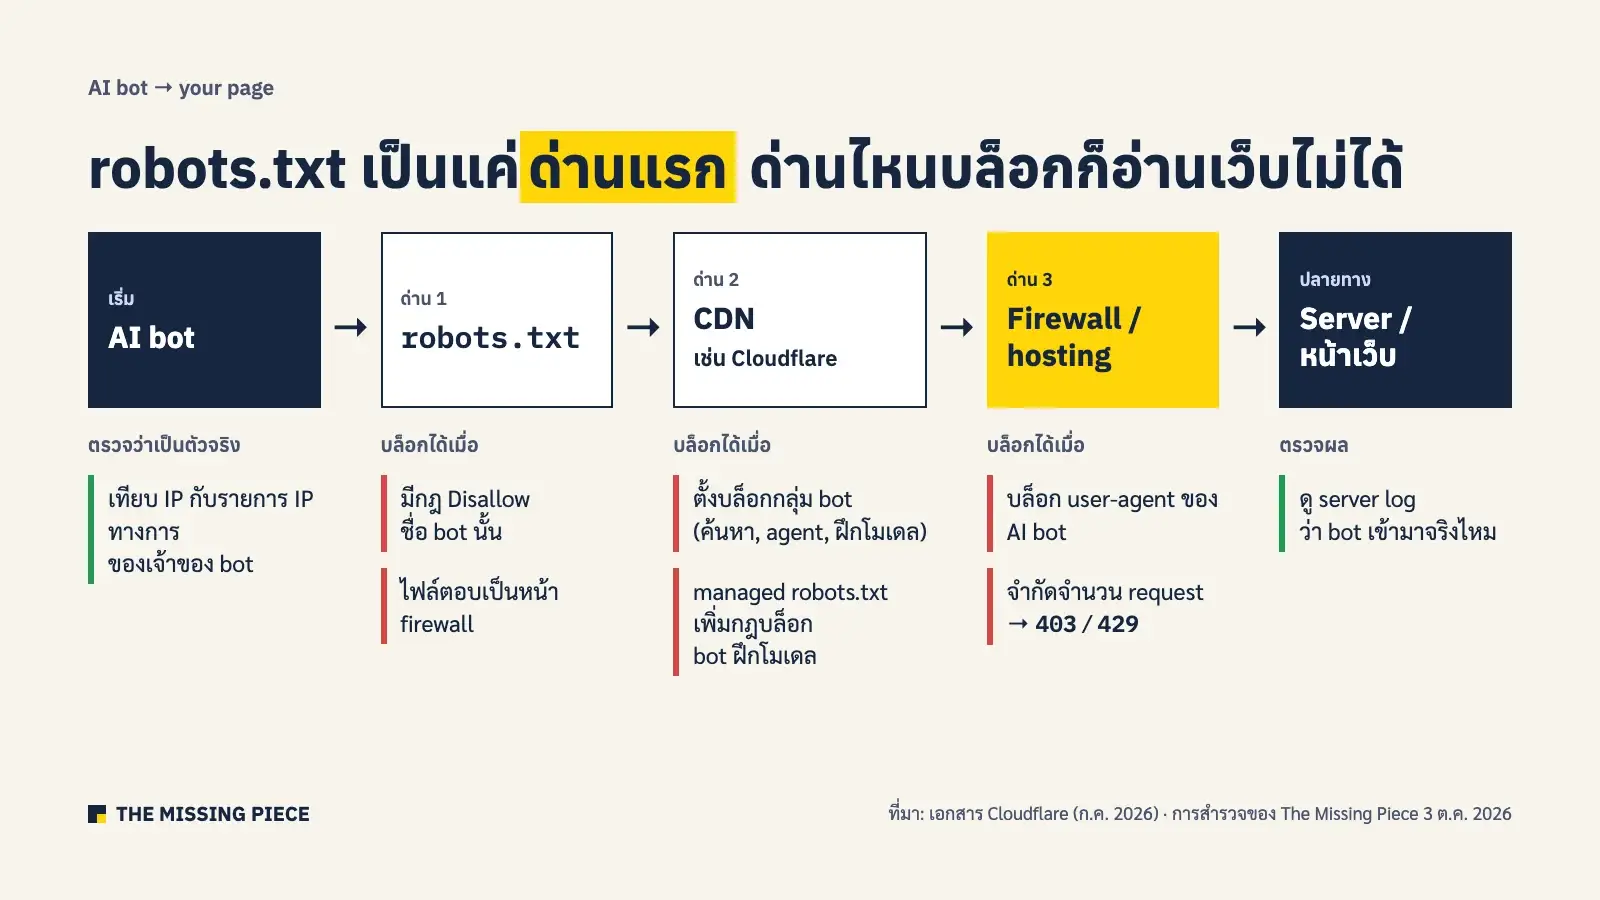
เพราะ robots.txt เป็นแค่ด่านแรก ก่อนถึงหน้าเว็บ bot ยังต้องผ่าน CDN (เครือข่ายส่งเนื้อหา เช่น Cloudflare), firewall และการจำกัดจำนวน request ของ hosting ถ้าด่านใดบล็อก bot ก็อ่านเว็บไม่ได้แม้ robots.txt จะเปิดไว้ ในการสำรวจของเรา 4 จาก 34 เว็บไทยตอบกลับด้วยหน้า firewall หรือรหัส 403 ตั้งแต่ขั้นเปิดไฟล์ robots.txt
- Cloudflare: มีการตั้งค่าแยกกลุ่ม bot เป็น ค้นหา, agent และฝึกโมเดล (เอกสาร Cloudflare ก.ค. 2026) และมีตัวเลือก managed robots.txt (ปิดไว้เป็นค่าเริ่มต้น) ที่เมื่อเปิดแล้วจะเพิ่มกฎบล็อก bot ฝึกโมเดลไว้หน้าไฟล์ของคุณ และตั้งแต่ 15 ก.ย. 2026 โดเมนใหม่จะบล็อก bot กลุ่มฝึกโมเดลและ agent บนหน้าที่มีโฆษณาเป็นค่าเริ่มต้น ให้ตรวจในแดชบอร์ดว่าตั้งไว้แบบที่ต้องการ
- Firewall และ hosting: ตรวจว่าไม่ได้บล็อก user-agent ของ AI bot หรือจำกัดจำนวน request จน bot ได้รหัส 403 หรือ 429
- ตรวจด้วย log: ดู server log ว่า bot เข้ามาจริงไหม และเทียบ IP กับรายการ IP ทางการของเจ้าของ bot เพราะมีคนปลอมชื่อ bot ได้
เราเริ่มบันทึกการเปิดไฟล์ robots.txt และ llms.txt ของ The Missing Piece ตั้งแต่ 3 ต.ค. 2026 เพื่อดูว่า AI bot ตัวไหนเข้ามาจริงและเข้ามาเมื่อไร และยืนยันว่าเป็น bot ตัวจริงด้วยการตรวจ IP เทียบรายการ IP ทางการที่ OpenAI, Anthropic, Perplexity, Google, Bing และ Apple เผยแพร่ ตอนที่มีการเรียกไฟล์ โดยไม่เก็บ IP ไว้ ส่วน bot ของ Meta และ Amazon ระบบของเรายังยืนยันตัวตนไม่ได้ จึงนับตาม user-agent (ชื่อที่ bot บอกตัวเอง) ซึ่งปลอมได้ ข้อจำกัด: นับเฉพาะ 2 ไฟล์นี้ เราจะอัปเดตผลในบทความนี้เมื่อครบ 30 และ 90 วัน
ถึงทุกด่านจะเปิดแล้ว AI bot บางตัวก็ยังอาจไม่เห็นเนื้อหาที่ต้องรอ JavaScript ทำงานก่อนจะโผล่ ในงานวัดของ Vercel ร่วมกับ MERJ (17 ธ.ค. 2024) GPTBot, ClaudeBot และ PerplexityBot ไม่รัน JavaScript ตอนวัด ส่วน Googlebot และ Bingbot render ได้ตามเอกสารของ Google และ Bing และ Apple ระบุว่า Applebot “อาจ” render โดย OpenAI, Anthropic และ Perplexity ยังไม่ได้ยืนยันเรื่องนี้ในเอกสารของตัวเอง (ตรวจ 16 ต.ค. 2026) ถ้าเนื้อหา ราคา หรือลิงก์สำคัญโหลดด้วย JavaScript ให้ดูตาราง bot แต่ละตัวและวิธีเทียบ HTML ดิบกับหน้าที่ render ที่ บอท AI ตัวไหน render JavaScript
แก้ robots.txt บน WordPress และตรวจผล
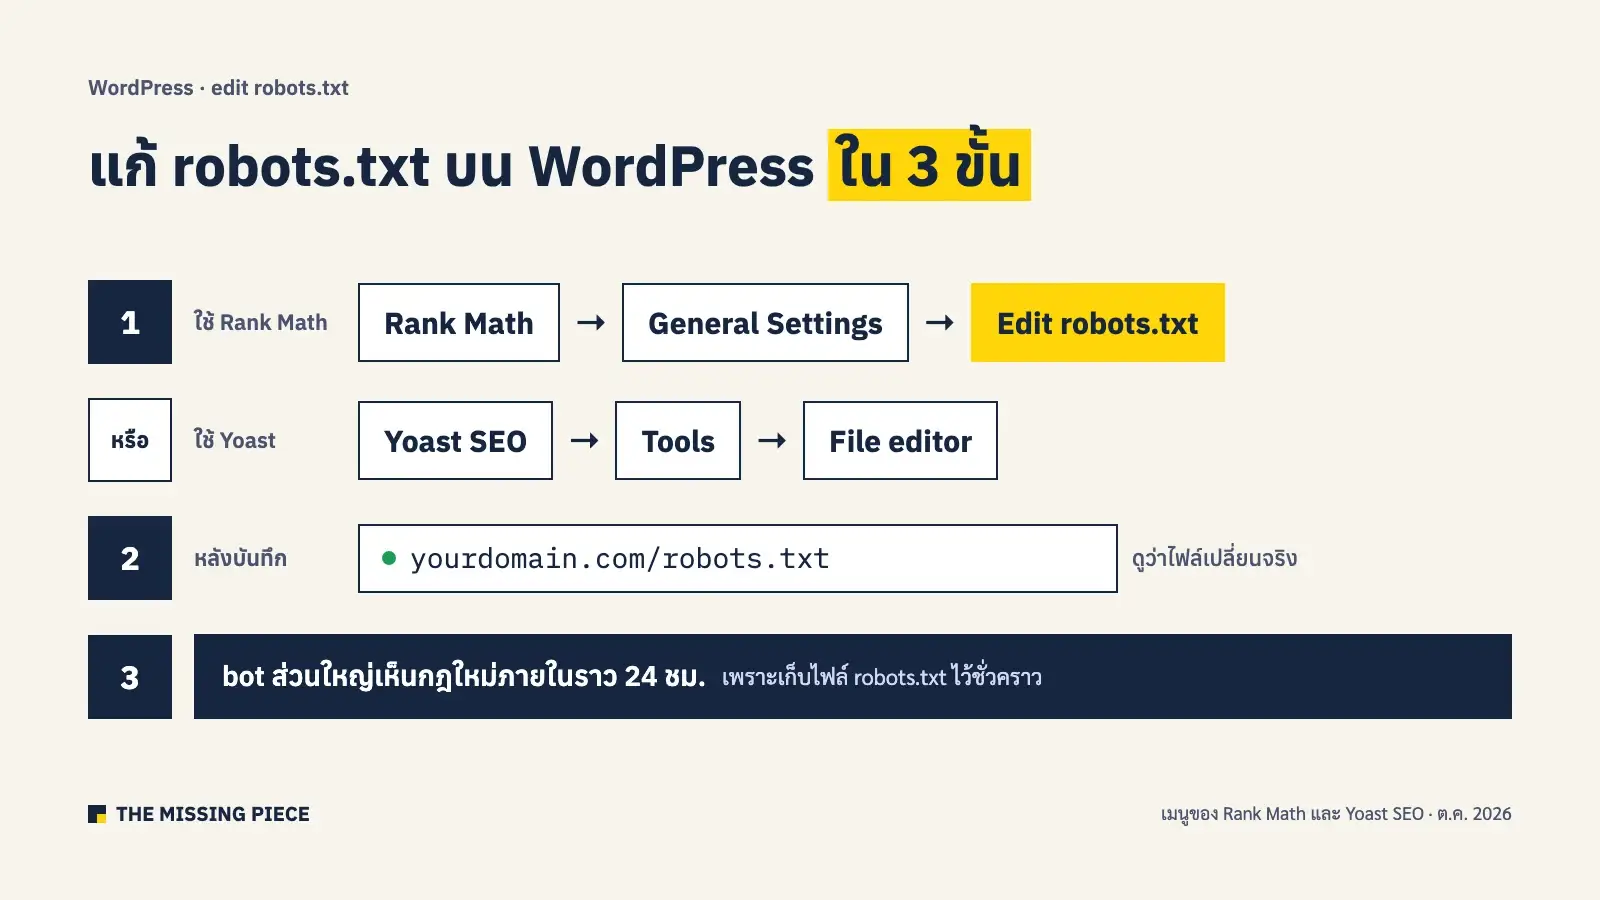
ถ้าใช้ Rank Math แก้ได้ที่ Rank Math → General Settings → Edit robots.txt ถ้าใช้ Yoast แก้ได้ที่ Yoast SEO → Tools → File editor หลังบันทึก ให้เปิด yourdomain.com/robots.txt เพื่อดูว่าไฟล์เปลี่ยนจริง bot ส่วนใหญ่จะเห็นกฎใหม่ภายในราว 24 ชั่วโมง เพราะเก็บไฟล์ robots.txt ไว้ชั่วคราว ถ้ามีไฟล์ robots.txt จริงอยู่ในโฟลเดอร์หลักของเว็บ ปลั๊กอินจะแก้ไม่ได้ ต้องแก้ไฟล์นั้นผ่าน hosting แทน หลักการเขียน robots.txt และ meta robots พื้นฐานดูเพิ่มได้ใน The Art of SEO บทที่ 7 ส่วนรายชื่อ AI bot ต้องดูจากเอกสารปัจจุบันของเจ้าของ bot เพราะหนังสือเขียนก่อนยุค AI bot เปิดให้ bot อ่านได้แล้ว ขั้นต่อไปดูที่AI SEO ทำยังไง ทีละขั้น
robots.txt เป็นข้อแรกของหมวด “เปิดบ้านรับบอท” ใน AI-Ready Website ตัวอย่างไฟล์และ checklist ทั้ง 31 ข้อดาวน์โหลดได้ใน AI Search Starter Kit และถ้าสงสัยเรื่อง llms.txt อ่านต่อที่ llms.txt คืออะไร ต้องทำไหม เมื่อเปิดทางให้ bot แล้ว ขั้นต่อไปคือทำเนื้อหาตาม checklist เนื้อหาที่ AI อ้างอิงได้ หรือ เรียน AI Search กับ The Missing Piece หรือคอร์ส Agentic SEO & AI Search แบบลงมือทำ 2 วัน หรือคอร์ส Agentic SEO & AI Search แบบลงมือทำ 2 วัน หรือคอร์ส Agentic SEO & AI Search แบบลงมือทำ 2 วัน
คำถามที่พบบ่อย
ถ้าไม่มีไฟล์ robots.txt เลย AI bot เข้าได้ไหม
เข้าได้ทุกหน้า ตามมาตรฐาน robots.txt ถ้าไฟล์ตอบรหัส 404 bot จะถือว่าไม่มีข้อห้าม แต่ถ้าเซิร์ฟเวอร์ตอบรหัส 5xx หรือเปิดไม่ได้ bot จะถือว่าห้ามทั้งเว็บ
AI bot ทุกตัวทำตาม robots.txt ไหม
ไม่ทุกตัว bot ฝึกโมเดลและ bot ค้นหาของบริษัทใหญ่ระบุว่าทำตาม แต่ bot ที่เปิดหน้าตามคำสั่งผู้ใช้ เช่น ChatGPT-User และ Perplexity-User ระบุว่าอาจไม่ทำตาม ส่วน Claude-User ของ Anthropic ระบุว่าทำตาม
มีคนปลอมเป็น GPTBot ได้ไหม ตรวจยังไง
ปลอมได้ เพราะ user-agent เป็นแค่ข้อความ ให้ตรวจ IP ใน server log กับรายการ IP ทางการที่ OpenAI, Anthropic, Perplexity และ Google เผยแพร่ ถ้า IP ไม่ตรง แปลว่าไม่ใช่ bot จริง
แก้ robots.txt แล้วนานแค่ไหนมีผล
ส่วนใหญ่ภายในราว 24 ชั่วโมง OpenAI ระบุว่า OAI-SearchBot ใช้เวลาประมาณ 24 ชั่วโมง และ Meta ระบุว่าไม่เกิน 24 ชั่วโมง ส่วนการหายจากคำตอบที่ AI แสดงไปแล้วอาจใช้เวลานานกว่า
Bing และ Copilot คุมยังไง
Copilot ใช้ข้อมูลจาก Bingbot จึงคุมผ่าน robots.txt ของ Bingbot หรือใช้ meta NOARCHIVE เพื่อไม่ให้เนื้อหาถูกใช้ในคำตอบของ Copilot และ NOCACHE เพื่อให้แสดงแค่ URL หัวเรื่อง และ snippet ตามแนวทางผู้ดูแลเว็บของ Bing (ก.พ. 2026)
robots.txt กับ llms.txt ต่างกันยังไง
robots.txt บอกว่า bot ตัวไหนเข้าหน้าไหนได้ และเป็นมาตรฐานที่ bot หลักทำตาม ส่วน llms.txt เป็นข้อเสนอให้สรุปเนื้อหาสำคัญของเว็บให้ AI อ่าน ไม่ได้ใช้ห้ามหรืออนุญาต bot และ Google ระบุว่าไม่ต้องสร้างไฟล์ข้อความสำหรับ AI เพื่อแสดงใน AI Overviews
แหล่งอ้างอิง
- OpenAI, Overview of OpenAI crawlers (ตรวจ 3 ต.ค. 2026)
- Anthropic, Does Anthropic crawl data from the web, and how can site owners block the crawler?
- Perplexity, Perplexity crawlers
- Google Search Central, Google’s common crawlers (อัปเดต 14 ก.ค. 2026), Google user-triggered fetchers และ AI features and your website
- Microsoft Bing, Bing Webmaster Guidelines (ปรับปรุง 27 ก.พ. 2026, สรุปโดย Search Engine Journal)
- Apple, About Applebot · Meta, Meta Web Crawlers · Common Crawl, CCBot
- IETF, RFC 9309 Robots Exclusion Protocol (2022)
- Eric Enge, Stephan Spencer และ Jessie Stricchiola, The Art of SEO ฉบับที่ 4 (O’Reilly, 2023), บทที่ 7
- Cloudflare Docs, AI Crawl Control และ managed robots.txt (อัปเดต ก.ค.–ส.ค. 2026)
- Ahrefs, การศึกษาการบล็อก AI bot ของเว็บในเยอรมนี ออสเตรีย และสวิตเซอร์แลนด์ (18 ก.ย. 2026, สุ่ม 24,550 host + เว็บใหญ่ 57 เว็บ)
- PPC Land, รายงาน TollBit H1 2026 (ส.ค. 2026)
- The Missing Piece, สำรวจ robots.txt เว็บไทย 34 เว็บ (3 ต.ค. 2026)
- Nathan Gotch, AI SEO For Dummies (Wiley, 2026), บทที่ 2, 10, 22
อัปเดต 3 ต.ค. 2026: เขียนใหม่ทั้งบทความ เพิ่มตาราง AI bot 9 บริษัท ผลสำรวจเว็บไทย และตัวอย่าง robots.txt ที่แก้เรื่องกลุ่ม * แล้ว · ผลทดสอบ server log จะอัปเดตเมื่อครบ 30 และ 90 วัน