สรุปสั้น (TL;DR)
403 Forbidden คือรหัสสถานะ HTTP ที่เซิร์ฟเวอร์ตอบว่า “ได้รับคำขอแล้ว แต่ไม่อนุญาตให้เข้า” ปัญหาจึงอยู่ที่สิทธิ์หรือกฎความปลอดภัย ไม่ใช่หน้าหาย ถ้าคุณเป็นคนเข้าเว็บ ทางที่ทำได้มีไม่กี่อย่าง เช่น ล็อกอิน ปิด VPN หรือเปลี่ยนเครือข่าย ถ้าคุณเป็นเจ้าของเว็บ ให้หาก่อนว่า 403 มาจากชั้นไหน (CDN หรือ WAF, firewall ของโฮสต์, เว็บเซิร์ฟเวอร์ หรือปลั๊กอิน) แล้วแก้ที่ชั้นนั้น
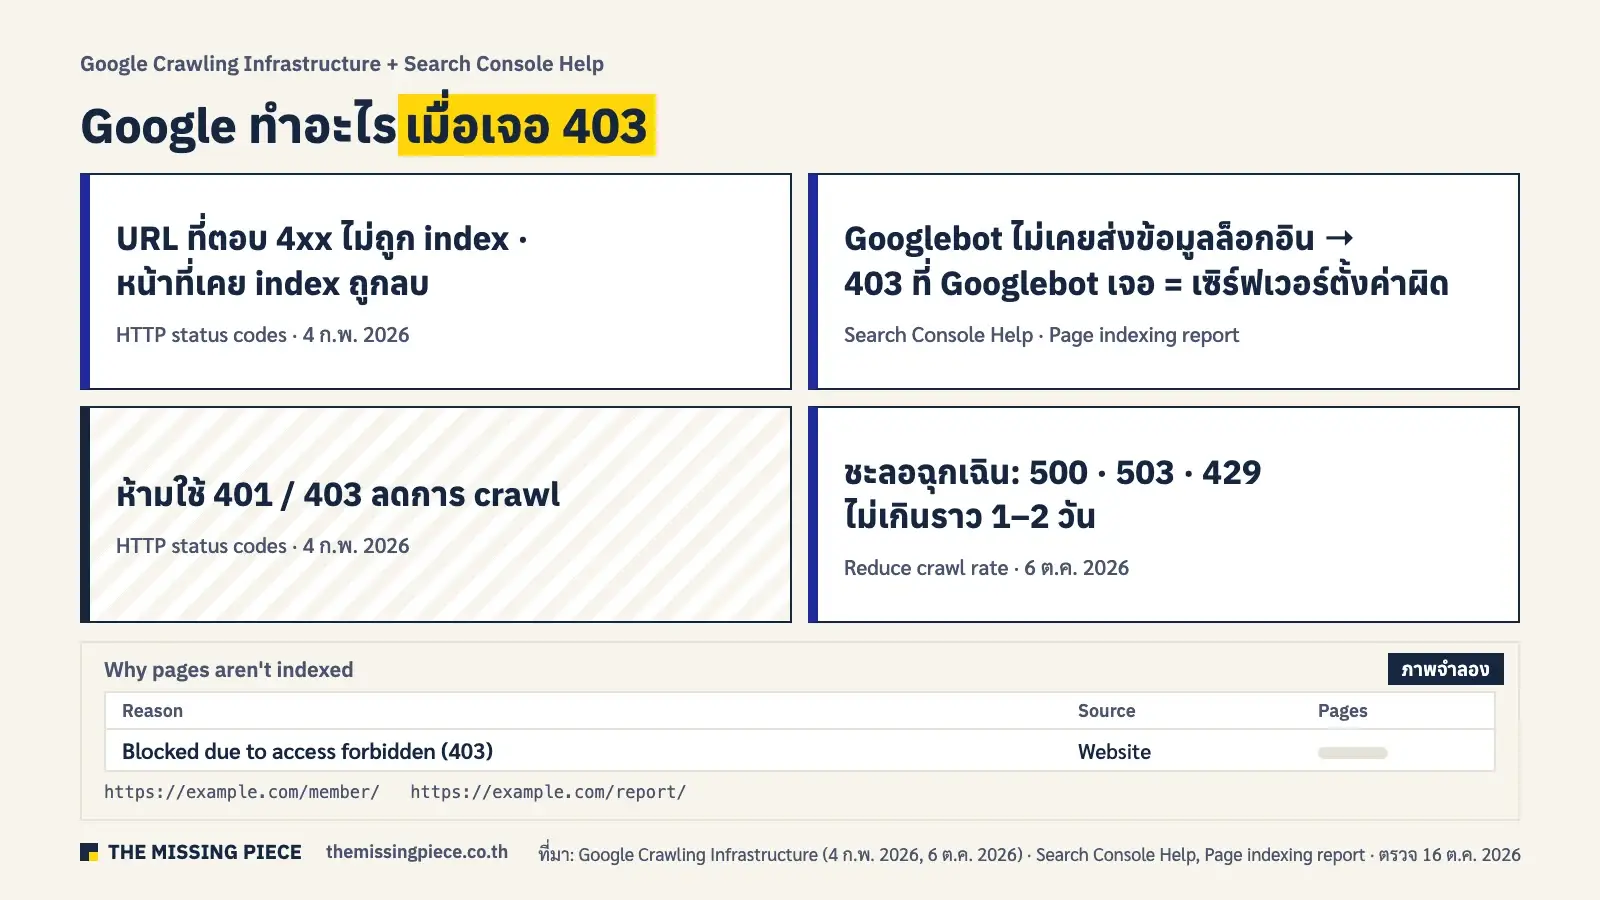
- 403 ที่ Googlebot เจอทำให้หน้าหลุดจาก Google: เอกสาร HTTP status codes ของ Google (ปรับล่าสุด 4 ก.พ. 2026) บอกว่า URL ที่ตอบ 4xx จะไม่ถูก index และหน้าที่เคย index จะถูกลบออก Search Console Help ยังบอกว่า Googlebot ไม่เคยส่งข้อมูลล็อกอิน 403 ที่ Googlebot เจอจึงเป็นการตั้งค่าที่ผิดของเซิร์ฟเวอร์
- อย่าใช้ 403 ลดการ crawl: Google เขียนไว้ตรงๆ ว่าห้ามใช้ 401 และ 403 เพื่อจำกัดอัตราการ crawl ถ้าต้องชะลอ Googlebot ฉุกเฉิน ให้ตอบ 500, 503 หรือ 429 ชั่วคราว และไม่ควรนานเกินราว 1–2 วัน (เอกสาร Reduce crawl rate ปรับล่าสุด 6 ต.ค. 2026)
- Firewall บล็อกบอต AI ได้ แม้ robots.txt อนุญาต: ผลเบื้องต้นของเรา (16 ต.ค. 2026, หน้าแรกของเว็บไทยขนาดใหญ่ 20 เว็บ, ทดสอบด้วย user agent ครั้งเดียว) ใน 14 เว็บที่เปิดให้เบราว์เซอร์เข้าได้ มี 2 เว็บที่ตอบ 403 หรือ 402 ให้บอตค้นหาของ AI ทั้งที่ robots.txt ไม่ได้ห้ามบอตเหล่านี้เข้าหน้าแรกเลย
สารบัญ
403 Forbidden คืออะไร (HTTP 403 แปลว่าอะไร)
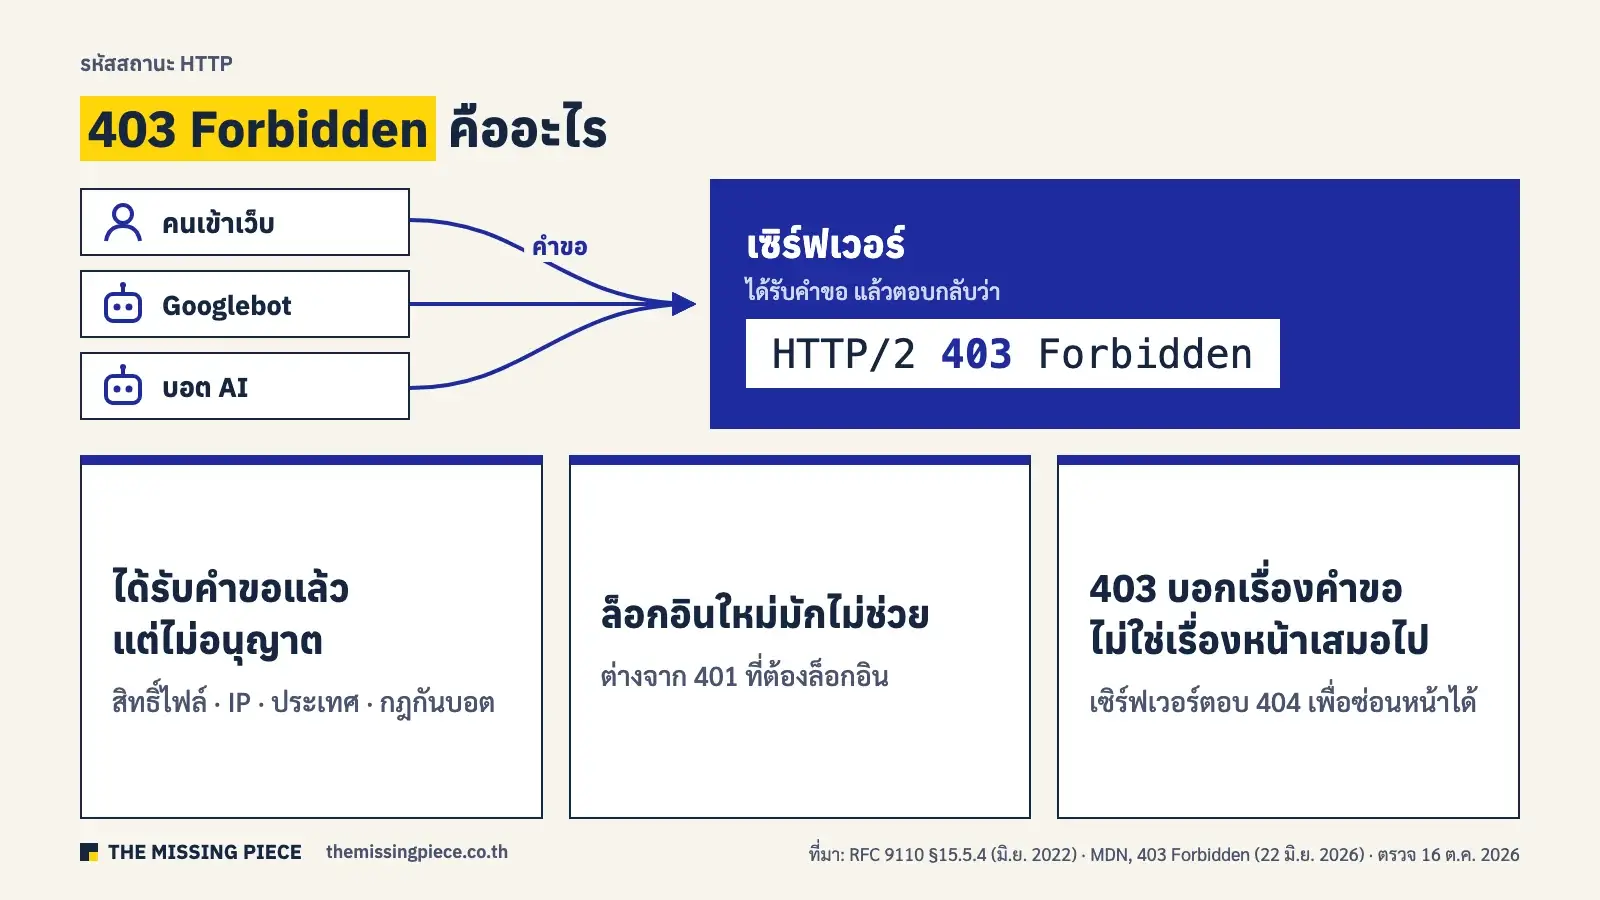
403 Forbidden คือรหัสสถานะ HTTP 403 (HTTP status code ตัวเลข 3 หลักที่เซิร์ฟเวอร์ส่งกลับทุกครั้งที่มีคนขอเปิดหน้า) ที่แปลว่า “เซิร์ฟเวอร์เข้าใจคำขอแล้ว แต่ปฏิเสธไม่ให้เข้า” คำว่า forbidden คือ “ห้าม” ข้อความ Error 403, 403 error และ HTTP 403 จึงหมายถึงสิ่งเดียวกัน คนที่เปิดเว็บ เจ้าของเว็บ Googlebot (บอตเก็บข้อมูลของ Google) และบอตของ AI เจอรหัสนี้ได้เหมือนกัน แต่สาเหตุและทางแก้ของแต่ละฝ่ายไม่เหมือนกัน
มาตรฐาน HTTP ฉบับปัจจุบัน RFC 9110 (มิ.ย. 2022) ข้อ 15.5.4 อธิบายว่า 403 คือเซิร์ฟเวอร์เข้าใจคำขอแต่ไม่ยอมทำตาม และอาจบอกเหตุผลไว้ในหน้าที่ตอบกลับ ถ้าผู้ขอส่งข้อมูลยืนยันตัวตนมาแล้ว แปลว่าสิทธิ์นั้นไม่พอ แต่คำขออาจถูกห้ามด้วยเหตุผลที่ไม่เกี่ยวกับการล็อกอินเลยก็ได้ (ตัวอย่างในทางปฏิบัติคือ IP ประเทศ หรือกฎกันบอต) MDN (ปรับล่าสุด 22 มิ.ย. 2026) สรุปไว้ในทางเดียวกันว่าการล็อกอินใหม่ไม่ช่วย และถ้าส่งคำขอเดิมซ้ำโดยไม่เปลี่ยนอะไร ผลก็จะเหมือนเดิม
บนหน้าจอ 403 มีหลายหน้าตาตามว่าใครเป็นคนตอบ เว็บที่ใช้ Apache มักขึ้นคำว่า “Forbidden” ตามด้วย “You don’t have permission to access this resource” เว็บที่ใช้ Nginx มักขึ้น “403 Forbidden” และมีคำว่า nginx อยู่บรรทัดล่าง ถ้าเป็น CDN (เครือข่ายเซิร์ฟเวอร์ที่ส่งเว็บจากจุดใกล้ผู้ใช้ และมักมีระบบกันบอต) หรือ WAF (Web Application Firewall ระบบกรองคำขอก่อนถึงเว็บ) มักเป็นหน้า “Access denied” หรือหน้าให้ยืนยันว่าคุณไม่ใช่บอต ส่วนปลั๊กอินความปลอดภัยของ WordPress จะแสดงหน้าล็อกในธีมของเว็บเอง หน้าตาเหล่านี้คือเบาะแสแรกว่า 403 มาจากชั้นไหน ซึ่งจะอธิบายในหัวข้อหาชั้นที่ตอบ 403
มีข้อที่บทความหลายแห่งเขียนเกินจริง คือ “403 แปลว่าหน้ามีอยู่ แค่คุณไม่มีสิทธิ์ดู” ข้อนี้ไม่จริงเสมอไป RFC 9110 อนุญาตให้เซิร์ฟเวอร์ตอบ 404 แทน 403 เพื่อซ่อนว่าหน้านั้นมีอยู่ และกฎของ WAF หลายแบบตอบ 403 ให้ทุก URL ของเว็บ ไม่ว่าหน้านั้นจะมีอยู่หรือไม่ 403 จึงบอกเรื่องของ “คำขอ” (ใคร มาจากไหน ส่งอะไรมา) มากกว่าเรื่องของ “หน้า”
ถ้าคุณแค่เจอ 403 ตอนเข้าเว็บคนอื่น ลองทำตามนี้:
- ดู URL ว่าลงท้ายด้วยชื่อโฟลเดอร์หรือ path ที่ไม่ใช่หน้าปกติหรือเปล่า ลองเข้าหน้าแรกของเว็บแล้วกดเมนูไปแทน
- ถ้าเป็นหน้าสมาชิก ให้ล็อกอินด้วยบัญชีที่มีสิทธิ์ ถ้าล็อกอินแล้วยังขึ้น 403 แปลว่าบัญชีนั้นไม่มีสิทธิ์ ไม่ใช่รหัสผ่านผิด
- ปิด VPN หรือ proxy แล้วลองใหม่ หรือสลับระหว่าง Wi-Fi กับเน็ตมือถือ เพราะหลายเว็บบล็อกตาม IP หรือเครือข่าย
- ลบคุกกี้ของเว็บนั้น ลองหน้าต่างไม่ระบุตัวตน (incognito) หรือปิดส่วนขยายของเบราว์เซอร์ชั่วคราว
- ถ้าเพิ่งเปิดหลายหน้าติดกันเร็วๆ ให้รอสักพักแล้วค่อยลองใหม่ บางเว็บบล็อกชั่วคราวเมื่อเห็นคำขอถี่
- ถ้ายังไม่ได้ ให้แจ้งเจ้าของเว็บพร้อมเวลาที่เจอ และรหัสอ้างอิงบนหน้า (ถ้ามี เช่น Ray ID)
กดรีเฟรชหรือล้างแคชมักไม่ช่วย เพราะ 403 เป็นการตัดสินของเซิร์ฟเวอร์ และถ้าเว็บตั้งใจบล็อกประเทศหรือเครือข่ายของคุณ ฝั่งคุณไม่มีทางแก้ที่ถูกต้อง ส่วนที่เหลือของบทความนี้เขียนสำหรับเจ้าของเว็บและคนทำ SEO & AI Search
403 ต่างจาก 401, 404, 410, 429 และ 5xx ยังไง (401 vs 403)
403 ต่างจาก 401 ตรงที่ 401 Unauthorized แปลว่า “ยังไม่ได้ยืนยันตัวตน” ส่วน 403 แปลว่า “ไม่อนุญาต” ไม่ว่าคุณจะเป็นใคร 401 คือหน้าที่ต้องล็อกอินก่อน และ RFC 9110 ข้อ 15.5.2 กำหนดให้เซิร์ฟเวอร์ที่ตอบ 401 ต้องส่ง header WWW-Authenticate บอกวิธียืนยันตัวตนมาด้วย ส่วน 403 ล็อกอินแล้วก็อาจยังเข้าไม่ได้ ตารางนี้เทียบรหัสที่คนมักสับสนกับ 403 พร้อมสิ่งที่ Google ทำกับแต่ละรหัส
| รหัส | ความหมาย | ล็อกอินช่วยไหม | ใครต้องแก้ | Google ทำอะไร |
|---|---|---|---|---|
| 401 Unauthorized | ต้องยืนยันตัวตนก่อน | ช่วย ถ้าบัญชีมีสิทธิ์ | คนเข้าเว็บล็อกอิน หรือเจ้าของเว็บ ถ้าหน้านั้นไม่ควรต้องล็อกอิน | ไม่ index · Search Console แจ้ง “Blocked due to unauthorized request (401)” |
| 403 Forbidden | เข้าใจคำขอแต่ไม่อนุญาต | มักไม่ช่วย | เจ้าของเว็บ (สิทธิ์ไฟล์ กฎ firewall CDN ปลั๊กอิน) | ไม่ index และลบหน้าที่เคย index · Search Console แจ้ง “Blocked due to access forbidden (403)” |
| 404 Not Found | ไม่พบหน้า | ไม่ช่วย | เจ้าของเว็บ ถ้าหน้าควรมีอยู่ | ไม่ index · ดูรายละเอียดใน Error 404 คืออะไร |
| 410 Gone | ลบถาวร | ไม่ช่วย | ไม่ต้องแก้ ถ้าตั้งใจลบ | ปฏิบัติเหมือน 404 |
| 429 Too Many Requests | ขอถี่เกินไป | ไม่ช่วย ต้องรอ | ผู้ส่งคำขอลดความถี่ หรือเจ้าของเว็บปรับ rate limit (จำกัดจำนวนคำขอต่อช่วงเวลา) | ถือเป็นสัญญาณว่าเซิร์ฟเวอร์รับไม่ไหว เหมือน 5xx แล้วชะลอการ crawl |
| 5xx เช่น 500, 503 | เซิร์ฟเวอร์ผิดพลาดหรือไม่พร้อม | ไม่ช่วย | เจ้าของเว็บหรือผู้ให้บริการเซิร์ฟเวอร์ | ชะลอการ crawl ถ้าเป็นต่อเนื่องนาน URL จะหลุดจาก index |
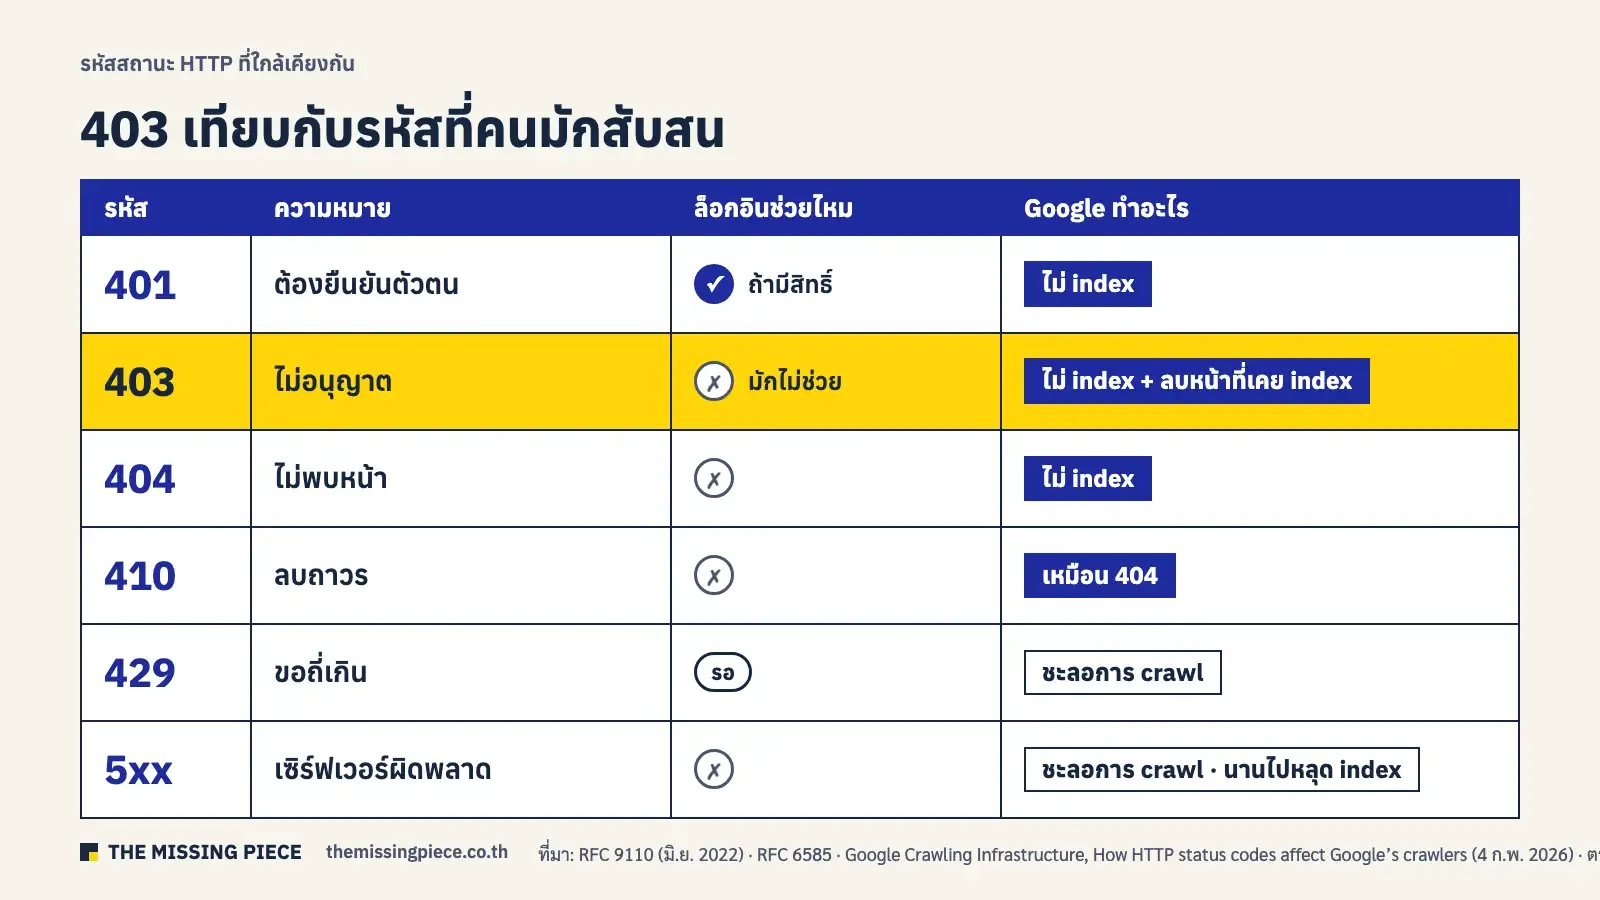
403 กับ 404 ต่างกันที่เหตุผล ไม่ใช่ผลกับ Google เพราะทั้งคู่อยู่ในตระกูล 4xx ที่ Google ไม่ index เหมือนกัน ความต่างที่สำคัญกับเจ้าของเว็บคือ 404 มักเกิดจากหน้าหายหรือลิงก์ผิด ส่วน 403 เกิดจากกฎที่ใครสักคนตั้งไว้ และกฎนั้นอาจโดนหน้าที่คุณอยากให้ติดผลค้นหาโดยไม่ตั้งใจ ภาพรวมของรหัสสถานะทุกตระกูลอยู่ในบทความ Technical SEO คืออะไร
403 Forbidden เกิดจากอะไร (ฝั่งเจ้าของเว็บ)
403 Forbidden บนเว็บของคุณเกิดจากกฎข้อใดข้อหนึ่งบนทางที่คำขอวิ่งผ่าน ตัดสินว่าคำขอนั้น “ไม่ควรได้” กฎอาจอยู่ที่ไฟล์บนเซิร์ฟเวอร์ ในปลั๊กอิน ใน firewall ของโฮสต์ หรือใน CDN ที่อยู่หน้าสุด สาเหตุที่พบบ่อยมี 9 แบบ แต่ละแบบมีอาการที่ช่วยเดาได้ว่าต้องไปดูที่ชั้นไหน
| สาเหตุ | อาการที่มักเห็น | ชั้นที่ตอบ |
|---|---|---|
| สิทธิ์ไฟล์หรือโฟลเดอร์ผิด หรือเจ้าของไฟล์ผิด | ขึ้น 403 หลังอัปโหลดไฟล์ใหม่ ย้ายโฮสต์ หรือกู้คืนจาก backup | เว็บเซิร์ฟเวอร์ |
| โฟลเดอร์ไม่มีไฟล์ index และปิดการแสดงรายการไฟล์ (directory listing) | เปิด URL ที่ลงท้ายด้วยชื่อโฟลเดอร์แล้วขึ้น 403 | เว็บเซิร์ฟเวอร์ |
| กฎ deny ในไฟล์ .htaccess (Apache) หรือ config ของ Nginx | 403 ทั้งเว็บ หรือเฉพาะบาง path หลังมีคนแก้ไฟล์ | เว็บเซิร์ฟเวอร์ |
| ปลั๊กอินความปลอดภัยของ WordPress (บล็อกประเทศ ล็อกการล็อกอิน รายการบอตไม่ดี) | หน้า wp-admin หรือหน้าล็อกอินขึ้น 403 หรือบอตบางตัวโดนบล็อก | WordPress / ปลั๊กอิน |
| Firewall ของโฮสต์ เช่น กฎ ModSecurity | 403 ตอนส่งฟอร์ม บันทึกบทความที่มีโค้ด หรือ URL ที่มีอักขระแปลก | Firewall ของโฮสต์ |
| CDN หรือ WAF: กันบอต กฎประเทศหรือ IP จำกัดความถี่ บล็อกบอต AI | หน้าตรวจบอต เข้าไม่ได้เฉพาะบางเครือข่าย หรือเฉพาะบอต | CDN / WAF |
| Hotlink protection (กันเว็บอื่นดึงรูปไปใช้) | รูปไม่ขึ้นเมื่อแชร์บนโซเชียลหรือแอปแชต | เว็บเซิร์ฟเวอร์หรือ CDN |
| สิทธิ์ของที่เก็บไฟล์ต้นทาง (เช่น object storage ที่เก็บรูป) | ไฟล์บางชุด เช่น รูปหรือ PDF ขึ้น 403 แต่หน้าเว็บปกติ | Storage / CDN |
| พื้นที่สมาชิกหรือระบบหลังบ้าน | คนที่ไม่มีสิทธิ์ขึ้น 403 ตามที่ตั้งใจ | ปกติ ไม่ต้องแก้ |
เรื่องสิทธิ์ไฟล์ ค่าเริ่มต้นที่ใช้กันทั่วไปคือโฟลเดอร์ 755 และไฟล์ 644 (บางโฮสต์ตั้งต่างไปเล็กน้อย ให้ดูคู่มือของโฮสต์ประกอบ) อย่าแก้ด้วยการตั้ง 777 ตามที่บางกระทู้แนะนำ เพราะเท่ากับเปิดให้ใครก็เขียนไฟล์นั้นได้ 403 อาจหายแต่ความเสี่ยงที่เว็บจะถูกฝังโค้ดเพิ่มขึ้นมาก
มีความเชื่อ 2 ข้อที่เราเห็นในคำตอบ AI Overview ภาษาไทย (คำ “403 forbidden คือ” บนมือถือ เช็ก 16 ต.ค. 2026 ครั้งเดียว) ข้อแรกคือ “พิมพ์ URL ผิดทำให้เกิด 403” URL ที่พิมพ์ผิดโดยทั่วไปได้ 404 จะได้ 403 ก็ต่อเมื่อบังเอิญไปตรงกับโฟลเดอร์จริงที่ไม่มีไฟล์ index หรือ path ที่ถูกป้องกันไว้ ข้อที่สองคือ “รีเฟรชหรือล้างแคชแก้ 403 ได้” ซึ่งช่วยได้น้อยมาก ยกเว้นกรณีคุกกี้หรือ session ล็อกอินค้าง
ถ้า 403 เกิดหลังเพิ่งตั้ง redirect ให้เช็กว่าปลายทางของ redirect ไม่ได้เป็น path ที่ถูกบล็อก วิธีตั้ง redirect ให้ถูกอยู่ในบทความ 301 Redirect คืออะไร ส่วนกรณีรูปขึ้น 403 เพราะ hotlink protection ทำให้ภาพตัวอย่างลิงก์บนโซเชียลไม่ขึ้นด้วย อ่านเรื่องการดูแลรูปต่อที่ Image SEO
หาให้เจอก่อนว่า 403 มาจากชั้นไหน
การหาชั้นที่ตอบ 403 คือขั้นที่ประหยัดเวลาที่สุดของการแก้ เพราะคำขอหนึ่งครั้งวิ่งผ่านหลายชั้น และชั้นไหนก็ตอบ 403 ได้ ถ้าไปแก้สิทธิ์ไฟล์ทั้งที่ CDN เป็นคนบล็อก จะแก้เท่าไรก็ไม่หาย ลำดับปกติของคำขอคือ คนหรือบอต → CDN หรือ WAF → firewall ของโฮสต์ → เว็บเซิร์ฟเวอร์ → WordPress และปลั๊กอิน ชั้นที่อยู่หน้ากว่าตอบก่อน คำขอจะไม่ไปถึงชั้นหลัง
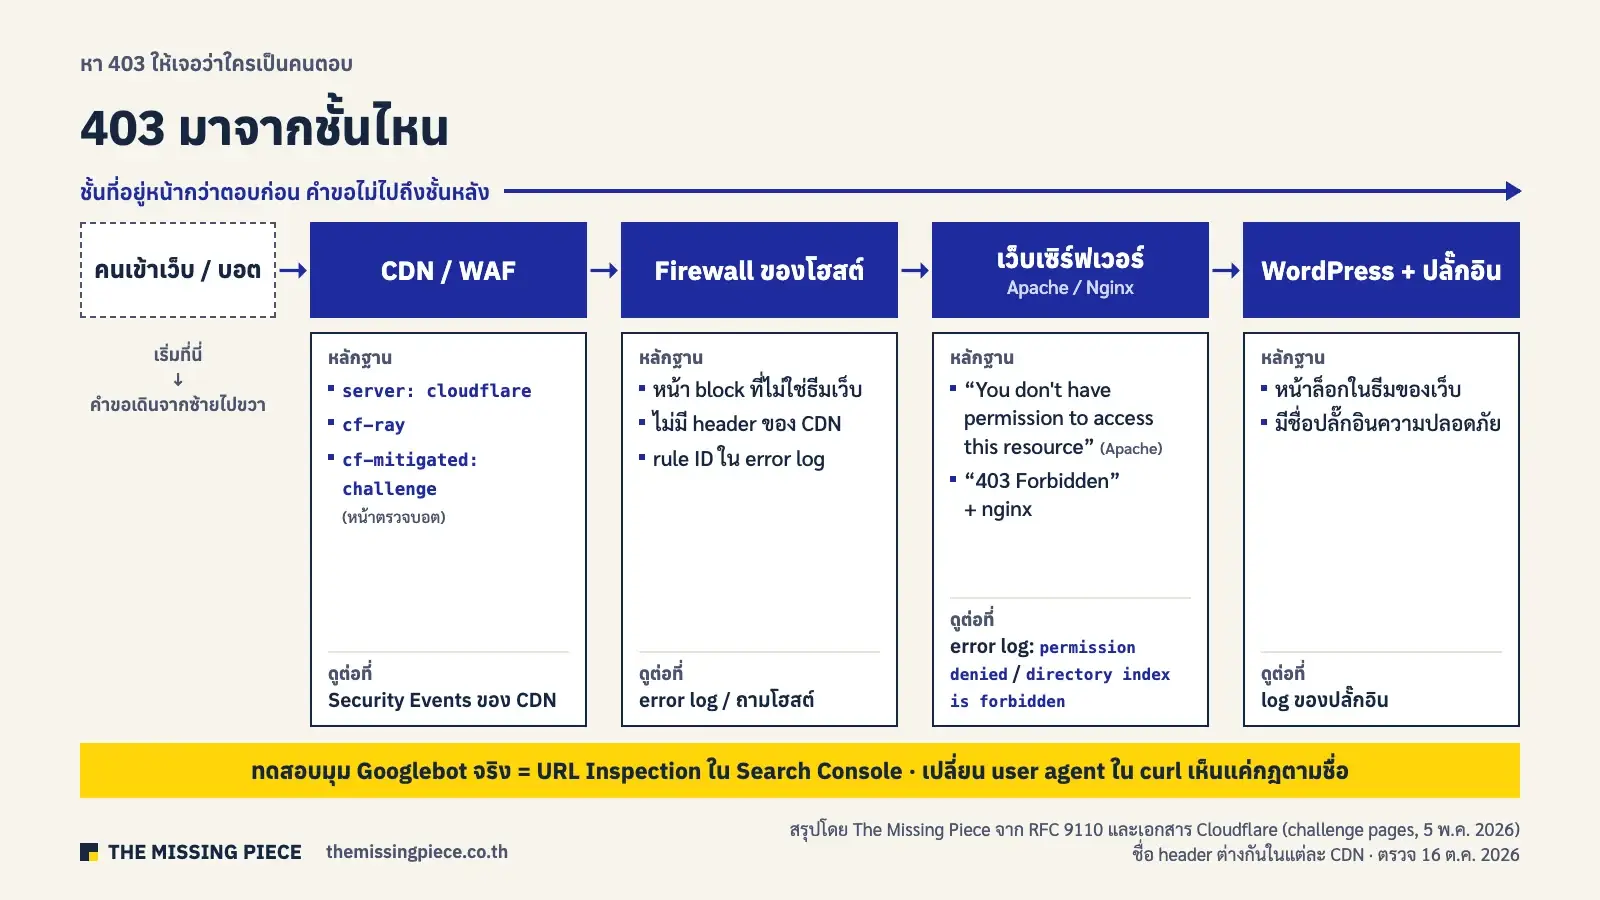
| ชั้น | หลักฐานว่าชั้นนี้ตอบ 403 | ดูต่อที่ไหน |
|---|---|---|
| CDN / WAF | header ของ CDN เช่น server: cloudflare และ cf-ray · cf-mitigated: challenge เมื่อเป็นหน้าตรวจบอต · หน้า block ที่มีชื่อ CDN และรหัสอ้างอิง | Security Events หรือ firewall log ในแดชบอร์ดของ CDN ค้นด้วยเวลาและ IP |
| Firewall ของโฮสต์ | หน้า block ที่ไม่ใช่ธีมเว็บและไม่มี header ของ CDN · รหัสกฎ (rule ID) ใน error log | error log ของเซิร์ฟเวอร์ หรือส่งเวลา URL และ IP ให้โฮสต์ตรวจ |
| เว็บเซิร์ฟเวอร์ | หน้าเปล่าของ Apache “You don’t have permission…” หรือ “403 Forbidden” + nginx · error log มักเขียนว่า permission denied หรือ directory index is forbidden | error log ของ Apache หรือ Nginx |
| WordPress / ปลั๊กอิน | หน้าล็อกที่อยู่ในธีมของเว็บ หรือมีชื่อปลั๊กอินความปลอดภัย | log หรือหน้ารายการ IP ที่ถูกบล็อกในปลั๊กอิน |
ขั้นตอนหาชั้นที่ตอบ ทำได้ตามลำดับนี้
- อ่าน header ด้วย curl: รันคำสั่งด้านล่างแล้วดูบรรทัดสถานะ และ header
server,cf-ray,cf-mitigatedเอกสาร Cloudflare (ปรับล่าสุด 5 พ.ค. 2026) บอกว่าหน้าตรวจบอตจะมี headercf-mitigated: challenge - เทียบจากเครือข่ายอื่น: ลองจากเน็ตมือถือ ล็อกอินและไม่ล็อกอิน ถ้าบางเครือข่ายเข้าได้บางเครือข่ายไม่ได้ มักเป็นกฎ IP หรือประเทศที่ CDN หรือ firewall
- หาคำขอนั้นใน log: ใช้เวลาและ IP ที่โดนบล็อกไปค้นใน Security Events ของ CDN, error log ของเซิร์ฟเวอร์ และ log ของปลั๊กอิน ชั้นที่มีบันทึกการบล็อกคือชั้นที่ต้องแก้
- ดูมุมของ Googlebot จริง: ใช้ URL Inspection แล้วกด Test live URL ใน Google Search Console เพราะเป็นทางที่ง่ายที่สุดที่จะเห็นคำตอบที่ Googlebot ตัวจริงได้รับ
curl -I https://example.com/page/
HTTP/2 403
server: cloudflare
cf-ray: 8a1b2c3d4e5f6789-BKK
cf-mitigated: challenge
ตัวอย่างคำตอบด้านบนเป็นภาพจำลองของกรณีที่ CDN ส่งหน้าตรวจบอต ถ้าไม่มี header ของ CDN และบรรทัด server เป็น Apache หรือ nginx ให้ไปดูที่เซิร์ฟเวอร์ต่อ
เปลี่ยน user agent ใน curl ไม่ได้ทำให้คุณเป็น Googlebot: การใส่ชื่อ Googlebot หรือ GPTBot ใน curl บอกได้แค่ว่าเว็บมีกฎตาม “ชื่อ” (user agent) หรือไม่ บอตตัวจริงถูกตัดสินจาก IP ด้วย The Art of SEO (4th ed., 2023) บทที่ 4 เตือนว่า log ของเซิร์ฟเวอร์บันทึก user agent ตามที่ผู้ขอ “อ้าง” บอตปลอมจึงดูเหมือนบอตจริงได้ และ John Mueller ของ Google ตอบในกระทู้ Reddit ที่ Search Engine Journal รายงาน (7 ม.ค. 2026) ว่าการบล็อก Googlebot ระดับ CDN หรือเซิร์ฟเวอร์มักเป็นการบล็อกระดับล่าง บางครั้งบล็อกตาม IP จึงแทบทดสอบจากภายนอกไม่ได้ นอกจากใช้เครื่องมือทดสอบใน Search Console
403 Forbidden แก้ยังไง (WordPress ทีละขั้น)
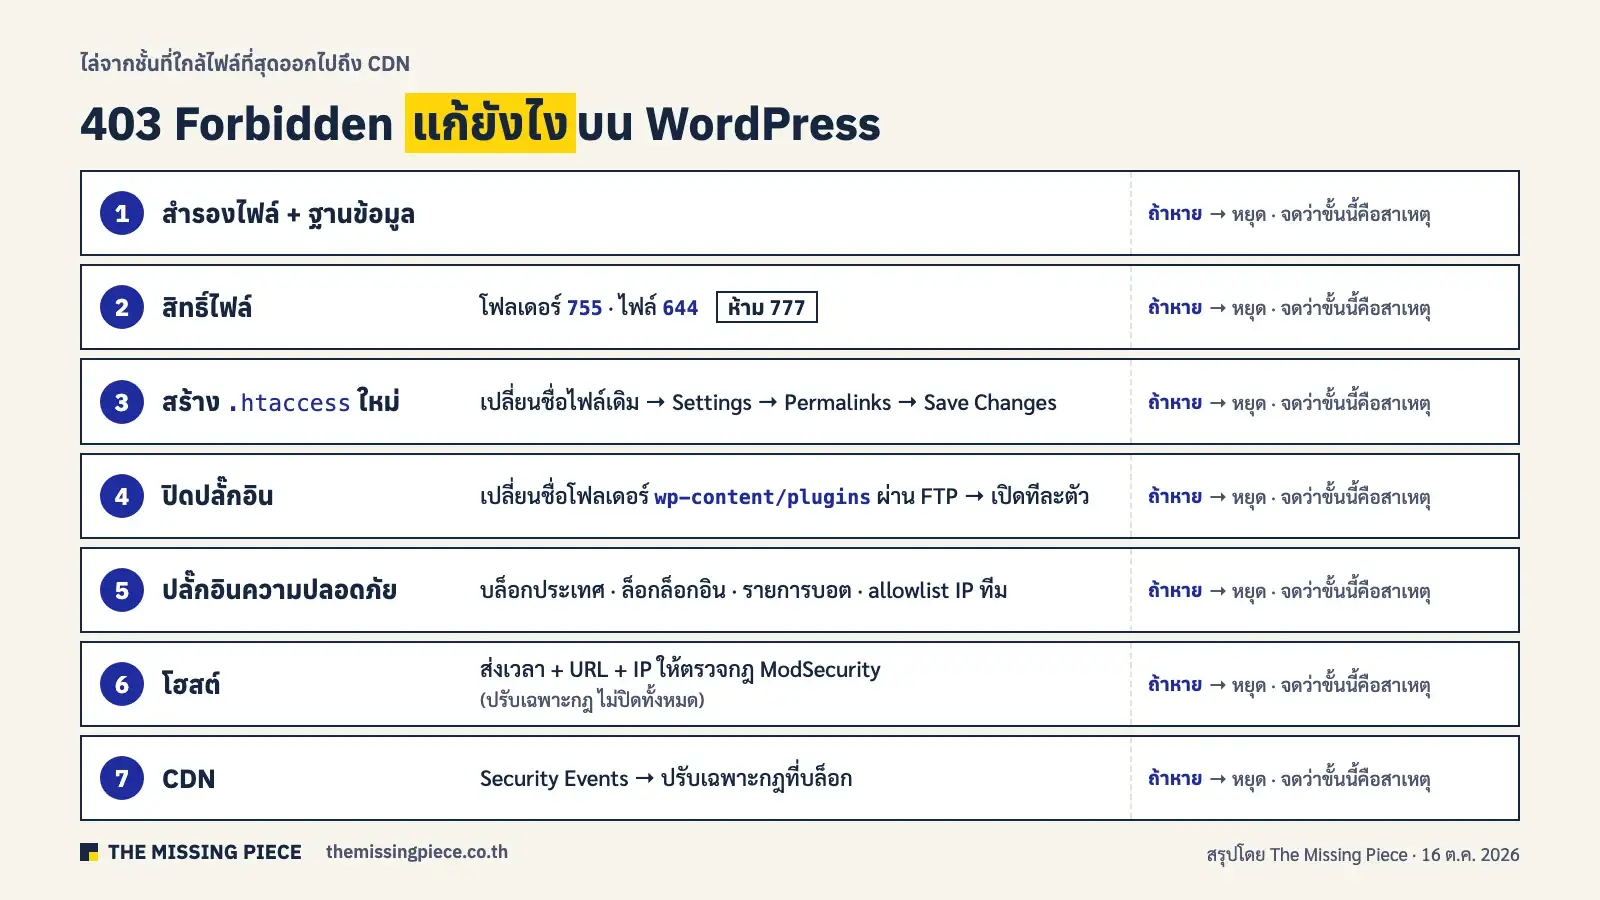
403 Forbidden แก้ได้เร็วที่สุดเมื่อแก้ที่ชั้นที่ตอบ ถ้ายังไม่รู้ชั้น ให้ไล่จากชั้นที่อยู่ใกล้ไฟล์ที่สุดออกไปข้างนอก ขั้นตอนนี้เขียนสำหรับ WordPress ซึ่งเป็นกรณีที่พบบ่อยที่สุดในผลค้นหาภาษาอังกฤษ แต่หลักเดียวกันใช้กับเว็บแบบอื่นได้ ก่อนเริ่มทุกขั้นให้สำรองไฟล์และฐานข้อมูลไว้ก่อน
- สำรองเว็บ: สำรองไฟล์และฐานข้อมูล หรือใช้ระบบ backup ของโฮสต์ ก่อนแก้ไฟล์ใดๆ
- ตรวจสิทธิ์ไฟล์: ผ่าน FTP หรือ file manager ของโฮสต์ ให้โฟลเดอร์เป็น 755 และไฟล์เป็น 644 เป็นค่าเริ่มต้น เอกสารของ WordPress แนะนำให้ไฟล์ wp-config.php เป็น 440 หรือ 400 และห้ามใช้ 777 กับทุกโฟลเดอร์
- สร้าง .htaccess ใหม่ (บน Apache): เปลี่ยนชื่อไฟล์ .htaccess เดิมเป็นชื่ออื่นเก็บไว้ แล้วเข้า Settings → Permalinks กด Save Changes โดยไม่ต้องเปลี่ยนค่า WordPress จะสร้างกฎพื้นฐานให้ใหม่ ถ้าหายแปลว่ามีกฎในไฟล์เดิมที่บล็อกอยู่
- ปิดปลั๊กอินทั้งหมดชั่วคราว: ถ้าเข้าหลังบ้านไม่ได้ ให้เปลี่ยนชื่อโฟลเดอร์ wp-content/plugins ผ่าน FTP ถ้า 403 หาย ให้เปลี่ยนชื่อกลับแล้วเปิดปลั๊กอินทีละตัวจนเจอตัวที่ทำให้เกิด
- ตรวจรายการบล็อกในปลั๊กอินความปลอดภัย: ดูกฎบล็อกประเทศ การล็อกหลังล็อกอินผิด และรายการบอตที่ถูกบล็อก ใส่ IP ของทีมไว้ในรายการอนุญาต และเช็กว่าไม่ได้บล็อกบอตที่คุณต้องการ
- ถามโฮสต์เรื่อง firewall: ถ้า 403 เกิดเฉพาะตอนส่งฟอร์มหรือบันทึกบทความ ส่งเวลา URL และ IP ให้โฮสต์ตรวจว่ากฎ ModSecurity ข้อไหนทำงาน และขอให้ปรับเฉพาะกฎนั้น ไม่ใช่ปิด firewall ทั้งหมด
- ตรวจกฎและ Security Events ของ CDN: ดูว่ากฎไหนบล็อกคำขอนั้น เช่น โหมดกันบอต กฎประเทศ rate limit หรือการบล็อกบอต AI แล้วปรับเฉพาะกฎนั้น
403 Forbidden nginx และ Apache: จุดที่ต้องเช็ก
403 Forbidden nginx มักมาจาก 3 จุด คือ path ใน root ผิดหรือ Nginx อ่านไฟล์ไม่ได้เพราะสิทธิ์ ไม่มีไฟล์ที่ระบุใน index ทั้งที่ autoindex ปิดอยู่ และมีกฎ deny all ใน location ที่ครอบ path นั้น ดูข้อความใน error log ของ Nginx จะบอกได้ว่าเป็นแบบไหน แก้ config แล้วให้รัน nginx -t ตรวจ syntax ก่อน reload
ฝั่ง Apache ให้ดู Require all denied หรือกฎ deny ในไฟล์ .htaccess และ config ของ virtual host รวมถึง Options -Indexes ที่ทำให้โฟลเดอร์ที่ไม่มีไฟล์ index ตอบ 403 ซึ่งควรตั้งไว้ (ปิดการแสดงรายการไฟล์) (กันคนเห็นรายการไฟล์) แต่ต้องมีไฟล์ index ในโฟลเดอร์ที่ตั้งใจให้คนเข้า
403 Forbidden ทำให้เสีย SEO ไหม
403 Forbidden ทำให้เสีย SEO เมื่อ Googlebot เจอ 403 ในหน้าที่คุณอยากให้ติดผลค้นหา เอกสาร How HTTP status codes affect Google’s crawlers (ปรับล่าสุด 4 ก.พ. 2026) บอกว่า Google ไม่ index URL ที่ตอบ 4xx หน้าที่เคย index แล้วกลับมาตอบ 4xx จะถูกลบออก และเนื้อหาจาก URL ที่ตอบ 4xx จะไม่ถูกใช้ ต่างจาก 404 ที่มักเกิดกับหน้าที่ไม่มีแล้ว 403 มักเกิดกับหน้าที่ยังมีอยู่และควรติดอันดับ ความเสียหายจึงมักหนักกว่าที่เจ้าของเว็บคิด (ข้อสังเกตของเรา)
Search Console Help หน้า Page indexing report อธิบายเหตุผล “Blocked due to access forbidden (403)” ไว้ชัดว่า 403 หมายถึงผู้ขอส่งข้อมูลยืนยันตัวตนมาแต่ไม่ได้รับสิทธิ์ และ Googlebot ไม่เคยส่งข้อมูลยืนยันตัวตน เซิร์ฟเวอร์ที่ตอบ 403 ให้ Googlebot จึงตอบผิด ทางแก้ที่ Google ให้คือเปิดให้ผู้ใช้ที่ไม่ได้ล็อกอินเข้าได้ หรืออนุญาต Googlebot โดยยืนยันตัวตนของบอตก่อน
- ดูได้จาก 3 ที่ใน Search Console: รายงาน Pages (Page indexing) ที่แถว “Blocked due to access forbidden (403)” · รายงาน Crawl Stats ส่วน By response ซึ่ง 403 จะรวมอยู่ในกลุ่ม “Other client error (4XX)” และ Google แนะนำให้แก้ · URL Inspection เพื่อทดสอบทีละ URL
- เช็ก sitemap ด้วย: The Art of SEO (4th ed., 2023) บทที่ 10 แนะนำว่า URL ที่อยู่ใน XML sitemap ควรตอบ 200 ทั้งหมด ถ้ามี URL ใน sitemap ตอบ 403 แปลว่าคุณบอก Google ให้มาเก็บหน้าที่คุณไม่ให้เข้า
- ถ้าไฟล์ robots.txt เองตอบ 403: Google ถือว่าเว็บไม่มี robots.txt และ crawl ได้ทุกหน้า (ยกเว้นตอบ 429) กฎที่คุณเขียนไว้ใน robots.txt จะไม่มีผล รายละเอียดอยู่ในบทความ Robots.txt คืออะไร
- หน้าสมาชิกที่ตั้งใจตอบ 403 ไม่ใช่ปัญหา: หน้าเหล่านั้นแค่ไม่ถูก index ซึ่งตรงกับที่ตั้งใจ
ใช้ 403 ลดการ crawl ไม่ได้
เอกสาร HTTP status codes ของ Google (4 ก.พ. 2026) เขียนไว้ตรงๆ ว่า “Don’t use 401 and 403 status codes for limiting the crawl rate” รหัส 4xx อื่นนอกจาก 429 ไม่ได้ทำให้ Google ลดการ crawl ผลของการตอบ 403 จึงไม่ใช่ “Googlebot มาน้อยลง” แต่คือ “หน้าหลุดจาก index” ถ้าเซิร์ฟเวอร์รับไม่ไหวจริง เอกสาร Reduce the Google crawl rate (ปรับล่าสุด 6 ต.ค. 2026) ให้ตอบ 500, 503 หรือ 429 แทน 200 ชั่วคราว (503 และ 429 ใส่ header Retry-After ได้) และเตือนว่าไม่ควรทำนาน เพราะเกินราว 1–2 วันอาจกระทบการแสดงผลของเว็บในผลิตภัณฑ์ของ Google
หน้าตรวจบอตที่ตอบ 200 ก็ทำให้หน้าหลุดได้
ปัญหาที่ตรงข้ามกับ 403 คือระบบกันบอตส่งหน้า “ยืนยันว่าคุณไม่ใช่บอต” ให้ Googlebot เหมือนเป็นหน้าปกติ (เช่นตอบ 200) Search Engine Journal รายงาน (19 ก.ค. 2026) ว่า Mueller อธิบายในพอดแคสต์ Search Off the Record ว่า Google อาจ index หน้าตรวจบอตแทนเนื้อหาจริง และเพราะหน้าแบบนี้เหมือนกันในหลายเว็บ Google อาจเลือกหน้าของเว็บอื่นเป็น canonical (หน้าหลัก) แล้วมองหน้าของคุณเป็นหน้าซ้ำ ปัญหานี้หายาก เพราะคนทั่วไปที่เปิดเว็บไม่เห็นหน้าตรวจบอต ต้องดูจากรายงาน Page indexing และ URL Inspection ว่า Google เลือก URL ไหนเป็นหน้าหลัก (เราอ่านรายงานของ SEJ ไม่ได้ฟังพอดแคสต์ต้นฉบับ)
ในรายงานของ SEJ อีกชิ้น (7 ม.ค. 2026) Mueller ตอบเรื่องสถานะ “Page indexed without content” ว่ามักเกิดจากเซิร์ฟเวอร์หรือ CDN บล็อกไม่ให้ Google ได้เนื้อหา และเตือนว่า “pages from your site will start dropping out of the index” จึงควรแก้แบบเรื่องด่วน เช็ก Search Console ทุกครั้งหลังเปลี่ยนการตั้งค่าความปลอดภัย วิธีอ่านรายงานเหล่านี้อยู่ในบทความ Google Search Console คืออะไร
ผลต่อ AI ของ Google ไปทางเดียวกัน เอกสาร AI features and your website ของ Google (ปรับล่าสุด 10 ธ.ค. 2025) บอกว่าหน้าที่จะแสดงเป็นลิงก์อ้างอิงใน AI Overviews หรือ AI Mode ต้องถูก index และแสดงใน Google Search พร้อม snippet ได้ หน้าที่ตอบ 403 ให้ Googlebot จึงหมดสิทธิ์ตรงนี้ด้วย อ่านต่อได้ที่ AI Overviews คืออะไร และ Google AI Mode
AI Search กับ 403: เมื่อ firewall บล็อกบอต AI โดยไม่รู้ตัว
บอตของ AI ที่โดน 403 อ่านหน้าเว็บของคุณไม่ได้ ทั้งที่ robots.txt อาจอนุญาตไว้แล้ว เพราะ robots.txt เป็นแค่ “คำขอ” ที่บอตอ่านก่อนเข้า ส่วน 403 เป็นการปิดประตูจริงที่ CDN, firewall หรือปลั๊กอิน ระบบกันบอตบางตัวบล็อกบอต AI เป็นค่าเริ่มต้น หรือบล็อกตามรายการที่อัปเดตเองโดยเจ้าของเว็บไม่ได้ตั้ง เรื่องนี้จึงเป็นเรื่องของ SEO & AI Search ไม่ใช่แค่ Google
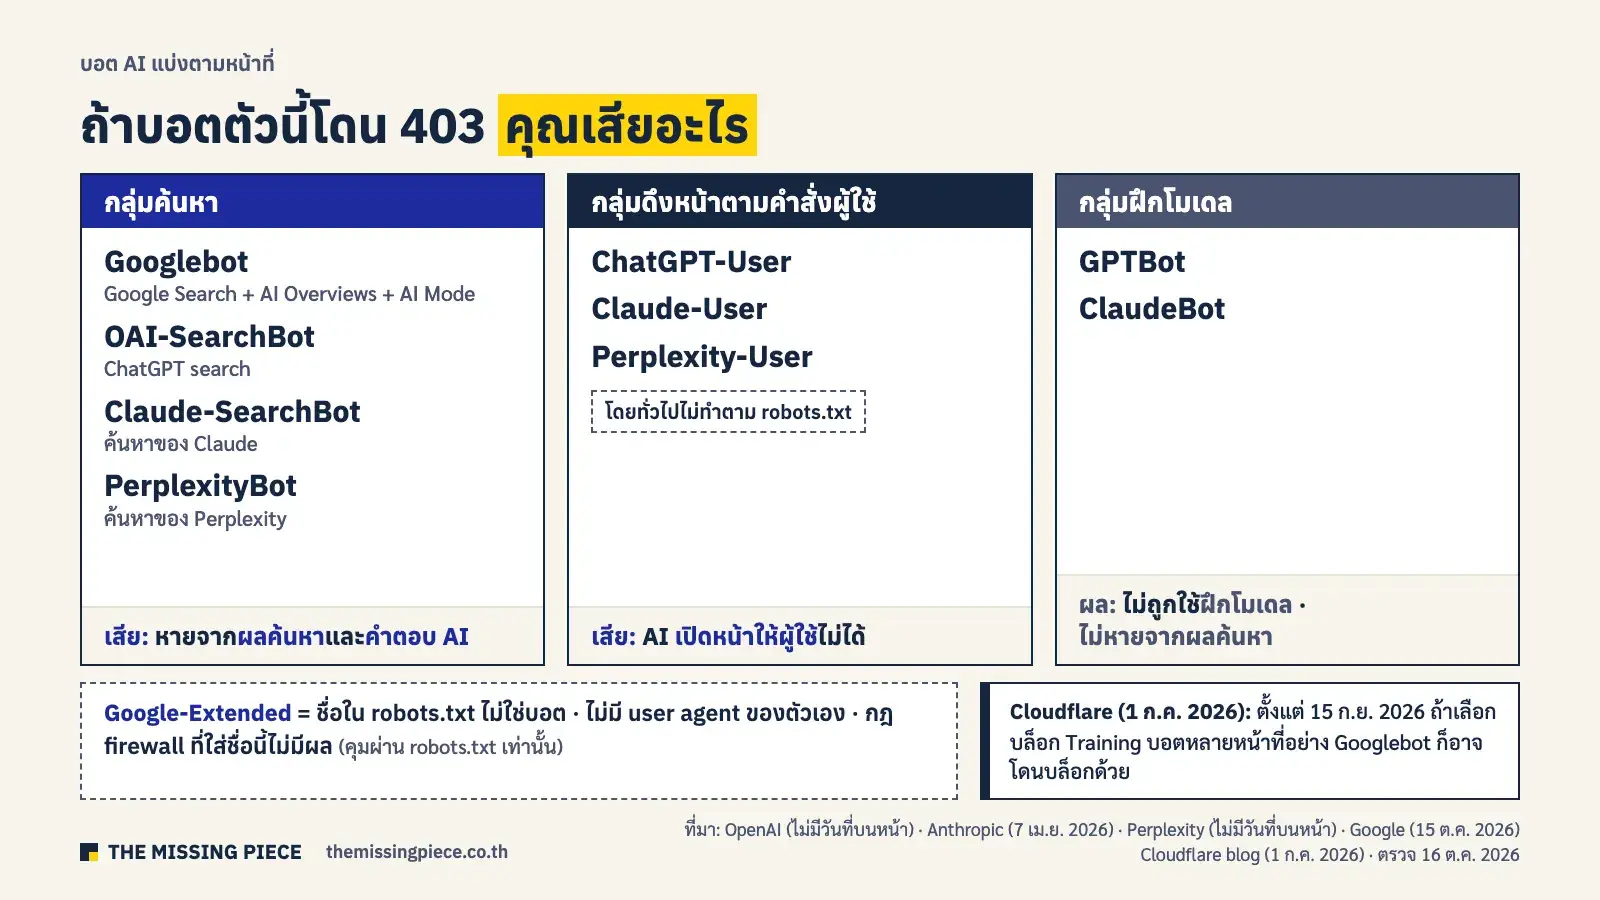
สิ่งที่เสียไปขึ้นกับว่าบอตตัวไหนโดน บริษัท AI ส่วนใหญ่แยกบอตตามหน้าที่ บอตเก็บข้อมูลฝึกโมเดล บอตทำดัชนีค้นหา และบอตที่ดึงหน้าเมื่อผู้ใช้สั่ง ตารางนี้สรุปจากหน้าเอกสารทางการของแต่ละบริษัท การตัดสินว่าจะเปิดหรือปิดบอตตัวไหนเป็นนโยบายที่อยู่ในบทความ Robots.txt สำหรับบอต AI หัวข้อนี้พูดเฉพาะผลเมื่อบอตโดน 403
| บอต | บริษัท | ใช้ทำอะไร | ถ้าโดน 403 คุณเสียอะไร |
|---|---|---|---|
| Googlebot | Google Search รวมถึง AI Overviews และ AI Mode | หน้าไม่ถูก index และหลุดจากผลค้นหา จึงไม่ถูกอ้างใน AI ของ Google Search ด้วย | |
| Google-Extended | ชื่อใน robots.txt สำหรับคุมการใช้ข้อมูลฝึก Gemini และ grounding (ให้ AI ดึงข้อมูลจากแหล่งภายนอกมาประกอบคำตอบ) ใน Gemini Apps กับ Vertex AI | ไม่ใช่บอตแยก ไม่มี user agent ของตัวเอง บล็อกที่ firewall ไม่ได้ กฎ firewall ที่ใส่ชื่อ Google-Extended จะไม่จับคำขอไหนเลย ทางเดียวที่บล็อกได้ที่ firewall คือบล็อก Googlebot ซึ่งจะตัดคุณออกจาก Google Search ด้วย ให้คุมผ่าน robots.txt | |
| OAI-SearchBot | OpenAI | ค้นหาใน ChatGPT | OpenAI บอกว่าเว็บที่ปิดบอตนี้ (opt out) จะไม่แสดงในคำตอบของ ChatGPT search (อาจยังมีเป็นลิงก์นำทาง) 403 ให้ผลแบบเดียวกันเพราะบอตอ่านหน้าไม่ได้ |
| ChatGPT-User | OpenAI | เปิดหน้าเมื่อผู้ใช้สั่ง ไม่ใช่การ crawl อัตโนมัติ | ChatGPT เปิดหน้าให้ผู้ใช้ที่ขอไม่ได้ |
| GPTBot | OpenAI | เก็บข้อมูลฝึกโมเดล | ไม่ถูกใช้ฝึกโมเดล ไม่ได้ตัดคุณออกจาก ChatGPT search |
| Claude-SearchBot | Anthropic | ทำดัชนีค้นหาของ Claude | Anthropic บอกว่าอาจลดการมองเห็นในผลค้นหาของ Claude |
| Claude-User | Anthropic | ดึงหน้าเมื่อผู้ใช้ถาม | อาจลดการมองเห็นเมื่อผู้ใช้สั่งให้ Claude ค้นหา |
| ClaudeBot | Anthropic | เก็บข้อมูลฝึกโมเดล | ไม่ถูกใช้ฝึกโมเดล |
| PerplexityBot | Perplexity | ผลค้นหาของ Perplexity (บริษัทบอกว่าไม่ใช้ฝึกโมเดลพื้นฐาน) | เสียโอกาสถูกแสดงและอ้างในผลค้นหาของ Perplexity |
| Perplexity-User | Perplexity | ดึงหน้าเมื่อผู้ใช้ถาม โดยทั่วไปไม่ทำตาม robots.txt | Perplexity เปิดหน้าให้ผู้ใช้ไม่ได้ และ ถ้าจะคุมบอตนี้ ต้องคุมที่ firewall เป็นหลัก |
วิธีให้แต่ละแพลตฟอร์มอ้างเว็บของคุณอ่านต่อได้ที่ ChatGPT SEO, Perplexity คืออะไร และ Claude AI คืออะไร
CDN เปลี่ยนค่าเริ่มต้นเรื่องบอต AI (ตัวอย่าง Cloudflare)
CDN รายใหญ่เปลี่ยนค่าเริ่มต้นเรื่องบอต AI หลายครั้งในช่วงปี 2025–2026 เว็บที่ไม่ได้แตะการตั้งค่าเลยก็อาจได้รับผล เราใช้ Cloudflare เป็นตัวอย่างเพราะมีเอกสารสาธารณะที่ระบุวันที่ชัด CDN และ WAF รายอื่นก็มีฟีเจอร์คล้ายกัน ให้เช็กเอกสารของผู้ให้บริการที่คุณใช้
- 1 ก.ค. 2025: Cloudflare ประกาศว่าจะบล็อกบอต AI ที่เข้าโดยไม่ได้รับอนุญาตเป็นค่าเริ่มต้น และตามข่าวประชาสัมพันธ์วันเดียวกัน โดเมนใหม่ที่สมัครจะถูกถามตั้งแต่ตอนสมัครว่าจะอนุญาตบอต AI หรือไม่
- 1 ก.ค. 2026: Cloudflare แบ่งบอต AI เป็น 3 กลุ่ม คือ Search, Agent และ Training และประกาศค่าเริ่มต้นใหม่ตั้งแต่ 15 ก.ย. 2026 สำหรับโดเมนใหม่ ให้บล็อก Training และ Agent บนหน้าที่แสดงโฆษณา ส่วน Search ยังอนุญาต
- บอตที่ทำหลายหน้าที่โดนกฎที่เข้มที่สุด: ในโพสต์เดียวกัน Cloudflare เขียนว่าบอตที่ทั้งค้นหาและเก็บข้อมูลฝึก เช่น Googlebot, Applebot และ BingBot จะถูกบล็อกสำหรับลูกค้าที่เลือกบล็อก Training ตั้งแต่ 15 ก.ย. 2026 (ทั้งผ่านตัวเลือกใหม่และบริการ Block AI bots แบบเดิม) ข้อนี้คือจุดที่ต้องระวังที่สุด เพราะการกดบล็อกบอตฝึกโมเดลอาจพาให้ Googlebot โดนบล็อกไปด้วย
- AI Crawl Control (ปรับล่าสุด 28 ก.ค. 2026): ตั้ง Allow, Block หรือ Charge ให้บอต AI ทีละตัว เลือกได้ว่าบอตที่ถูกบล็อกจะได้ 403 Forbidden หรือ 402 Payment Required (Charge ยังเป็น private beta)
- Bot Fight Mode (ปรับล่าสุด 3 ส.ค. 2026): โหมดกันบอตแบบฟรีที่ทำงานทั้งโดเมน และเอกสารบอกว่าข้ามด้วย WAF custom rules หรือ Page Rules ไม่ได้ ถ้าบอตที่คุณต้องการโดนบล็อกจากโหมดนี้ ต้องปิดโหมดหรือใช้ Super Bot Fight Mode ที่ตั้งข้ามได้
- Verified bots (ปรับล่าสุด 8 ต.ค. 2026): Cloudflare มีรายการบอตที่ยืนยันตัวตนแล้ว (ผ่าน IP ที่เผยแพร่ user agent คงที่ reverse DNS (ค้นชื่อโดเมนจาก IP) หรือการเซ็นคำขอ) ใช้เป็นเงื่อนไขอนุญาตบอตจริงได้ ดูหัวข้อเปิดทางให้บอตจริง
ผลเบื้องต้น: เว็บไทยขนาดใหญ่ 20 เว็บตอบบอต AI ยังไง
ผลเบื้องต้นของ The Missing Piece คือ ใน 14 เว็บที่ตอบเบราว์เซอร์ปกติ มี 2 เว็บที่ไม่ยอมให้บอตค้นหาของ AI เข้า (ตอบ 403 หรือ 402) ทั้งที่ robots.txt ของทุกเว็บที่อ่านได้ไม่ได้ห้ามบอตทั้ง 5 ตัวเข้าหน้าแรก (“/”) เราเปิดหน้าแรกของเว็บไทยขนาดใหญ่ 20 เว็บ (ข่าว พอร์ทัล เว็บบอร์ด ร้านค้าออนไลน์ ธนาคาร โทรคมนาคม รีวิว และการศึกษา) เมื่อ 16 ต.ค. 2026 ด้วย user agent 6 แบบ คือเบราว์เซอร์ Chrome กับชื่อบอต GPTBot, OAI-SearchBot, ClaudeBot, PerplexityBot และ Googlebot
| ผลที่ได้ (n = 20 หน้าแรก, 16 ต.ค. 2026) | จำนวนเว็บ |
|---|---|
| ตอบ 200 ให้ทั้ง 6 user agent | 11 |
| ตอบ 403 ให้ทุก user agent รวมถึงชื่อเบราว์เซอร์ (หน้าตรวจบอตที่มี header cf-mitigated 5 เว็บ และ 403 จาก CDN อีกรายที่บล็อก robots.txt ด้วย 1 เว็บ) | 6 |
| เบราว์เซอร์ได้ 200 แต่บอต AI ทั้ง 4 ตัวได้ 402 Payment Required | 1 |
| เบราว์เซอร์ได้ 200 แต่ GPTBot, OAI-SearchBot, PerplexityBot และ Googlebot ปลอมได้ 403 (ClaudeBot ได้ 200) | 1 |
| บอต AI ได้ 200 ทุกตัว แต่ Googlebot ปลอม (แค่ใส่ชื่อ) ได้ 403 | 1 |
| robots.txt ห้ามบอตตัวใดตัวหนึ่งเข้า “/” | 0 จาก 19 ไฟล์ที่อ่านได้ |
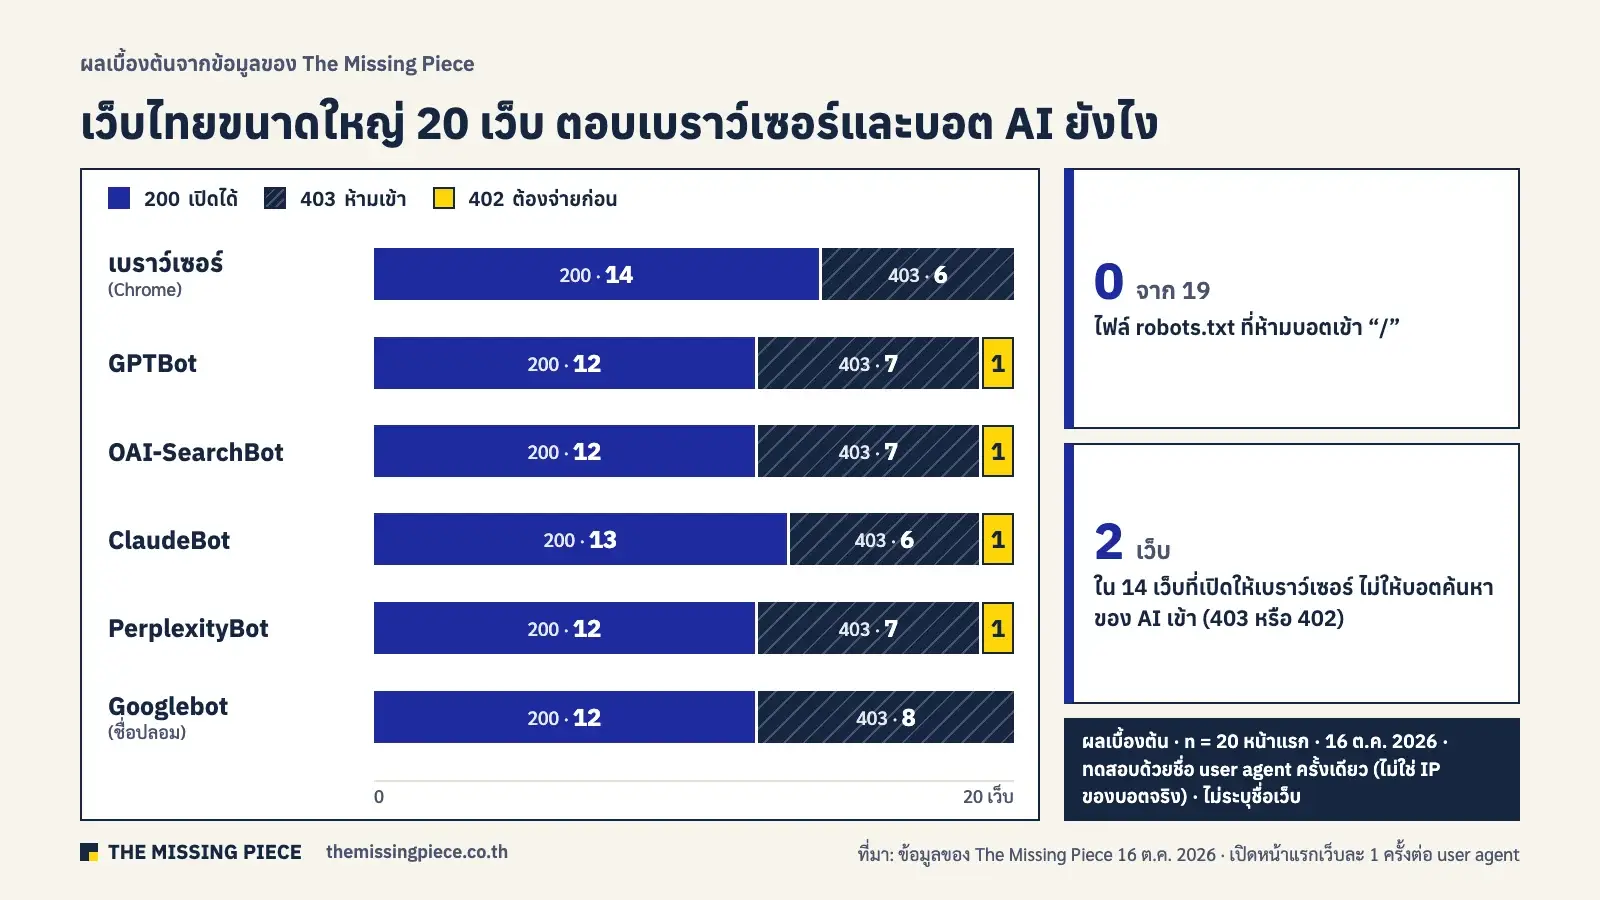
ผลนี้บอก 3 เรื่อง เรื่องแรก robots.txt ที่อนุญาตไม่ได้แปลว่าบอตเข้าได้ firewall คือชั้นที่ตัดสินจริง เรื่องที่สอง 6 เว็บตอบ 403 แม้เราส่งชื่อเบราว์เซอร์ไป เพราะระบบกันบอตดูมากกว่าชื่อ crawler ของเครื่องมือ SEO ก็โดนแบบนี้ได้ ผลตรวจเว็บจึงอาจสะท้อนกฎความปลอดภัย ไม่ใช่เนื้อหา (ดูวิธีตรวจเว็บใน SEO Audit) เรื่องที่สาม เว็บที่ตอบ 402 ให้บอต AI น่าจะเป็นสัญญาณของโมเดล “จ่ายก่อนค่อยอ่าน” ที่ CDN เริ่มเปิดให้ใช้ ส่วนเว็บที่บล็อกเฉพาะ Googlebot ปลอมคือสิ่งที่ควรเกิด ถ้าเว็บตรวจ IP ของบอตด้วย ชื่อบอตปลอมได้ แต่ IP ปลอมยาก
วิธีเก็บและข้อจำกัดของข้อมูลชุดนี้ (ผลเบื้องต้น):
- ตัวอย่าง 20 เว็บไทยขนาดใหญ่ที่เราเลือกเอง (ข่าว 7 พอร์ทัล 2 ร้านค้าออนไลน์และค้าปลีก 4 ธนาคาร 2 โทรคมนาคม 2 เว็บบอร์ด 1 รีวิว 1 การศึกษา 1) ไม่ใช่ตัวอย่างสุ่ม
- ขอเฉพาะหน้าแรก 1 ครั้งต่อ user agent จาก IP ไทย 1 จุด ด้วย curl ตาม redirect ได้ไม่เกิน 5 ทอด เว้นอย่างน้อย 3 วินาทีระหว่างทุกคำขอ อ่าน HTML ดิบ ไม่รัน JavaScript
- ทดสอบด้วย “ชื่อ” ของบอตเท่านั้น บอตจริงถูกตัดสินจาก IP และรายการ verified bots ด้วย ผลนี้จึงบอกไม่ได้ว่า GPTBot หรือ Googlebot ตัวจริงได้รับอะไร เว็บอาจอนุญาตบอตจริงตาม IP แต่บล็อกชื่อปลอมของเรา หรือกลับกัน
- curl ไม่ใช่เบราว์เซอร์จริง 403 ที่ชื่อเบราว์เซอร์ได้จึงสะท้อนระบบตรวจลักษณะของเครื่องผู้ขอเป็นหลัก ตัวเลขนี้บอกพฤติกรรมในวันนั้นเท่านั้น ไม่ได้ประเมิน SEO ของเว็บใด และเราไม่เปิดเผยชื่อเว็บ
AI SEO For Dummies บทที่ 10 แนะนำให้ตรวจเว็บด้วย user agent มากกว่าหนึ่งแบบ และเตือนว่าระบบจัดการบอตของ CDN หรือ WAF สร้างผลบล็อกผิด (false positive) ได้ หน้าสำคัญที่บอตเข้าไม่ได้เพราะ robots.txt หรือ WAF จึงอยู่ในรายการสิ่งที่ต้องแก้ก่อน ส่วนบทที่ 22 จัด “บล็อกบอต AI ไว้ก่อนดีกว่า” เป็นหนึ่งในความเชื่อผิด หนังสือยอมรับว่าบางธุรกิจมีเหตุผลด้านกฎหมายหรือความเป็นส่วนตัว แต่การบล็อกแบบเหมารวมตัดโอกาสที่ AI จะค้นเจอและอ้างเว็บของคุณ ซึ่งตรงกับเอกสารของบริษัท AI ข้างต้น
การเปิดให้บอตเข้าเว็บได้คือด่านแรกของ “เปิดบ้านรับบอต” ใน AI-Ready Website ถ้าบอตโดน 403 ตั้งแต่ประตู งานด้านเนื้อหาและแบรนด์ที่ทำมาจะไม่ถูกอ่านเลย
อยากให้การเช็ก 403 และบอตที่โดนบล็อกทำงานเองทุกสัปดาห์: คอร์สเรียน SEO & AI Search สอนสด 2 วันด้วย Claude Code (จ. 21 – อ. 22 ธ.ค. 2026) สร้าง agent ที่วัดว่า ChatGPT กับ Gemini พูดถึงแบรนด์คุณไหม แล้วทำงานกับเว็บของคุณต่อทุกสัปดาห์
เปิดทางให้บอตที่ต้องการ แบบไม่เปิดให้บอตปลอม
การเปิดทางให้บอตจริงต้องตรวจทั้ง “ชื่อ” และ “IP” ของบอต ไม่ใช่ชื่ออย่างเดียว เพราะใครก็ตั้ง user agent เป็น Googlebot หรือ GPTBot ได้ The Art of SEO (4th ed., 2023) บทที่ 7 เตือนว่าเจ้าของเว็บบางรายบล็อก IP ของ search engine จริงเพราะคิดว่าเป็นบอตขโมยข้อมูล และแนะนำให้ยืนยันบอตด้วย reverse DNS ตามด้วย forward DNS เพราะ reverse DNS อย่างเดียวปลอมได้ ขั้นตอนที่ใช้ได้กับทุก CDN มีดังนี้
- ตัดสินนโยบายก่อน: เลือกว่าจะเปิดบอตกลุ่มไหน (ค้นหา ดึงหน้าตามคำสั่งผู้ใช้ ฝึกโมเดล) แล้วเขียนใน robots.txt ให้ตรงกัน ดูคำแนะนำทีละบอตใน Robots.txt สำหรับบอต AI
- ยืนยัน Googlebot ตามวิธีของ Google: เอกสาร Verify requests from Google crawlers and fetchers (ปรับล่าสุด 20 มี.ค. 2026) ให้ทำ reverse DNS ของ IP แล้วชื่อต้องลงท้ายด้วย googlebot.com, google.com หรือ googleusercontent.com จากนั้นทำ forward DNS ต้องได้ IP เดิม หรือเทียบ IP กับไฟล์ JSON รายการ IP ที่ Google เผยแพร่
- อนุญาตบอต AI ตาม IP ที่บริษัทเผยแพร่: OpenAI มีไฟล์ IP แยกของ OAI-SearchBot, GPTBot และ ChatGPT-User · Anthropic มีรายการ IP ของบอต Claude · Perplexity แนะนำว่าถ้าใช้ WAF ให้อนุญาตทั้ง PerplexityBot และ Perplexity-User โดยเช็กทั้ง user agent และ IP และให้ตั้งระบบอัปเดตรายการ IP อัตโนมัติเพราะ IP เปลี่ยนได้
- ใช้รายการ verified bots ของ CDN ถ้ามี: เช่น Cloudflare มีตัวอย่าง WAF custom rule ที่ยกเว้น verified bots (field Known Bots) จากกฎตรวจ แต่จำไว้ว่า Bot Fight Mode แบบฟรีข้ามด้วยกฎแบบนี้ไม่ได้
- อย่าบล็อกบอตที่อ่าน robots.txt ด้วย IP: Anthropic (7 เม.ย. 2026) เตือนว่าการบล็อก IP อาจทำงานผิด เพราะทำให้บอตอ่าน robots.txt ไม่ได้ ถ้าไม่อยากให้บอตตัวไหนเข้า ให้บอกใน robots.txt ก่อน แล้วใช้ firewall กับบอตที่ไม่ทำตาม
- เช็กซ้ำหลังเปลี่ยนแพ็กเกจหรือการตั้งค่า: ดู Security Events ของ CDN สัปดาห์ละครั้ง กรองด้วยชื่อบอตที่คุณต้องการ และทดสอบหน้าสำคัญด้วย URL Inspection หลังเปลี่ยนกฎทุกครั้ง
ข้อควรระวังจากบทเดียวกันของ The Art of SEO คือ การแยกตามบอตมีไว้เพื่อ “อนุญาตหรือไม่อนุญาต” เท่านั้น อย่าส่งเนื้อหาที่ต่างจากที่คนเห็นให้บอต เพราะจะเข้าข่าย cloaking (แสดงเนื้อหาต่างกันให้ search engine กับผู้ใช้) ซึ่งผิดแนวทางของ Google
แก้ 403 แล้วต้องรอนานไหมกว่า Google และ AI จะเห็นหน้า
การแก้กฎที่ CDN หรือเซิร์ฟเวอร์มีผลทันที แต่ Google และบอต AI จะเห็นหน้าอีกครั้งเมื่อกลับมา crawl ตามรอบของตัวเอง ระยะเวลาจึงขึ้นกับแต่ละแพลตฟอร์ม ไม่ใช่กับเรา ตัวเลขที่มีในเอกสารทางการมีดังนี้
- Google: Googlebot กลับมา crawl เอง ถ้าเป็นหน้าสำคัญให้ใช้ URL Inspection กด Request indexing แล้วกด Validate fix ในรายงาน Page indexing ซึ่ง Search Console Help บอกว่าโดยทั่วไปใช้เวลาไม่เกินประมาณ 2 สัปดาห์ แต่บางกรณีอาจนานกว่า
- ถ้าเคยตอบ 5xx หรือ 429 ช่วงชะลอฉุกเฉิน: เอกสาร Google (4 ก.พ. 2026) บอกว่าอัตราการ crawl จะกลับมาเองเมื่อเซิร์ฟเวอร์ตอบ 2xx อีกครั้ง
- OpenAI: หน้าเอกสารบอกว่าการเปลี่ยน robots.txt สำหรับการค้นหาใช้เวลาราว 24 ชั่วโมงกว่าจะมีผล ส่วนการกลับมา crawl หลังแก้ firewall ขึ้นกับรอบของบอต
- Perplexity: หน้าเอกสารบอกว่าการเปลี่ยน robots.txt อาจใช้เวลาถึง 24 ชั่วโมงกว่าจะมีผล ส่วนการเปลี่ยนกฎ WAF ต้องรอสักพักให้มีผลทั่วระบบ
- Anthropic: ไม่ได้ระบุระยะเวลาในหน้าเอกสาร ให้ดูใน log หรือ Security Events ว่าบอตกลับมาได้ 200 เมื่อไร
403 เป็นงานหนึ่งของ Technical SEO ร่วมกับ Error 404, redirect, robots.txt และเรื่องที่ยังไม่มีบทความแยกบนเว็บเรา เช่น Core Web Vitals และ HTTPS ดูภาพรวมทั้งหมดได้ที่ Technical SEO คืออะไร
บทความนี้เขียนโดยทีม The Missing Piece จากมาตรฐาน HTTP เอกสารทางการของ Google, OpenAI, Anthropic, Perplexity และ Cloudflare และข้อมูลที่เราเก็บเองจากเว็บไทย
คำถามที่พบบ่อย
403 กับ 404 ต่างกันยังไง
403 คือเซิร์ฟเวอร์ได้รับคำขอแต่ไม่อนุญาตให้เข้า ส่วน 404 คือไม่พบหน้าที่ขอ ทั้งสองรหัสทำให้ Google ไม่ index หน้านั้นเหมือนกัน แต่ 403 มักมาจากกฎที่ตั้งไว้ เช่น สิทธิ์ไฟล์หรือ firewall จึงโดนหน้าที่ยังมีอยู่ได้
403 Forbidden ทำให้หน้าหลุดจาก Google ไหม
หลุด ถ้า Googlebot เจอ 403 ซ้ำๆ เอกสาร Google (4 ก.พ. 2026) บอกว่า URL ที่ตอบ 4xx ไม่ถูก index และหน้าที่เคย index จะถูกลบออก ให้ดูแถว “Blocked due to access forbidden (403)” ในรายงาน Page indexing ของ Search Console
ใช้ VPN แล้วขึ้น 403 ต้องทำยังไง
ปิด VPN แล้วลองใหม่ เพราะหลายเว็บบล็อก IP ของบริการ VPN หรือบล็อกตามประเทศ ถ้ายังไม่ได้ ให้ลองเปลี่ยนเครือข่ายหรือแจ้งเจ้าของเว็บพร้อมเวลาที่เจอ
ใช้ 403 ลดการ crawl ของ Googlebot ได้ไหม
ไม่ได้ Google บอกว่าห้ามใช้ 401 หรือ 403 เพื่อจำกัดอัตราการ crawl เพราะผลคือหน้าหลุดจาก index ถ้าเซิร์ฟเวอร์รับไม่ไหว ให้ตอบ 500, 503 หรือ 429 ชั่วคราว ไม่เกินราว 1–2 วัน
บล็อก GPTBot แล้วเว็บจะหายจาก ChatGPT ไหม
ไม่หายจาก ChatGPT search เพราะ GPTBot ใช้เก็บข้อมูลฝึกโมเดล บอตที่ใช้ค้นหาใน ChatGPT คือ OAI-SearchBot ซึ่ง OpenAI บอกว่าเว็บที่ไม่ให้บอตนี้เข้าจะไม่แสดงในคำตอบของ ChatGPT search
Google-Extended บล็อกที่ firewall ได้ไหม
ไม่ได้ Google-Extended เป็นแค่ชื่อใน robots.txt ไม่มี user agent ของตัวเอง การ crawl ใช้ user agent เดิมของ Google กฎ firewall ที่ใส่ชื่อนี้จึงไม่มีผล ถ้าจะบล็อกที่ firewall ก็ต้องบล็อก Googlebot ซึ่งตัดคุณออกจากผลค้นหา ให้ใช้ robots.txt แทน
แหล่งอ้างอิง
- IETF, RFC 9110 HTTP Semantics (มิ.ย. 2022, §15.5.4 403 Forbidden: เข้าใจคำขอแต่ปฏิเสธ, อาจห้ามด้วยเหตุผลที่ไม่เกี่ยวกับการล็อกอิน, ตอบ 404 เพื่อซ่อนได้ · §15.5.2 401 Unauthorized ต้องส่ง WWW-Authenticate)
- IETF, RFC 6585 Additional HTTP Status Codes (เม.ย. 2012, §4 429 Too Many Requests)
- MDN, 403 Forbidden (ปรับล่าสุด 22 มิ.ย. 2026: ล็อกอินใหม่ไม่ช่วย, ส่งคำขอเดิมซ้ำได้ผลเดิม, เซิร์ฟเวอร์อาจตอบ 404 แทน)
- WordPress Developer Resources, Changing File Permissions (โฟลเดอร์ 755 หรือ 750, ไฟล์ 644 หรือ 640, wp-config.php 440 หรือ 400, ห้าม 777 · ตรวจ 16 ต.ค. 2026)
- Google Crawling Infrastructure, How HTTP status codes affect Google’s crawlers (last updated 2026-02-04: URL ที่ตอบ 4xx ไม่ถูก index และถูกลบถ้าเคย index, ห้ามใช้ 401 และ 403 จำกัดอัตราการ crawl, 429 ถูกปฏิบัติเหมือนสัญญาณเซิร์ฟเวอร์รับไม่ไหว, 5xx ต่อเนื่องทำให้ URL หลุด)
- Google Crawling Infrastructure, Reduce the Google crawl rate (last updated 2026-10-06: ชะลอฉุกเฉินด้วย 500, 503 หรือ 429, ไม่ควรนานเกินราว 1–2 วัน)
- Search Console Help, Page indexing report (ไม่ระบุวันที่ ตรวจ 16 ต.ค. 2026: Blocked due to access forbidden (403), Googlebot ไม่เคยส่งข้อมูลยืนยันตัวตน, Blocked due to unauthorized request (401), การ validate ใช้เวลาราว 2 สัปดาห์)
- Search Console Help, Crawl Stats report (ไม่ระบุวันที่: By response, Other client error (4XX))
- Google Crawling Infrastructure, How Google interprets the robots.txt specification (last updated 2026-08-31: robots.txt ที่ตอบ 4xx ยกเว้น 429 ถือว่าไม่มีไฟล์)
- Google Crawling Infrastructure, Verify requests from Google crawlers and fetchers (last updated 2026-03-20: reverse DNS + forward DNS, รายการ IP แบบ JSON)
- Google Crawling Infrastructure, Google’s common crawlers (last updated 2026-10-15: Google-Extended เป็น product token ใน robots.txt ไม่มี user agent ของตัวเอง ไม่กระทบการแสดงใน Google Search)
- Google Search Central, AI features and your website (last updated 2025-12-10: หน้าที่จะเป็นลิงก์อ้างอิงใน AI Overviews/AI Mode ต้องถูก index และแสดงพร้อม snippet ได้)
- OpenAI, Overview of OpenAI Crawlers (ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026: OAI-SearchBot, GPTBot, ChatGPT-User, รายการ IP, การเปลี่ยน robots.txt ราว 24 ชั่วโมง)
- Anthropic Help Center, Does Anthropic crawl data from the web, and how can site owners block the crawler? (ปรับล่าสุด 7 เม.ย. 2026: ClaudeBot, Claude-User, Claude-SearchBot, การบล็อก IP อาจทำให้บอตอ่าน robots.txt ไม่ได้, รายการ IP: claude.com/crawling/bots.json)
- Perplexity, Perplexity Crawlers (ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026: PerplexityBot, Perplexity-User, อนุญาตใน WAF ด้วย user agent และ IP, การเปลี่ยน robots.txt อาจใช้เวลาถึง 24 ชั่วโมง)
- Cloudflare Blog, Content Independence Day: no AI crawl without compensation! (1 ก.ค. 2025) และ Cloudflare Just Changed How AI Crawlers Scrape the Internet-at-Large (ข่าวประชาสัมพันธ์วันเดียวกัน) (บล็อกบอต AI เป็นค่าเริ่มต้น, โดเมนใหม่ถูกถามตอนสมัคร · เปิดอ่าน 16 ต.ค. 2026)
- Cloudflare Blog, Your site, your rules: new AI traffic options for all customers (1 ก.ค. 2026: กลุ่ม Search, Agent, Training, ค่าเริ่มต้นใหม่ 15 ก.ย. 2026 สำหรับโดเมนใหม่, บอตหลายหน้าที่เช่น Googlebot ถูกบล็อกเมื่อเลือกบล็อก Training · เปิดอ่านต้นฉบับ 16 ต.ค. 2026)
- Cloudflare Docs, AI Crawl Control: Manage AI crawlers (ปรับล่าสุด 28 ก.ค. 2026: Allow, Block, Charge, บอตที่ถูกบล็อกได้ 403 หรือ 402)
- Cloudflare Docs, Bot Fight Mode (ปรับล่าสุด 3 ส.ค. 2026: ข้ามด้วย WAF custom rules หรือ Page Rules ไม่ได้)
- Cloudflare Docs, Verified bots (ปรับล่าสุด 8 ต.ค. 2026)
- Cloudflare Docs, Allow traffic from search engine bots and other verified bots (ปรับล่าสุด 16 เม.ย. 2026)
- Cloudflare Docs, Challenge pages: detect a challenge response (ปรับล่าสุด 5 พ.ค. 2026: header cf-mitigated: challenge)
- Search Engine Journal, Google’s Mueller Explains ‘Page Indexed Without Content’ Error (Matt G. Southern) (7 ม.ค. 2026: คำตอบของ John Mueller บน Reddit, การบล็อกระดับเซิร์ฟเวอร์หรือ CDN บางครั้งบล็อกตาม IP ของ Googlebot, หน้าจะเริ่มหลุดจาก index · รายงานโดย SEJ)
- Search Engine Journal, “Are You A Bot” Screens Can Get Your Pages Dropped By Google (Matt G. Southern) (19 ก.ค. 2026: Mueller ใน Search Off the Record, หน้าตรวจบอตถูก index แทนเนื้อหาและเสีย canonical · รายงานโดย SEJ เราไม่ได้ฟังพอดแคสต์ต้นฉบับ)
- ข้อมูลของ The Missing Piece: ผลเบื้องต้นการเปิดหน้าแรกของเว็บไทยขนาดใหญ่ 20 เว็บด้วย user agent ของเบราว์เซอร์และบอต 5 ตัว และอ่าน robots.txt (16 ต.ค. 2026 ครั้งเดียว ทดสอบด้วยชื่อ user agent เท่านั้น ไม่ระบุชื่อเว็บ) · การสังเกต AI Overview ของคำ “403 forbidden คือ” บนมือถือ 1 ครั้ง (16 ต.ค. 2026)
- Nathan Gotch, AI SEO For Dummies (Wiley, 2026), บทที่ 10 (ตรวจเว็บด้วย user agent หลายแบบ, ระบบจัดการบอตของ CDN/WAF สร้าง false positive ได้, หน้าสำคัญที่ถูก robots หรือ WAF บล็อกเป็นงานที่ต้องแก้ก่อน) · บทที่ 22 (การบล็อกบอต AI แบบเหมารวมเป็นความเชื่อผิด)
- Eric Enge, Stephan Spencer, Jessie Stricchiola, The Art of SEO, 4th ed. (O’Reilly, 2023), บทที่ 4 (log บันทึก user agent ตามที่ผู้ขออ้าง บอตปลอมจึงดูเหมือนบอตจริง) · บทที่ 7 (อย่าบล็อก IP ของ search engine จริง, ยืนยันบอตด้วย reverse DNS และ forward DNS, ไม่ส่งเนื้อหาต่างกันให้บอต) · บทที่ 10 (URL ใน XML sitemap ควรตอบ 200)