สรุปสั้น (TL;DR)
Technical SEO คืองานดูแลฝั่งระบบของเว็บไซต์ ให้ Googlebot และ crawler ของ AI search เข้าถึงหน้าได้ อ่านเนื้อหาได้ และจัดเก็บ (index) หน้าได้ถูกหน้า ก่อนที่เนื้อหาจะมีโอกาสแข่งอันดับ ขั้นต่ำที่ Google เขียนไว้มีแค่ 3 ข้อ คือ ไม่บล็อก Googlebot หน้าตอบ HTTP 200 และมีเนื้อหาที่ index ได้ ส่วนที่เหลือเช็กตามลำดับ crawl → render → index → serve ว่าพังตรงไหนก่อน
- แก้ตามลำดับ ไม่ใช่ตามรายการ: noindex หลุด หน้า 404 หรือบล็อก bot ทำให้หน้าไม่ติดเลย ส่วน Core Web Vitals เป็นแค่ส่วนหนึ่ง เพราะเอกสาร Page experience ของ Google (อัปเดต 22 ก.ย. 2026) บอกว่าไม่มีสัญญาณ page experience ตัวเดียว
- หน้าโฮมของเว็บไทยที่ติดหน้าแรก Google 56 เว็บ (ตรวจ 15 ต.ค. 2026): 98.2% redirect ไป HTTPS แล้ว แต่ผ่านครบ 7 ข้อพื้นฐานแค่ 39.3% จุดที่พลาดคือรายละเอียด เช่น H1 ไม่ใช่ 1 อัน (41.1%) ไม่ประกาศ sitemap ใน robots.txt (21.4%) และไม่มี HSTS (69.6%)
- เว็บเราเอง 21 ข้อ: ผ่าน 15 ต้องปรับ 3 ยังไม่ผ่าน 2 ยังวัดไม่ได้ 1 · 2 ข้อที่ไม่ผ่านเป็นเรื่องฝั่งเซิร์ฟเวอร์ ไม่ใช่ WordPress เราจึงใส่ข้อความภาษาไทยสำหรับส่งถึงผู้ให้บริการโฮสต์ไว้ให้ copy ไปใช้
สารบัญ
- Technical SEO คืออะไร
- Google ทำงาน 4 ขั้น
- ขั้นต่ำ 3 ข้อ + เช็กลิสต์ 20 ข้อ
- robots.txt, noindex, canonical, redirect, sitemap
- Status code และ soft 404
- JavaScript กับการ render
- Technical SEO สำหรับ AI crawler
- HTTPS, page experience และมือถือ
- Structured data, รูป, log file, hreflang
- คำแนะนำเก่าที่ควรเลิกใช้
- ข้อมูลเว็บไทย 56 เว็บ
- เราตรวจเว็บตัวเอง 21 ข้อ
- WordPress 30 นาที + ข้อความถึงโฮสต์
- ตรวจ technical SEO เอง
- คำถามที่พบบ่อย
Technical SEO คืออะไร ต่างจาก On-Page และ Off-Page ยังไง
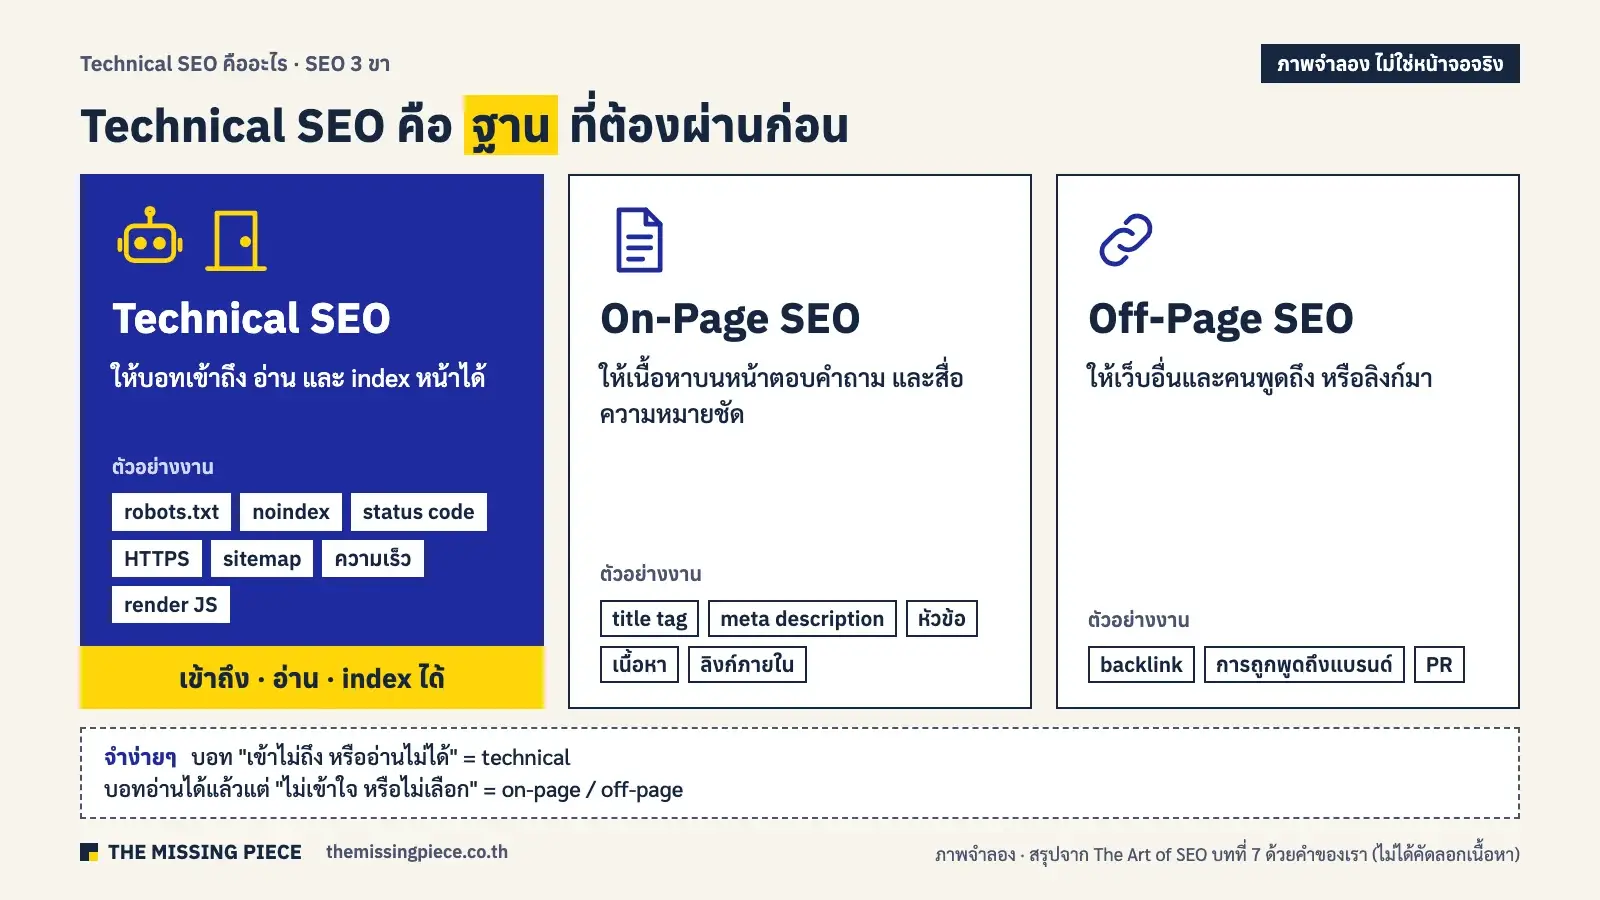
Technical SEO (เทคนิคอล SEO หรืองาน SEO ด้านเทคนิค) คืองานด้านระบบของเว็บไซต์ที่ทำให้ระบบค้นหา เช่น Googlebot และ crawler ของ AI search เข้ามาเก็บหน้าเว็บได้ อ่านเนื้อหาได้ครบ และเลือกเก็บหน้าที่ถูกต้องเข้าระบบ เจ้าของเว็บทุกขนาดต้องมีพื้นฐานนี้ เพราะหน้าที่บอทเข้าไม่ถึงหรือ index ไม่ได้ จะไม่มีโอกาสขึ้นผลค้นหาเลย ไม่ว่าเนื้อหาจะดีแค่ไหน เอกสาร How Google Search works (อัปเดต 18 ธ.ค. 2025) เขียนไว้ชัดว่า Google ไม่รับประกันว่าจะ crawl, index หรือแสดงหน้าใดหน้าหนึ่ง
งาน SEO แบ่งเป็น 3 ขาที่ทำงานคู่กัน (ภาพรวมทั้งหมดอยู่ที่ SEO คืออะไร)
| ขา | ทำอะไร | ตัวอย่างงาน |
|---|---|---|
| Technical SEO | ให้บอทเข้าถึง อ่าน และ index หน้าได้ | robots.txt, noindex, status code, HTTPS, sitemap, ความเร็ว, การ render JavaScript |
| On-Page SEO | ให้เนื้อหาบนหน้าตอบคำถามและสื่อความหมายชัด | title tag, meta description, หัวข้อ, เนื้อหา, ลิงก์ภายใน |
| Off-Page SEO | ให้เว็บอื่นและคนพูดถึงหรือลิงก์มา | backlink, การถูกพูดถึงแบรนด์, PR |
เส้นแบ่งไม่ได้เป๊ะ บางเรื่องอยู่ได้ทั้งสองขา เช่น structured data หรือลิงก์ภายใน วิธีจำง่ายๆ คือ ถ้าปัญหานั้นทำให้บอท “เข้าไม่ถึงหรืออ่านไม่ได้” ให้นับเป็น technical ถ้าบอทอ่านได้แล้วแต่ “ไม่เข้าใจหรือไม่เลือก” ให้ดูที่ on-page และ off-page The Art of SEO บทที่ 7 ซึ่งเป็นบทที่ยาวที่สุดของเล่ม วางหลักไว้คล้ายกันว่าเว็บที่เป็นมิตรกับ search engine ต้องเริ่มจากเนื้อหาที่ crawl ได้ก่อน แล้วค่อยถึงเรื่อง keyword และเนื้อหา
Google ทำงาน 4 ขั้น crawl → render → index → serve และแต่ละขั้นพังตรงไหน
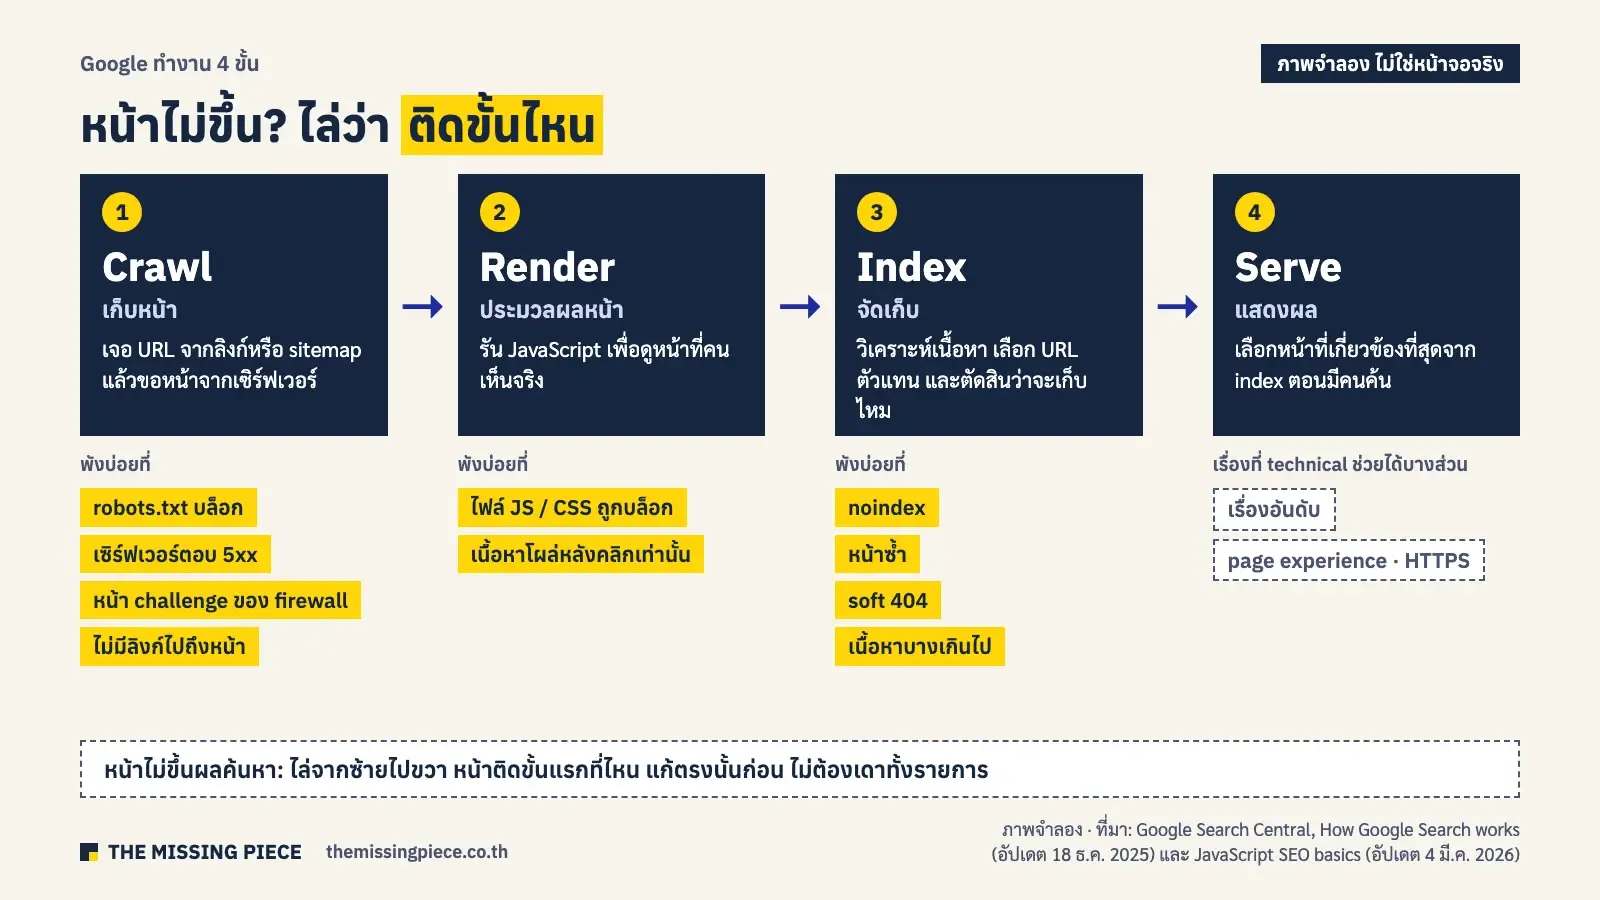
Google Search ทำงานเป็นขั้นต่อกัน และไม่ใช่ทุกหน้าที่ผ่านทุกขั้น เอกสาร How Google Search works (18 ธ.ค. 2025) แบ่งเป็น 3 ขั้น คือ crawl, index และ serve ส่วนเอกสาร JavaScript SEO basics (4 มี.ค. 2026) เพิ่มขั้น render ระหว่าง crawl กับ index สำหรับหน้าที่ใช้ JavaScript เราจึงใช้ 4 ขั้นนี้เป็นแกนของเช็กลิสต์ทั้งบทความ (เรื่องพื้นฐานของ search engine อ่านเพิ่มที่ Search Engine คืออะไร ทำงานอย่างไร)
- Crawl (การเก็บหน้า): Googlebot เจอ URL จากลิงก์หรือ sitemap แล้วขอหน้านั้นจากเซิร์ฟเวอร์ พังได้จาก robots.txt บล็อก, เซิร์ฟเวอร์ตอบ 5xx, หน้ายืนยันว่าเป็นคน (challenge) ของ firewall หรือไม่มีลิงก์ไปถึงหน้า
- Render (การประมวลผลหน้า): Google รัน JavaScript เพื่อดูหน้าที่คนเห็นจริง พังได้จากไฟล์ JS/CSS ที่ถูกบล็อก หรือเนื้อหาที่โผล่หลังผู้ใช้คลิกเท่านั้น
- Index (การจัดเก็บ): Google วิเคราะห์เนื้อหา เลือก URL ตัวแทน (canonical) และตัดสินว่าจะเก็บไหม พังได้จาก noindex, หน้าซ้ำ, soft 404 (หน้าที่ตอบ 200 แต่ไม่มีเนื้อหาจริง) หรือเนื้อหาบางเกินไป
- Serve (การแสดงผล): เมื่อมีคนค้น Google เลือกหน้าที่เกี่ยวข้องที่สุดจาก index ขั้นนี้คือเรื่องอันดับ ซึ่ง technical ช่วยได้บางส่วน เช่น page experience และ HTTPS
AI SEO For Dummies บทที่ 2 ใช้ลำดับคล้ายกัน (crawl → index → rank แล้วมีการจัดลำดับซ้ำในฝั่ง AI) และย้ำว่าเนื้อหาสำคัญควรอยู่ใน HTML ที่เซิร์ฟเวอร์ส่งมา ส่วน The Art of SEO บทที่ 3 อธิบายเส้นทางจากคำค้นไปถึง index และหน้าผลการค้นหาในแบบเดียวกัน ข้อดีของการคิดเป็นขั้นคือ เวลาหน้าไม่ขึ้น เราไล่ได้ว่าติดขั้นไหน ไม่ต้องเดาทั้งรายการ
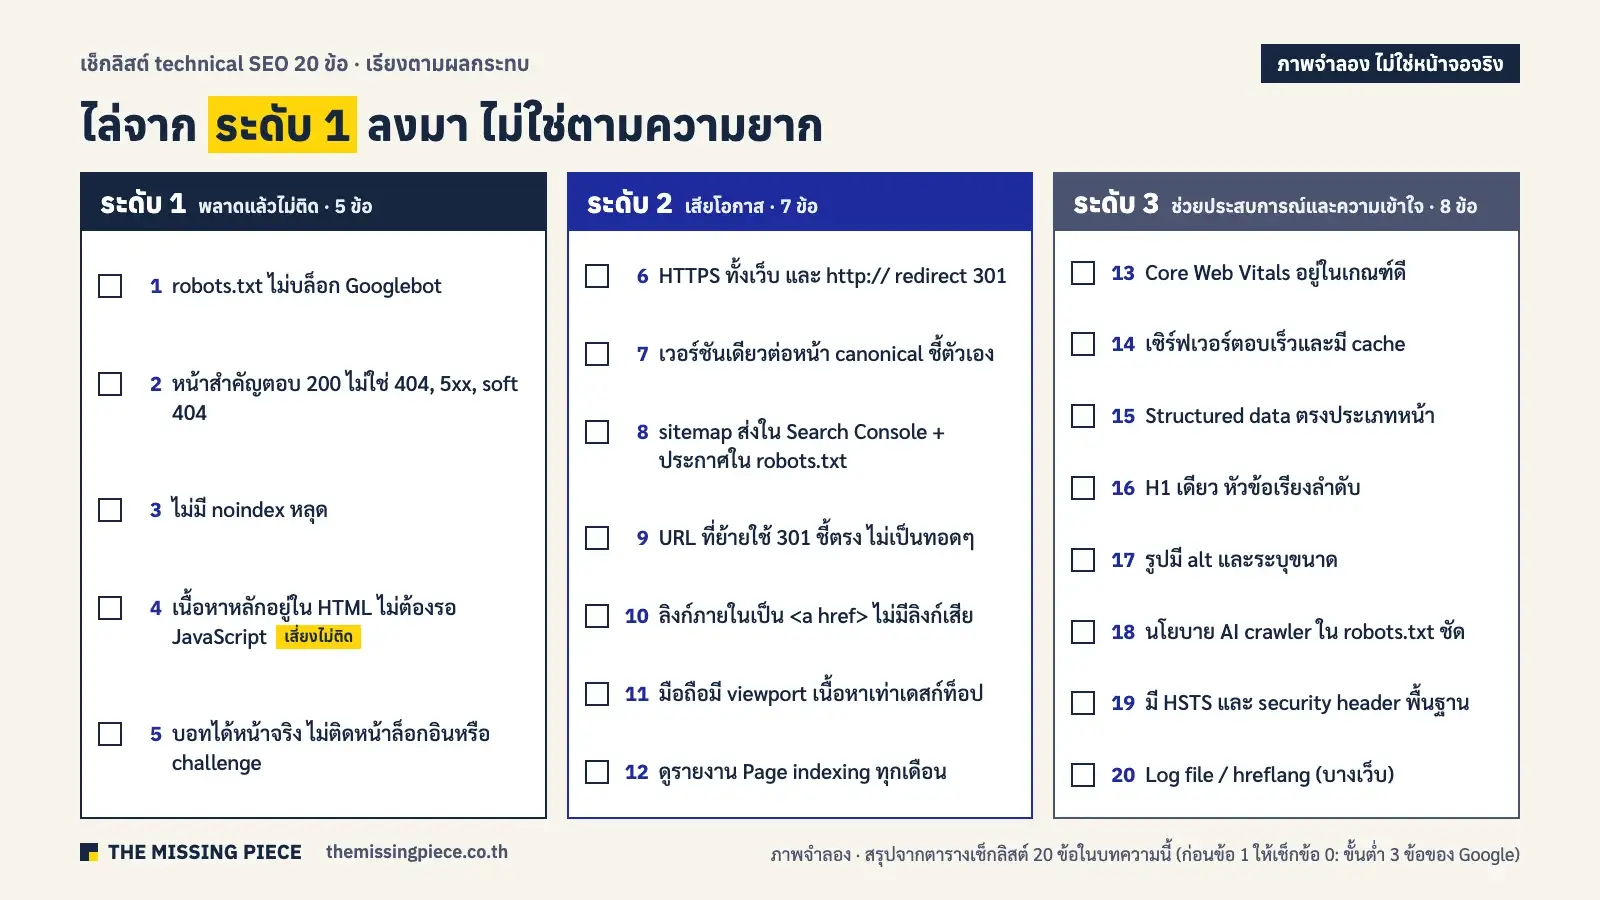
เช็กลิสต์ technical SEO 20 ข้อ เรียงตามลำดับที่ควรแก้
เช็กลิสต์ technical SEO นี้เรียงตามผลกระทบ ไม่ได้เรียงตามความยาก เริ่มจากข้อ 0 คือขั้นต่ำ 3 ข้อของ Google แล้วต่อด้วยระดับ 1 ที่ถ้าพลาดหน้าจะไม่ติดเลย ต่อด้วยระดับ 2 ที่ทำให้ Google เลือกผิดหน้าหรือเสียโอกาส และระดับ 3 ที่ช่วยประสบการณ์และความเข้าใจ เว็บเล็กส่วนใหญ่ตรวจระดับ 1–2 ได้ในวันเดียวด้วยเครื่องมือฟรี
ข้อ 0: ขั้นต่ำ 3 ข้อที่ Google ต้องการ (Search Essentials)
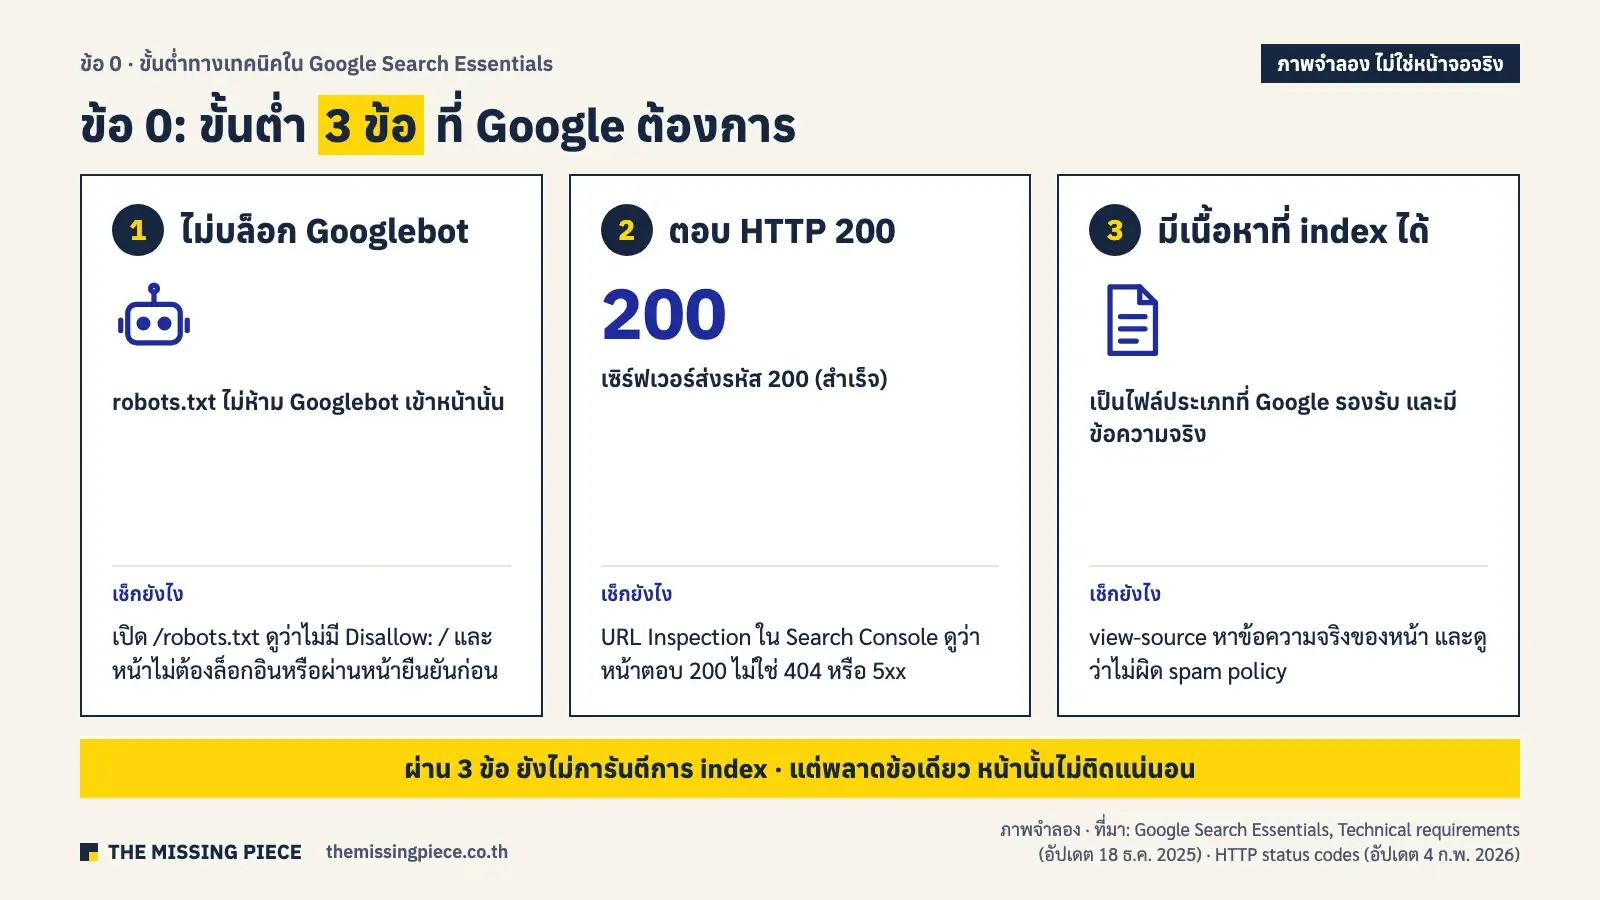
ข้อกำหนดทางเทคนิคใน Search Essentials ของ Google มีแค่ 3 ข้อ และเป็นจุดเริ่มของการตรวจทุกครั้ง หน้าไหนไม่ผ่าน 3 ข้อนี้ จะไม่มีสิทธิ์ขึ้นผลค้นหาเลย เอกสารหน้านี้อัปเดตล่าสุด 18 ธ.ค. 2025
- Googlebot ไม่ถูกบล็อก: robots.txt ไม่ห้าม Googlebot เข้าหน้านั้น และหน้าไม่ต้องล็อกอินหรือผ่านหน้ายืนยันก่อน
- หน้าตอบ HTTP 200: เซิร์ฟเวอร์ส่งรหัส 200 (สำเร็จ) ไม่ใช่ 404 หรือ 5xx
- มีเนื้อหาที่ index ได้: เป็นไฟล์ประเภทที่ Google รองรับ มีข้อความจริง และไม่ผิด spam policy
ผ่าน 3 ข้อนี้ไม่ได้แปลว่าหน้าจะถูก index เอกสาร HTTP status codes ของ Google (อัปเดต 4 ก.พ. 2026) บอกตรงๆ ว่ารหัส 2xx ไม่รับประกันการ index แต่ถ้าพลาดข้อใดข้อหนึ่ง หน้านั้นหลุดแน่นอน เราจึงจัด 3 ข้อนี้เป็น “ข้อ 0” ก่อนเช็กลิสต์อื่นทั้งหมด
ข้อ 1–20 เรียงตามผลกระทบ
| # | เช็ก | ระดับ | เช็กยังไง (ฟรี) |
|---|---|---|---|
| 1 | robots.txt ไม่บล็อก Googlebot | 1 พลาด = ไม่ติด | เปิด /robots.txt ดูว่าไม่มี Disallow: / สำหรับ Googlebot หรือ * |
| 2 | หน้าสำคัญตอบ 200 ไม่ใช่ 404, 5xx หรือ soft 404 | 1 พลาด = ไม่ติด | URL Inspection ใน Search Console |
| 3 | ไม่มี noindex หลุด | 1 พลาด = ไม่ติด | ดู source หาคำว่า noindex · รายงาน Page indexing |
| 4 | เนื้อหาหลักอยู่ใน HTML ไม่ต้องรอ JavaScript | 1 เสี่ยงไม่ติด (Google render ได้ แต่ AI crawler หลายตัวไม่รัน JavaScript) | view-source แล้วค้นประโยคในเนื้อหา |
| 5 | บอทได้หน้าจริง ไม่ติดหน้าล็อกอินหรือหน้า challenge | 1 พลาด = ไม่ติด | URL Inspection ดูภาพหน้าที่ Google เห็น |
| 6 | HTTPS ทั้งเว็บ และ http:// redirect 301 ไป https:// | 2 เสียโอกาส | ใช้เว็บเช็ก redirect หรือ curl -I http://โดเมนของคุณ ต้องเห็น 301 ไป https (อย่าเช็กด้วยการพิมพ์ใน Chrome อย่างเดียว) |
| 7 | มีเวอร์ชันเดียวของแต่ละหน้า (www, slash, parameter) และ canonical ชี้ตัวเอง | 2 เสียโอกาส | ดู rel="canonical" ใน source |
| 8 | มี sitemap ส่งใน Search Console และประกาศใน robots.txt | 2 เสียโอกาส | รายงาน Sitemaps |
| 9 | URL ที่ย้ายแล้วใช้ 301 ชี้ตรงไปปลายทาง ไม่เป็นทอดๆ | 2 เสียโอกาส | log 404 ของปลั๊กอิน SEO · crawler ฟรี |
| 10 | ลิงก์ภายในเป็น <a href> และไม่มีลิงก์เสีย | 2 เสียโอกาส | crawler ฟรี |
| 11 | มือถือมี viewport และเนื้อหาเท่าเดสก์ท็อป | 2 เสียโอกาส | เปิดบนมือถือเทียบกับเดสก์ท็อป |
| 12 | ดูรายงาน Page indexing ทุกเดือน | 2 เสียโอกาส | Search Console |
| 13 | Core Web Vitals อยู่ในเกณฑ์ดี | 3 ช่วยประสบการณ์ | PageSpeed Insights · รายงาน Core Web Vitals |
| 14 | เซิร์ฟเวอร์ตอบเร็วและมี cache | 3 ช่วยประสบการณ์ | PageSpeed Insights ดู TTFB (เวลาที่เซิร์ฟเวอร์เริ่มตอบ) |
| 15 | Structured data ตรงประเภทหน้า | 3 ช่วยความเข้าใจ | Rich Results Test |
| 16 | H1 เดียวต่อหน้า และหัวข้อเรียงลำดับ | 3 ช่วยความเข้าใจ | ดู source หรือส่วนขยายเบราว์เซอร์ |
| 17 | รูปมี alt และระบุขนาด | 3 ช่วยความเข้าใจ | ดู source |
| 18 | นโยบาย AI crawler ใน robots.txt ชัดเจน | 3 ช่วยการถูกพบใน AI | เปิด /robots.txt |
| 19 | มี HSTS และ security header พื้นฐาน | 3 ความปลอดภัย | ตัวตรวจ header ฟรี · ถามโฮสต์ |
| 20 | Log file (เว็บใหญ่) และ hreflang (เว็บหลายภาษา) | 3 เฉพาะบางเว็บ | ขอ access log จากโฮสต์ |
ลำดับ 3 ระดับนี้เราจัดเองจากผลกระทบตามเอกสาร Google และสอดคล้องกับคำแนะนำใน AI SEO For Dummies บทที่ 11 ที่ให้เลือกแก้ปัญหาใหญ่ 3 อันดับแรกก่อน แล้วเขียนเป็นงานที่มีขั้นตอนชัด แทนการไล่แก้ทุกข้อพร้อมกัน ส่วนหัวข้อถัดไปอธิบายแต่ละกลุ่ม และลิงก์ไปบทความที่ลงลึกเรื่องนั้น
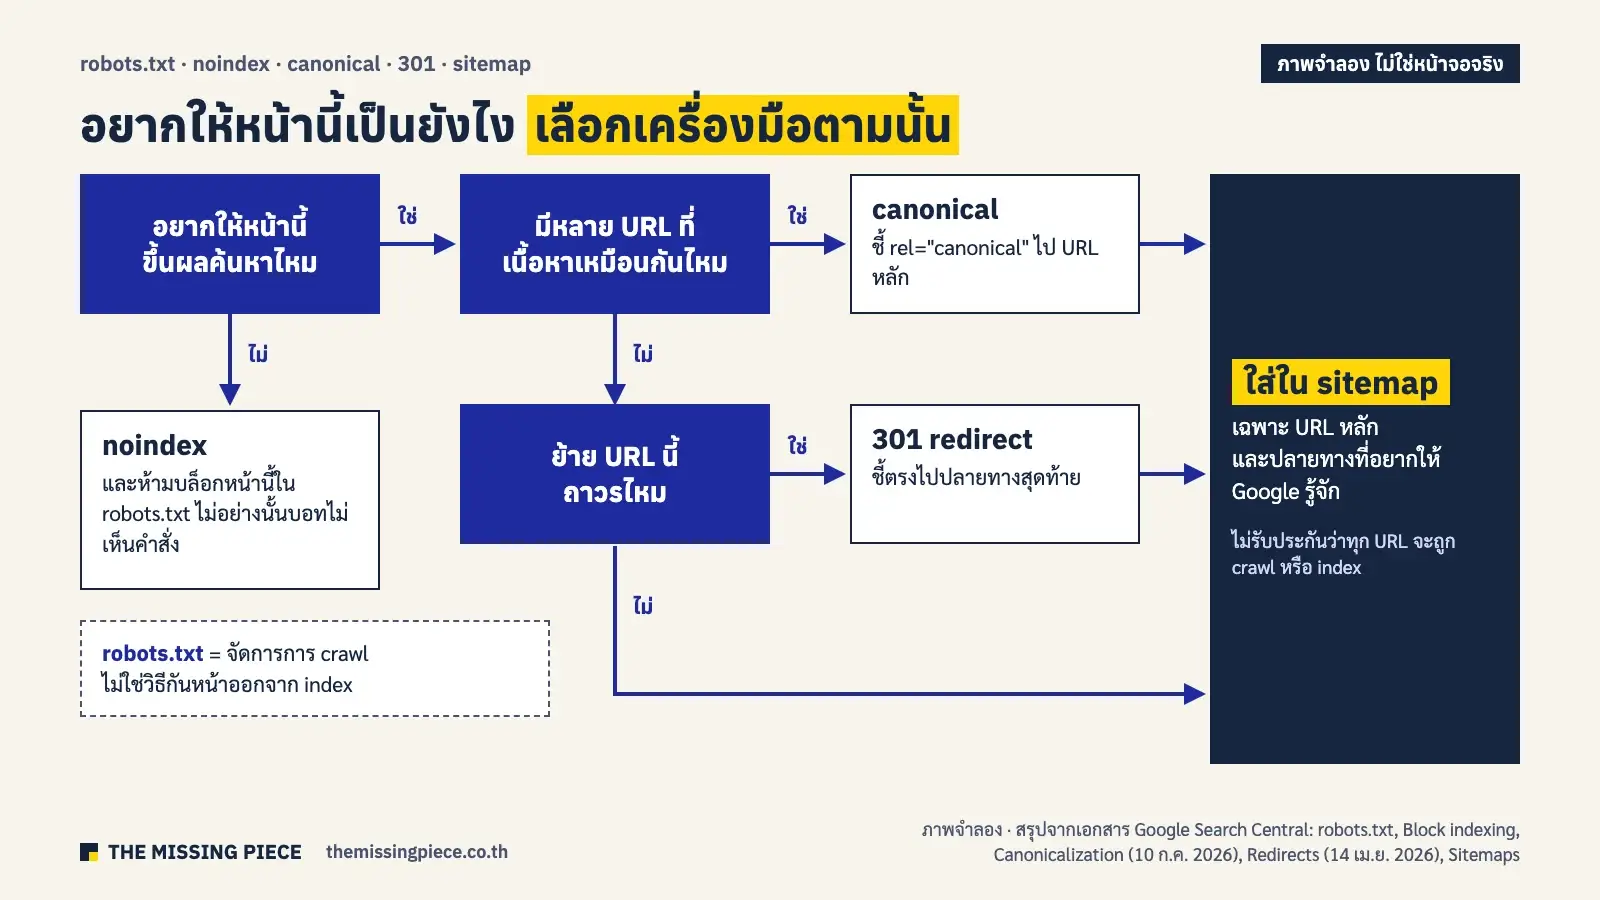
robots.txt, noindex, canonical, redirect และ sitemap ใช้อันไหนเมื่อไร
robots.txt, noindex, canonical, redirect และ sitemap เป็นเครื่องมือ 5 ตัวที่ใช้บอก Google ว่าควรเก็บหรือไม่เก็บหน้าไหน คนสับสนบ่อยเพราะแต่ละตัวทำงานคนละขั้น ใช้ผิดตัวจะได้ผลตรงข้ามกับที่ต้องการ ตารางนี้สรุปจากเอกสาร Google ฉบับปัจจุบัน
| เครื่องมือ | ทำงานขั้นไหน | ใช้เมื่อ | ข้อควรระวัง |
|---|---|---|---|
| robots.txt | Crawl | ไม่อยากให้บอทเปลืองแรงกับส่วนที่ไม่จำเป็น เช่น หน้าค้นหาภายใน | ไม่ใช่วิธีกันหน้าออกจาก Google |
| noindex | Index | ไม่อยากให้หน้านั้นขึ้นผลค้นหา | หน้านั้นต้องไม่ถูกบล็อกใน robots.txt ไม่อย่างนั้นบอทไม่เห็นคำสั่ง |
| canonical | Index | มีหลาย URL ที่เนื้อหาเหมือนกัน และอยากบอกว่าอันไหนคือตัวหลัก | เป็นสัญญาณ ไม่ใช่คำสั่ง Google อาจเลือกเอง |
| 301 redirect | Crawl + Index | ย้าย URL ถาวร | ชี้ตรงไปปลายทางสุดท้าย ไม่ทำเป็นทอด |
| sitemap | Crawl | บอกรายการ URL ที่อยากให้ Google รู้จัก | ไม่รับประกันว่าทุก URL จะถูก crawl หรือ index |
robots.txt กับ noindex: robots.txt คือไฟล์ที่บอกบอทว่าห้ามเข้าส่วนไหนของเว็บ แต่เอกสาร robots.txt ของ Google (อัปเดต 10 ธ.ค. 2025) บอกว่าไฟล์นี้ไม่ใช่กลไกกันหน้าออกจาก Google เพราะ URL ที่ถูกบล็อกยังขึ้นผลค้นหาได้ถ้ามีลิงก์จากที่อื่น ถ้าไม่อยากให้หน้าขึ้นผลค้นหา ให้ใช้ noindex หรือใส่รหัสผ่าน และเอกสาร noindex บอกว่าหน้านั้นต้องไม่ถูกบล็อกใน robots.txt ด้วย บทความ Robots.txt คืออะไร (ฉบับทั่วไป) ลงรายละเอียดคำสั่งแต่ละบรรทัด ส่วนการตั้งค่าสำหรับ bot ของ AI อยู่ที่ robots.txt สำหรับ AI bots
Canonical และหน้าซ้ำ: Canonical คือ URL ตัวแทนที่ Google เลือกเก็บเมื่อเจอหลาย URL ที่เนื้อหาเหมือนกัน เช่น มีและไม่มี www หรือมี parameter ต่อท้าย เอกสาร Google (อัปเดต 10 ก.ค. 2026) บอกว่าถ้าเราไม่ระบุ Google จะเลือกเวอร์ชันที่เห็นว่าดีที่สุดเอง และ redirect เป็นสัญญาณที่แรงที่สุด รองลงมาคือ rel="canonical" รายละเอียดการตั้งและการไล่ปัญหาจะอยู่ในบทความ Canonical Tag คืออะไร
301 redirect: 301 redirect คือการบอกว่า URL นี้ย้ายไปที่ใหม่ถาวร เอกสาร Redirects ของ Google (อัปเดต 14 เม.ย. 2026) แนะนำให้ใช้ redirect แบบถาวรที่ฝั่งเซิร์ฟเวอร์ทุกครั้งที่ทำได้ ใช้เมื่อเปลี่ยน slug ย้ายโดเมน หรือรวมบทความ ส่วนการเลือก 301 กับ 302 และการวางแผนย้ายเว็บ จะอยู่ในบทความ 301 Redirect ใช้เมื่อไร
Sitemap และ crawl budget: Sitemap คือไฟล์รายการ URL ที่เราอยากให้ Google รู้จัก เอกสาร Google (10 ธ.ค. 2025) บอกว่าเว็บเล็กราว 500 หน้าหรือน้อยกว่าที่ลิงก์ภายในครบ อาจไม่จำเป็นต้องมี แต่ส่วนใหญ่ปลั๊กอิน SEO ของ WordPress สร้างให้อยู่แล้ว วิธีสร้าง ส่ง และอ่านรายงานอยู่ที่ Sitemap คืออะไร สร้างและส่งยังไง ส่วน crawl budget (จำนวนหน้าที่ Google พร้อม crawl ในช่วงเวลาหนึ่ง) เอกสาร Google (22 ก.ค. 2026) เขียนสำหรับเว็บที่มีมากกว่า 1 ล้านหน้า มากกว่า 10,000 หน้าที่เปลี่ยนทุกวัน หรือเว็บที่มี URL สถานะ “Discovered – currently not indexed” จำนวนมาก (Google บอกว่าไม่ใช่เกณฑ์ตายตัว) เว็บ SME ส่วนใหญ่จึงไม่ต้องกังวล ยกเว้นเจอสถานะนี้เยอะใน Search Console
Status code ไหนทำให้หน้าหลุดจาก Google (รวม soft 404)
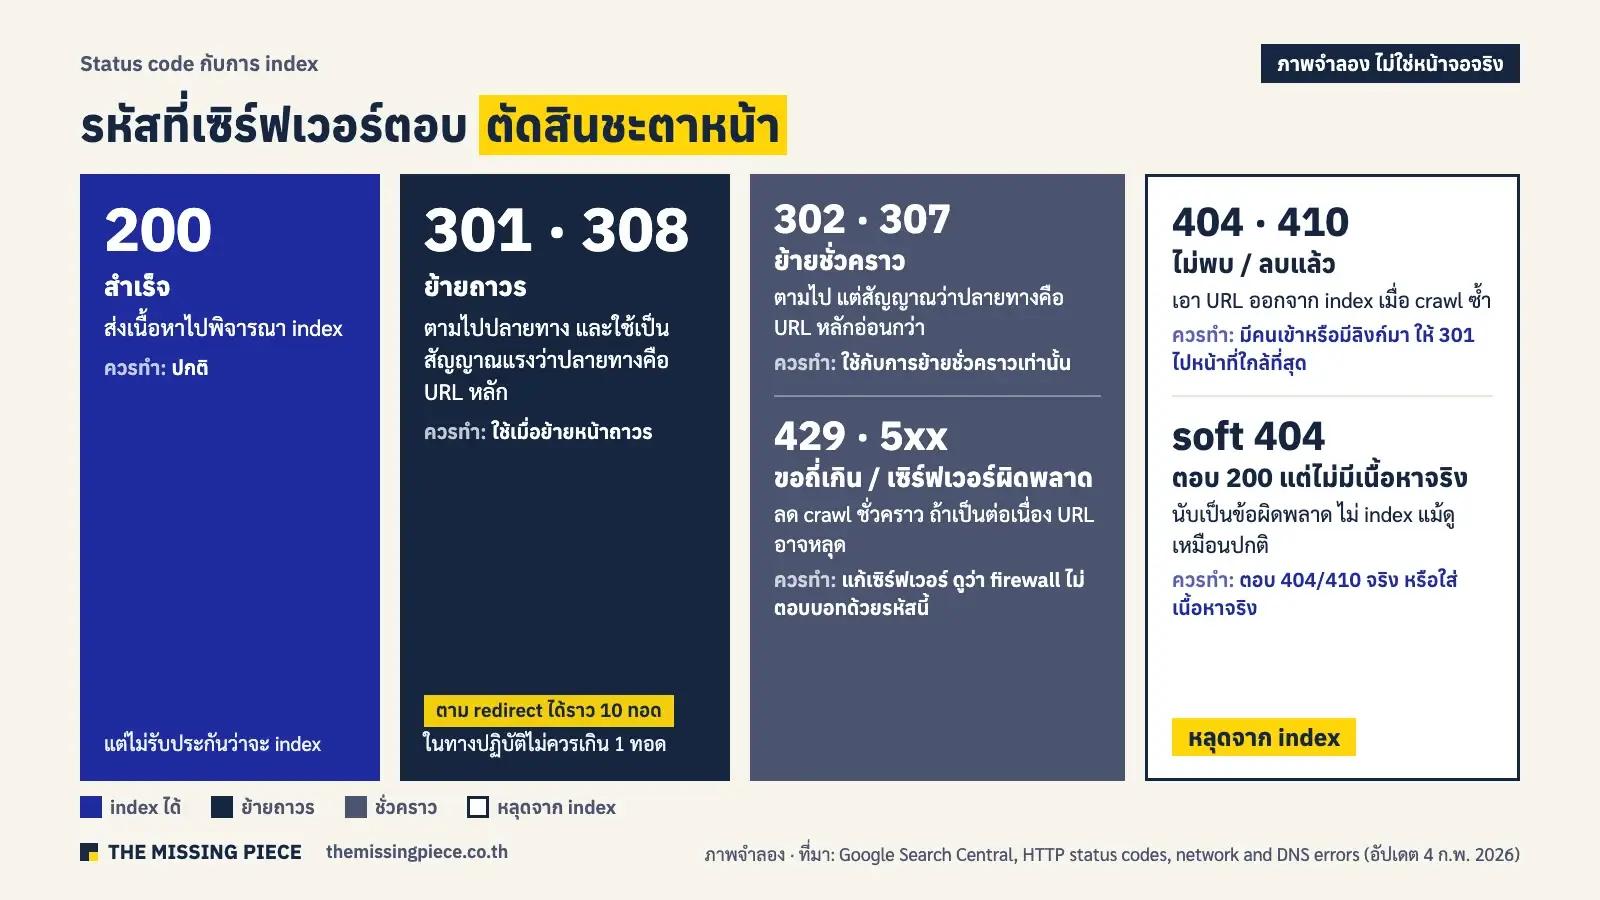
Status code คือรหัสสามหลักที่เซิร์ฟเวอร์ตอบกลับทุกครั้งที่มีคนหรือบอทขอหน้า Google ใช้รหัสนี้ตัดสินว่าจะเก็บ ย้าย หรือทิ้งหน้านั้น ตารางนี้สรุปจากเอกสาร HTTP status codes, network and DNS errors ของ Google (อัปเดต 4 ก.พ. 2026)
| รหัส | ความหมาย | Google ทำอะไร | ควรทำ |
|---|---|---|---|
| 200 | สำเร็จ | ส่งเนื้อหาไปพิจารณา index แต่ไม่รับประกันว่าจะ index | ปกติ |
| 301 / 308 | ย้ายถาวร | ตามไปปลายทาง และใช้เป็นสัญญาณแรงว่าปลายทางคือ URL หลัก | ใช้เมื่อย้ายหน้าถาวร |
| 302 / 307 | ย้ายชั่วคราว | ตามไปปลายทาง แต่สัญญาณว่าปลายทางคือ URL หลักอ่อนกว่า | ใช้กับการย้ายชั่วคราวเท่านั้น |
| 404 / 410 | ไม่พบ / ลบแล้ว | เอา URL ออกจาก index เมื่อ crawl ซ้ำ | ถ้ามีคนเข้าหรือมีลิงก์มา ให้ 301 ไปหน้าที่ใกล้ที่สุด |
| 429 / 5xx | ขอถี่เกิน / เซิร์ฟเวอร์ผิดพลาด | ลดความถี่การ crawl ชั่วคราว ถ้าเป็นต่อเนื่อง URL อาจหลุดจาก index | แก้เซิร์ฟเวอร์ ดูว่า firewall ไม่ตอบบอทด้วยรหัสนี้ |
| Soft 404 | ตอบ 200 แต่หน้าบอกว่าไม่มีเนื้อหา | นับเป็นข้อผิดพลาด ไม่ index | ตอบ 404/410 จริง หรือใส่เนื้อหาจริง |
เอกสารเดียวกันบอกว่า Googlebot ตาม redirect ได้ราว 10 ทอด ถ้าเกินนั้นจะนับเป็นข้อผิดพลาด ในทางปฏิบัติไม่ควรมีเกิน 1 ทอดอยู่แล้ว เพราะแต่ละทอดเพิ่มเวลาโหลดให้คนอ่านด้วย ส่วน soft 404 เจอบ่อยในเว็บร้านค้าที่สินค้าหมดแล้วยังตอบ 200 พร้อมข้อความ “ไม่พบสินค้า” รายงาน Page indexing ใน Google Search Console จะแยกให้ว่าหน้าไหนเป็น soft 404, 404 หรือ 5xx
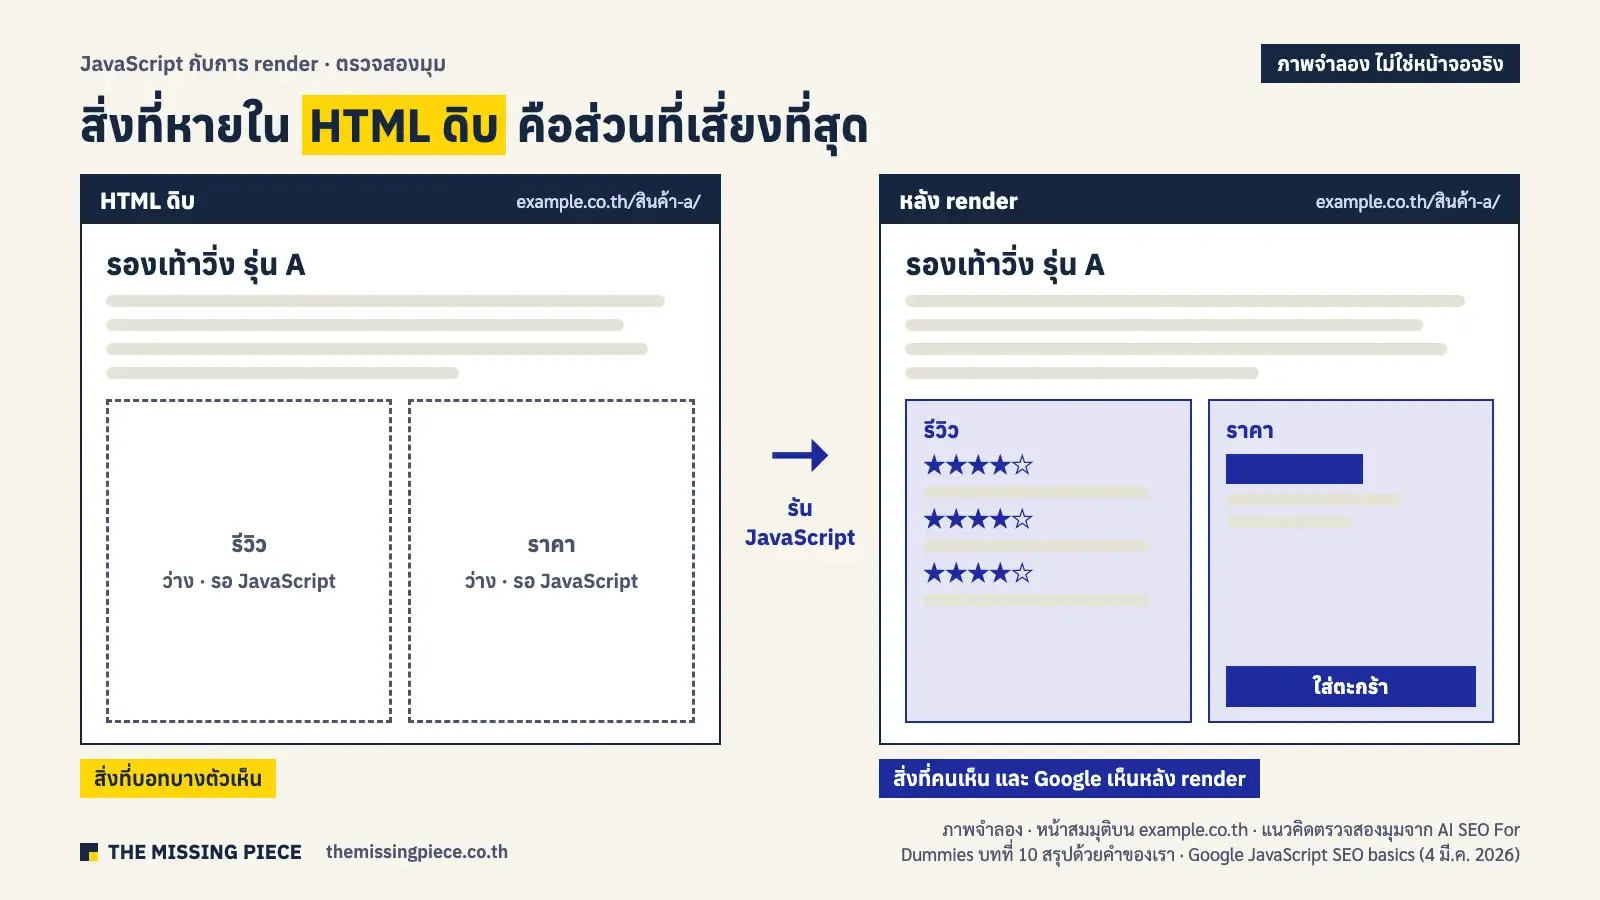
JavaScript กับการ render: Google อ่านได้ แต่อย่าฝากเนื้อหาสำคัญไว้กับ JS
การ render คือขั้นที่ระบบค้นหารัน JavaScript เพื่อสร้างหน้าเว็บแบบที่คนเห็นจริง เว็บแบบ single-page app ที่สร้างด้วย React หรือ Vue, page builder บางตัว หรือระบบร้านค้าสำเร็จรูป มักต้องพึ่งขั้นนี้ เอกสาร JavaScript SEO basics ของ Google (อัปเดต 4 มี.ค. 2026) บอกว่า Google ประมวลผลเว็บแบบ JavaScript ใน 3 ระยะ คือ crawl, render และ index และยังแนะนำว่าการ render ฝั่งเซิร์ฟเวอร์ (server-side rendering) หรือ pre-render เป็นแนวทางที่ดี
วิธีเช็กง่ายที่สุดคือเปิดหน้าแล้วดู view-source (ไม่ใช่ Inspect) แล้วค้นประโยคจากเนื้อหาหลัก ถ้าเจอใน source แปลว่าเนื้อหาอยู่ใน HTML จากเซิร์ฟเวอร์ ถ้าไม่เจอ แปลว่าต้องรอ JavaScript ทำงานก่อน WordPress ที่ใช้ธีมทั่วไปส่งเนื้อหาใน HTML อยู่แล้ว ปัญหามักอยู่ที่ส่วนที่โหลดภายหลัง เช่น รีวิว ราคา หรือแท็บที่ต้องคลิก
AI SEO For Dummies บทที่ 10 แนะนำให้ตรวจเว็บสองมุม คือ HTML ดิบที่ไม่รัน JavaScript กับหน้าที่ render แล้ว และเทียบกันว่าหายอะไรไป ส่วน The Art of SEO บทที่ 7 พูดเรื่อง JavaScript และ server-side rendering ไว้ละเอียด แต่เล่มนี้เขียนปี 2023 และยังพูดถึง dynamic rendering ซึ่งเอกสาร Google ปัจจุบัน (10 ธ.ค. 2025) ระบุว่าเป็นทางแก้ชั่วคราวที่ไม่แนะนำแล้ว
บอท AI ตัวไหน render JavaScript
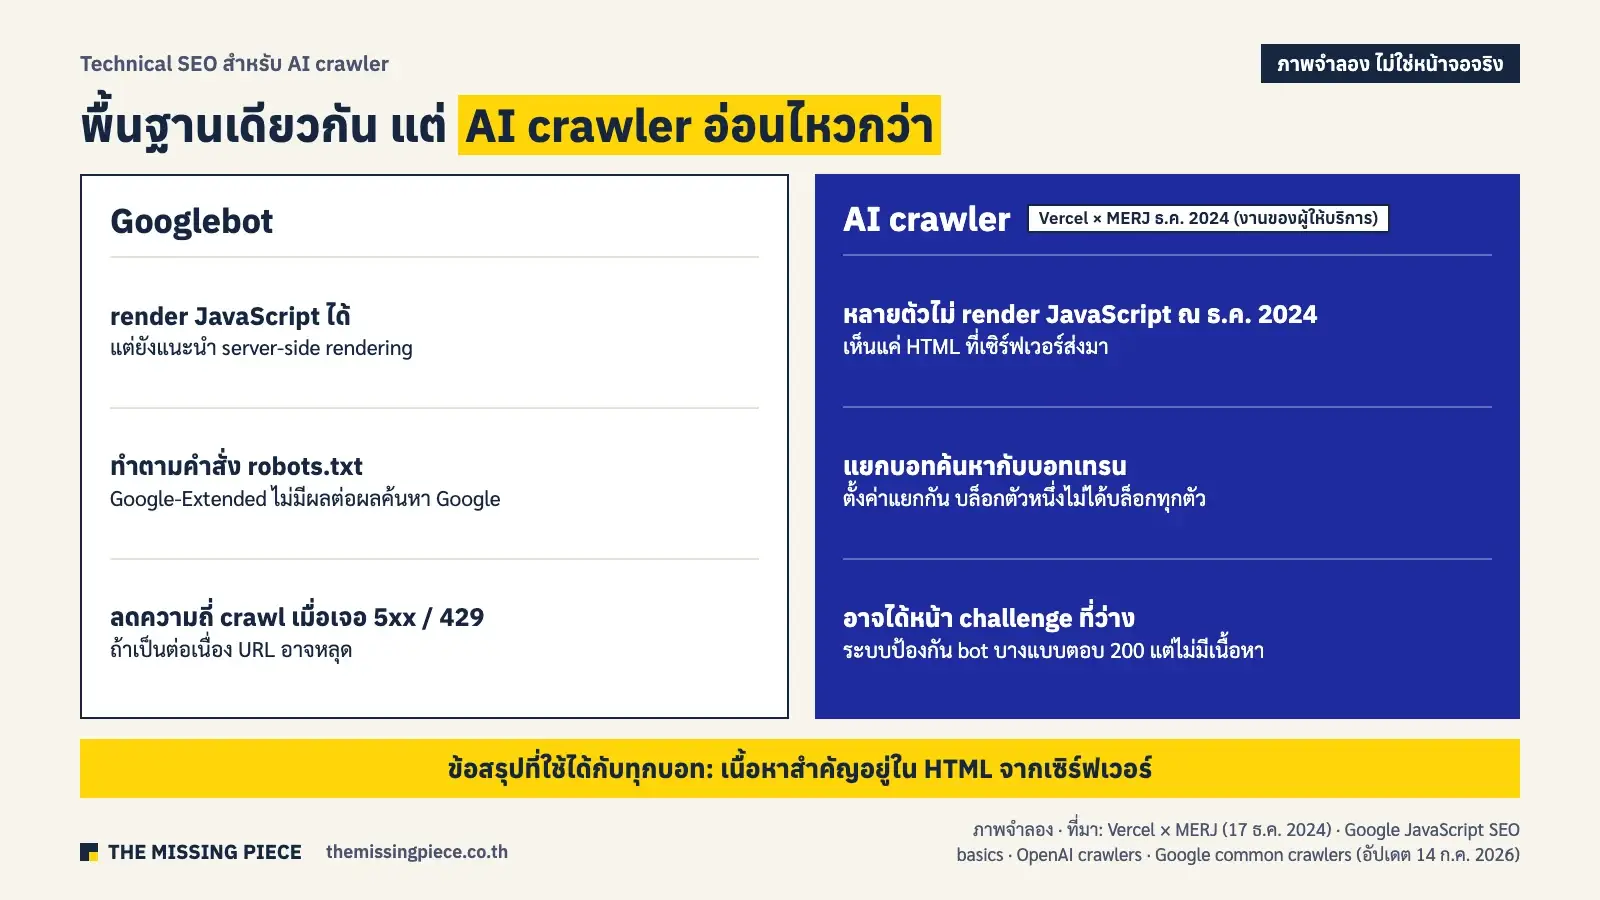
เท่าที่มีข้อมูล บอทที่ render JavaScript คือ Googlebot (รวม Gemini ที่ใช้ระบบเดียวกัน) Bingbot และ Applebot ส่วน GPTBot, ClaudeBot และ PerplexityBot ไม่ render ในงานวัดของ Vercel ร่วมกับ MERJ (17 ธ.ค. 2024) ซึ่งดูจาก log ของเครือข่าย Vercel โดยบอทของ ChatGPT และ Claude โหลดไฟล์ JavaScript แต่ไม่รัน เจ้าของบอท AI ยังไม่มีเอกสารยืนยันเรื่องนี้ ตารางนี้จึงแยกให้เห็นว่าแต่ละช่องมาจากเอกสารทางการหรือจากงานวัดของผู้ให้บริการ
| บอท | ใช้ทำอะไร | Render JavaScript ไหม | ที่มา |
|---|---|---|---|
| Googlebot | Google Search | Render ด้วย Chromium รุ่นที่อัปเดตตลอด (evergreen) | Google, JavaScript SEO basics (อัปเดต 4 มี.ค. 2026) |
| Google-Extended | ชื่อสำหรับใส่ใน robots.txt (token) คุมการใช้ข้อมูลกับ Gemini ไม่ใช่บอท ไม่มี user agent แยก | ไม่เกี่ยว การ crawl ทำโดยบอทตัวอื่นของ Google | Google, Google’s common crawlers (อัปเดต 15 ต.ค. 2026) |
| Bingbot | Bing | Render ด้วยเอนจินของ Microsoft Edge | Bing Webmaster Blog (9 ต.ค. 2019 ยังไม่พบประกาศใหม่กว่า) |
| Applebot | Siri, Spotlight, Safari และอาจใช้เทรนโมเดลของ Apple (ปิดได้ด้วย Applebot-Extended) | Apple ระบุว่า “อาจ” render ในเบราว์เซอร์ · Vercel × MERJ รายงานว่า render ผ่าน crawler แบบเบราว์เซอร์ | Apple, About Applebot (4 ก.ย. 2026) · Vercel × MERJ (17 ธ.ค. 2024) |
| GPTBot · OAI-SearchBot · ChatGPT-User | OpenAI: เทรนโมเดล · ค้นหาใน ChatGPT · เปิดหน้าเมื่อผู้ใช้สั่ง | ไม่ render ในงานวัด ธ.ค. 2024 (คำขอของ ChatGPT 11.50% เป็นไฟล์ JS แต่ไม่รัน) · เอกสาร OpenAI ไม่ระบุ | Vercel × MERJ (17 ธ.ค. 2024) · OpenAI crawlers (ไม่ระบุวันที่ ตรวจ 16 ต.ค. 2026) |
| ClaudeBot | Anthropic: เทรนโมเดล | ไม่ render ในงานวัด ธ.ค. 2024 (คำขอของ Claude 23.84% เป็นไฟล์ JS แต่ไม่รัน) · เอกสาร Anthropic ไม่ระบุ | Vercel × MERJ (17 ธ.ค. 2024) · Anthropic Help Center (7 เม.ย. 2026) |
| Claude-SearchBot · Claude-User · Perplexity-User | Anthropic: ค้นหา · Anthropic และ Perplexity: เปิดหน้าเมื่อผู้ใช้สั่ง | ไม่มีเอกสารยืนยัน (ไม่อยู่ในงานวัดปี 2024) | Anthropic Help Center (7 เม.ย. 2026) · Perplexity Crawlers (ตรวจ 16 ต.ค. 2026) |
| PerplexityBot | ค้นหาใน Perplexity | ไม่ render ในงานวัด ธ.ค. 2024 · เอกสาร Perplexity ไม่ระบุ | Vercel × MERJ (17 ธ.ค. 2024) · Perplexity Crawlers (ไม่ระบุวันที่ ตรวจ 16 ต.ค. 2026) |
ข้อสรุปที่ใช้ได้เลยโดยไม่ต้องรอข้อมูลใหม่คือ ถ้าเนื้อหา ราคา หรือลิงก์สำคัญต้องรอ JavaScript ก่อนจะโผล่ ให้ถือว่าบอท AI บางตัวไม่เห็น ส่วนการเปิดหรือปิดบอทแต่ละตัวเป็นอีกเรื่อง อ่านที่ robots.txt สำหรับ AI bots และถ้าเป้าหมายคือถูกอ้างใน ChatGPT อ่านต่อที่ ChatGPT SEO คืออะไร
เช็กว่าบอทเห็นอะไร: HTML ดิบเทียบหน้าที่ render
ขั้นตอนนี้ต่อยอดวิธี view-source และการตรวจสองมุมจาก AI SEO For Dummies บทที่ 10 ข้างบน
- ดู HTML ดิบแบบบอทที่ไม่รัน JavaScript: ใช้ curl ดึงหน้าโดยตั้ง User-Agent (ชื่อที่โปรแกรมแจ้งเซิร์ฟเวอร์ว่าเป็นใคร) เป็นชื่อบอท แล้วค้นประโยคจากเนื้อหาหลัก (grep -c นับจำนวนบรรทัดที่เจอ) ได้ 0 แปลว่าประโยคนั้นไม่อยู่ใน HTML จากเซิร์ฟเวอร์
- ดูหน้าที่ Google render แล้ว: ใน Search Console ใช้ URL Inspection กด Test live URL แล้ว View tested page เพื่อดู HTML ที่ render แล้วและภาพหน้าจอ ส่วน View crawled page คือเวอร์ชันที่ Google crawl ครั้งล่าสุด ดูได้เฉพาะหน้าที่อยู่ใน Google แล้ว
- เทียบสองฝั่ง: ส่วนที่มีในหน้า render แต่ไม่มีใน HTML ดิบ คือส่วนที่ Google เห็นแต่บอท AI ที่ไม่รัน JavaScript อาจไม่เห็น ทางแก้คือ render ฝั่งเซิร์ฟเวอร์หรือ pre-render ส่วนนั้น
curl -sL -A "Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbot" https://example.com/ | grep -c "ประโยคจากเนื้อหาหลัก"ข้อควรระวัง: การตั้ง User-Agent เองไม่ได้ทำให้เราเป็นบอทตัวจริง OpenAI, Anthropic และ Perplexity เผยแพร่ช่วง IP ของบอทเป็นไฟล์ JSON และระบบกันบอทหลายแบบตรวจ IP ด้วย ผลจาก curl จึงอาจต่างจากที่บอทจริงได้รับได้ทั้งสองทาง (วิธีเทียบ IP กับรายการที่เจ้าของบอทเผยแพร่อยู่ใน robots.txt สำหรับ AI bots) ถ้าต้องการคำตอบที่แน่นอนให้ดู server log ว่าบอทจริงได้ status code อะไร ส่วน URL Inspection ใช้บอทชื่อ Google-InspectionTool และบอกได้แค่ฝั่ง Google
Technical SEO สำหรับ AI crawler: สิ่งที่ต่างจาก Googlebot
AI crawler คือบอทของบริษัท AI ที่เข้ามาเก็บหน้าเว็บ เพื่อใช้ตอบคำถามใน AI search หรือเพื่อเทรนโมเดล พื้นฐาน technical ชุดเดียวกับ Google ใช้ได้กับบอทกลุ่มนี้ แต่มี 4 จุดที่ต่าง และเป็นจุดที่บทความไทยที่ติดหน้าแรกวันที่เราตรวจ (15 ต.ค. 2026) ยังไม่พูดถึง (ภาพรวมว่า AI search ใช้ข้อมูลยังไง อ่านที่ LLM คืออะไร และ Google AI Mode)
- AI crawler หลายตัวไม่รัน JavaScript: งานวัดของ Vercel ร่วมกับ MERJ (ธ.ค. 2024) พบว่า GPTBot, ClaudeBot และ PerplexityBot ไม่ render JavaScript ในตอนนั้น ขณะที่ Gemini ซึ่งใช้ระบบของ Google และ AppleBot render ได้ ถึงวันที่เราตรวจ (16 ต.ค. 2026) ยังไม่มีเอกสารของ OpenAI, Anthropic หรือ Perplexity ยืนยันว่าเปลี่ยนแล้ว และเอกสาร JavaScript SEO basics ของ Google เองก็ระบุว่าบอทบางตัวรัน JavaScript ไม่ได้ เนื้อหาสำคัญจึงควรอยู่ใน HTML จากเซิร์ฟเวอร์ (ตารางบอทแต่ละตัวและวิธีเช็กอยู่ที่ บอท AI ตัวไหน render JavaScript)
- หน้ายืนยันว่าเป็นคน (challenge): ระบบป้องกัน bot บางแบบส่งหน้ายืนยันว่าเป็นคน (challenge) ที่ตอบ 200 แต่ไม่มีเนื้อหาให้ client อัตโนมัติ บอทที่ได้หน้านี้จะเห็นหน้าว่าง ในการตรวจเว็บไทยของเรา 62 เว็บ (15 ต.ค. 2026) มี 1 เว็บที่ส่งหน้า challenge พร้อม noindex ให้โปรแกรมตรวจของเรา
- แต่ละบอทแยกหน้าที่กัน: เอกสาร OpenAI ระบุว่า OAI-SearchBot ใช้สำหรับการค้นหา และการตั้งค่าแต่ละบอทแยกกัน ส่วน Google ระบุว่า Google-Extended ไม่มีผลต่อการแสดงในผลค้นหา Google (อัปเดต 15 ต.ค. 2026) บล็อกตัวหนึ่งจึงไม่ได้บล็อกทุกตัว
- เซิร์ฟเวอร์ต้องรับไหว: Google ลดความถี่ crawl เมื่อเจอ 5xx หรือ 429 ส่วนบอท AI แต่ละเจ้ายังไม่ได้เปิดเผยพฤติกรรมนี้ละเอียดเท่า เซิร์ฟเวอร์ที่ตอบช้าหรือล่มบ่อยจึงเสี่ยงกับทุกบอท
ทั่วโลกยังมีเว็บที่ระบุ GPTBot ใน robots.txt ไม่มาก Web Almanac 2025 ของ HTTP Archive พบ 4.5% ของหน้าเดสก์ท็อปและ 4.2% ของหน้ามือถือ (เพิ่มจาก 2.9% และ 2.7% ในปี 2024) ส่วนจะเปิดหรือปิดบอทไหน AI SEO For Dummies บทที่ 22 เตือนว่าการบล็อก AI crawler ทั้งหมดไม่ใช่ทางเลือกที่ฉลาดเสมอไป และบทที่ 2 ย้ำว่าไม่ใช่ทุกบอทที่เคารพ robots.txt ตารางชื่อบอทและตัวอย่างการตั้งค่าอยู่ที่ robots.txt สำหรับ AI bots
AI ตอบเรื่องนี้ว่ายังไง (สังเกต 15 ต.ค. 2026 ครั้งเดียวต่อแพลตฟอร์ม n=1 ไม่ใช่อัตรา): Google AI Overview ตอบนิยามกับเช็กลิสต์ทั่วไปและอ้างบล็อกในไทยโดยไม่อ้างเอกสาร Google ส่วน OpenAI ผ่าน API (ChatGPT) ตอบรายการ 11 ข้อโดยไม่มีแหล่งอ้างอิง และไม่พูดถึง noindex, JavaScript หรือ AI bot
HTTPS และ page experience ช่วยอันดับแค่ไหน
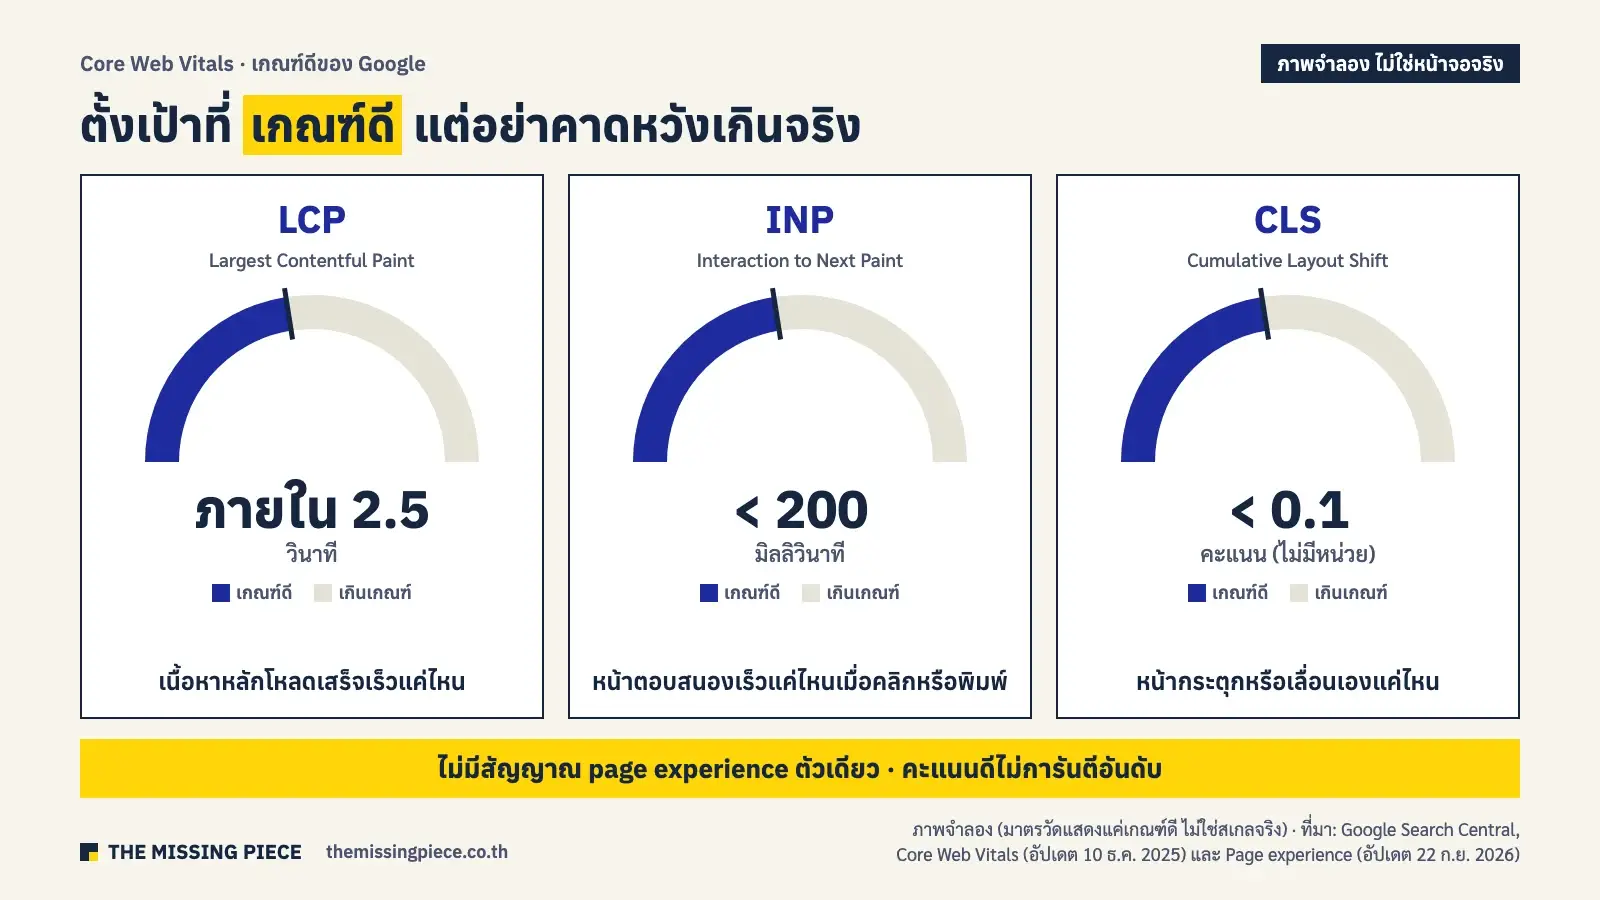
Page experience คือประสบการณ์ของคนที่เข้าหน้าเว็บ ทั้งความเร็ว ความนิ่งของหน้า ความปลอดภัย และการใช้งานบนมือถือ เอกสาร Page experience ของ Google (อัปเดต 22 ก.ย. 2026) บอก 3 อย่างที่ต้องจำ คือ ไม่มีสัญญาณ page experience ตัวเดียว ระบบจัดอันดับใช้ Core Web Vitals และคะแนนดีไม่ได้รับประกันว่าหน้าจะติดอันดับบนสุด เพราะความเกี่ยวข้องของเนื้อหายังสำคัญกว่า
| ตัวชี้วัด | วัดอะไร | เกณฑ์ดี (Google) |
|---|---|---|
| LCP (Largest Contentful Paint) | เนื้อหาหลักโหลดเสร็จเร็วแค่ไหน | ภายใน 2.5 วินาที |
| INP (Interaction to Next Paint) | หน้าตอบสนองเร็วแค่ไหนเมื่อคลิกหรือพิมพ์ | น้อยกว่า 200 มิลลิวินาที |
| CLS (Cumulative Layout Shift) | หน้ากระตุกหรือเลื่อนเองแค่ไหน | น้อยกว่า 0.1 |
ค่าเกณฑ์มาจากเอกสาร Core Web Vitals ของ Google (อัปเดต 10 ธ.ค. 2025) วิธีวัดและแก้แต่ละตัวบน WordPress อยู่ในบทความ Core Web Vitals แก้ยังไง ส่วน HTTPS เอกสาร Page experience ใส่ไว้เป็นคำถามตรวจตัวเองว่าหน้าเว็บเสิร์ฟแบบปลอดภัยไหม เว็บที่ยังเปิดด้วย http:// ได้โดยไม่ redirect ควรแก้ก่อนเรื่องความเร็ว เพราะเบราว์เซอร์จะเตือนคนอ่านว่าเว็บไม่ปลอดภัย
HSTS (HTTP Strict Transport Security) คือ header ที่บอกเบราว์เซอร์ให้เปิดเว็บด้วย HTTPS เสมอ ไม่ใช่ปัจจัยอันดับที่ Google ระบุ แต่ช่วยปิดช่องที่คนจะถูกพาไปเวอร์ชัน http เราใส่ไว้ในเช็กลิสต์ระดับ 3 เพราะในข้อมูลเว็บไทยด้านล่าง มีแค่ 30.4% ที่ตั้งไว้ และควรให้ผู้ให้บริการโฮสต์เป็นคนเปิด เพราะตั้งผิดแล้วย้อนกลับยาก
ถ้า Chrome ขึ้นคำว่า “ไม่ปลอดภัย” (Not secure) หรือหน้าเตือนเต็มจอที่เว็บของคุณ ให้เช็ก 4 อย่างนี้ ข้อ 1–3 แก้ที่ตัวเว็บและเซิร์ฟเวอร์ ส่วนข้อ 4 แก้เว็บแล้วขอให้ Google ตรวจซ้ำใน Search Console
- ใบรับรอง SSL/TLS หมดอายุหรือไม่ตรงโดเมน: ใบรับรองต้องยังไม่หมดอายุ และต้องครอบคลุมทุกชื่อที่คนเปิดได้ เช่น ทั้ง example.com และ www.example.com ถ้าใบรับรองมีปัญหา Chrome จะขึ้นหน้าเตือน “Your connection is not private” แต่ Chrome ระบุว่าหน้านี้อาจเกิดจากเว็บ เครือข่าย หรืออุปกรณ์ของคนเปิดก็ได้ จึงควรลองเปิดจากอีกเครื่องหรืออีกเครือข่ายก่อนสรุป
- Mixed content (เนื้อหาปน http ในหน้า https): หน้าเปิดด้วย https:// แต่รูป สคริปต์ หรือไฟล์ CSS บางตัวยังเรียกผ่าน http:// สคริปต์แบบนี้จะถูกเบราว์เซอร์บล็อกจนหน้าบางส่วนไม่ทำงาน ส่วนรูปที่เรียกผ่าน http อาจทำให้แถบที่อยู่ขึ้นว่าไม่ปลอดภัย ดูรายการไฟล์ได้ที่แท็บ Issues หรือ Console ใน Chrome DevTools (เครื่องมือนักพัฒนาของ Chrome เปิดด้วยการคลิกขวาที่หน้าแล้วเลือก Inspect) แล้วแก้ลิงก์ไฟล์ทั้งหมดเป็น https://
- http:// ยังไม่ redirect ไป https://: ถ้าเว็บยังเปิดแบบ http ได้ Chrome จะขึ้น “ไม่ปลอดภัย” ที่แถบที่อยู่ และ Google ประกาศว่าตั้งแต่ Chrome 154 (ต.ค. 2026) Chrome จะถามคนอ่านก่อนเปิดเว็บสาธารณะที่ไม่มี HTTPS ครั้งแรก อย่าเช็กด้วยการพิมพ์ http:// ใน Chrome อย่างเดียว เพราะ Chrome ลองเปิดเป็น https ให้เองก่อน ผลจึงอาจดูผ่านทั้งที่เซิร์ฟเวอร์ยังไม่ redirect ให้ใช้เว็บเช็ก redirect หรือคำสั่ง
curl -I http://โดเมนของคุณ(คำสั่งดูสถานะของหน้าใน Terminal) ต้องเห็นสถานะ 301 และปลายทางเป็น https ถ้ายังไม่ใช่ ให้ตั้ง 301 redirect ทุก URL ไปหน้าเดียวกันเวอร์ชัน https (วิธีเลือกและตั้งอยู่ใน 301 Redirect ใช้เมื่อไร) - Google Safe Browsing ติดธงเว็บ: ถ้าแถบที่อยู่ขึ้นว่าอันตราย (Dangerous) หรือมีหน้าแดงเต็มจอเตือน แปลว่า Google Safe Browsing ซึ่งเป็นระบบตรวจเว็บอันตรายของ Google ติดธงเว็บไว้ เช่น เว็บถูกแฮก มีมัลแวร์ หรือมีหน้าหลอกลวง ให้เปิดรายงาน Security issues ใน Google Search Console ดูตัวอย่าง URL ที่โดน แก้ให้ครบทั้งเว็บ แล้วกด Request Review (ขอให้ Google ตรวจซ้ำ) ซึ่ง Google ระบุว่าการตรวจใช้เวลาหลายวันถึงหลายสัปดาห์
Mobile-first indexing แปลว่าอะไรสำหรับเว็บคุณ
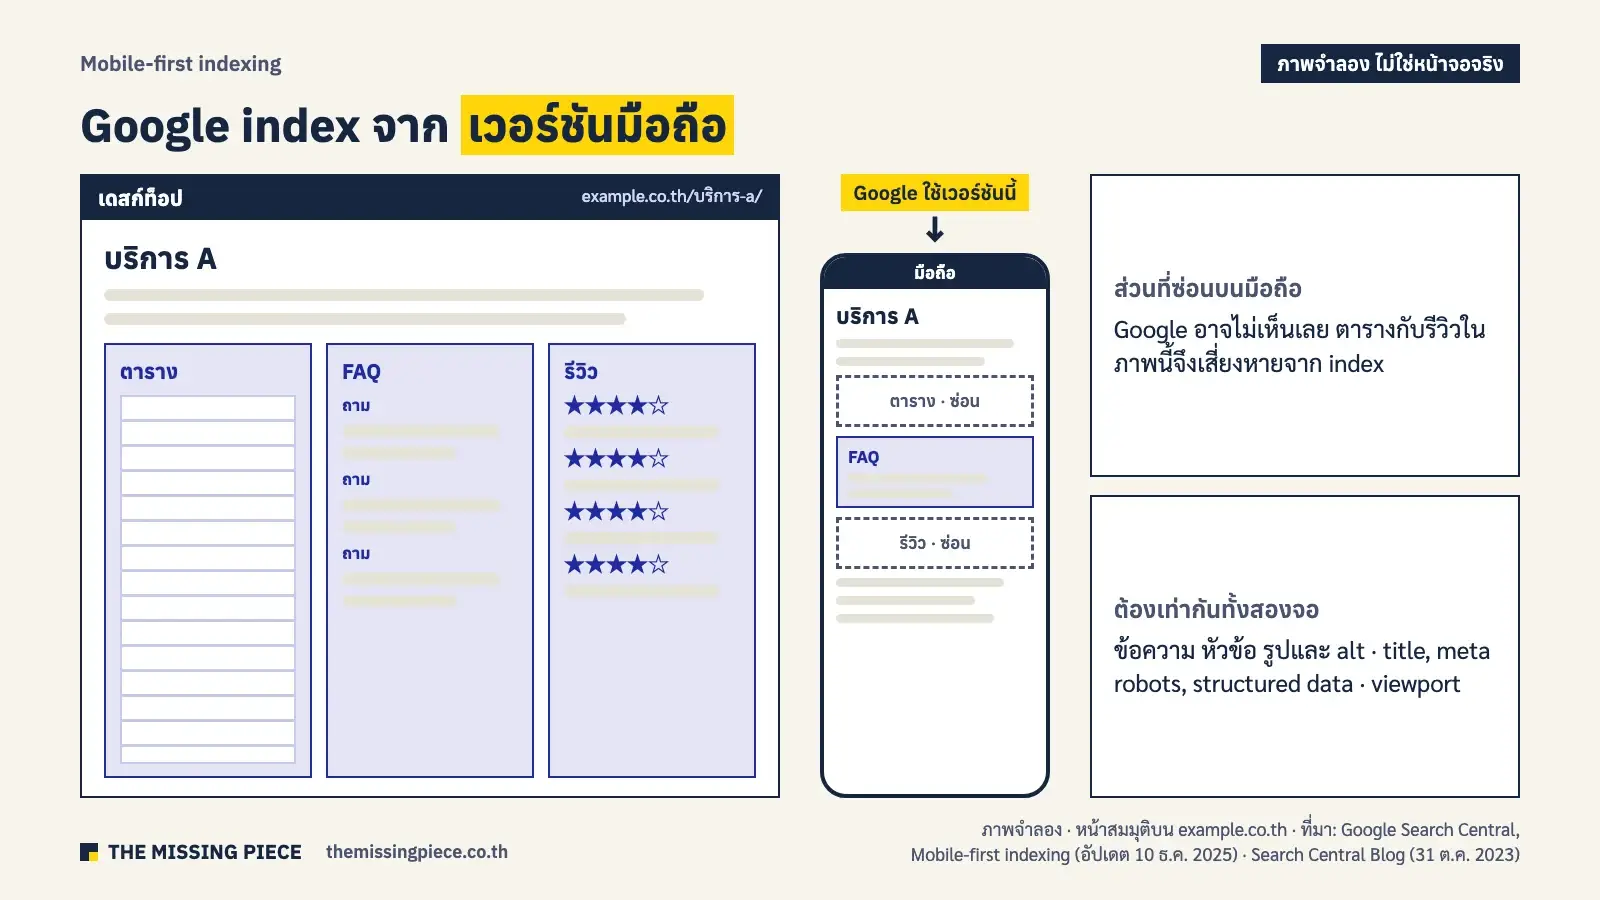
Mobile-first indexing คือการที่ Google ใช้เนื้อหาเวอร์ชันมือถือของเว็บในการ index และจัดอันดับ (เอกสาร Google อัปเดต 10 ธ.ค. 2025) และ Google ประกาศใน Search Central Blog เมื่อ 31 ต.ค. 2023 ว่าการย้ายไปใช้ mobile-first indexing เสร็จแล้ว ผลที่ตามมาคือ อะไรที่ซ่อนหรือตัดออกบนมือถือ Google อาจไม่เห็นเลย
- เนื้อหาเท่ากัน: ข้อความ หัวข้อ รูป และ alt text บนมือถือต้องเท่ากับเดสก์ท็อป ไม่ตัดส่วนท้ายบทความหรือตารางทิ้ง
- ข้อมูลเชิงโครงสร้างและ meta เท่ากัน: title, meta description, meta robots และ structured data ต้องมีในเวอร์ชันมือถือ
- มี viewport:
<meta name="viewport" content="width=device-width, initial-scale=1">ข้อมูลเว็บไทยของเรามี 96.4% ที่ใส่แล้ว ใกล้กับค่าทั่วโลกของ Web Almanac 2025 ที่ 95.2% ของหน้ามือถือ
The Art of SEO บทที่ 12 อธิบายเรื่อง mobile-first indexing ไว้ แต่เครื่องมือที่หนังสือและบทความไทยหลายชิ้นยังแนะนำ อย่าง Mobile-Friendly Test ถูก Google ปลดไปแล้ว ดูรายละเอียดในหัวข้อคำแนะนำเก่าด้านล่าง
Structured data, รูป, log file และ hreflang: ใครต้องทำแค่ไหน
Structured data, รูป, log file และ hreflang เป็นงาน technical ระดับ 3 ที่สำคัญมากกับบางเว็บ แต่ไม่ใช่จุดเริ่มของเว็บส่วนใหญ่ ให้ทำหลังระดับ 1–2 เสร็จ และเลือกตามประเภทเว็บ
- Structured data: โค้ด JSON-LD ที่บอก Google ว่าหน้านี้เป็นบทความ สินค้า หรือองค์กร ช่วยให้เข้าใจหน้าและมีสิทธิ์ได้ผลการค้นหาแบบพิเศษบางประเภท วิธีเขียนพร้อมตัวอย่างอยู่ที่ Schema Markup คืออะไร หน้าโฮมเว็บไทยในข้อมูลของเรามี JSON-LD 66.1%
- รูป: ใส่ alt ที่บรรยายสิ่งที่เห็นจริง ระบุ width และ height เพื่อไม่ให้หน้ากระตุก และไม่ lazy-load รูปแรกของหน้า รายละเอียดเรื่อง alt อยู่ที่ Alt Text คืออะไร
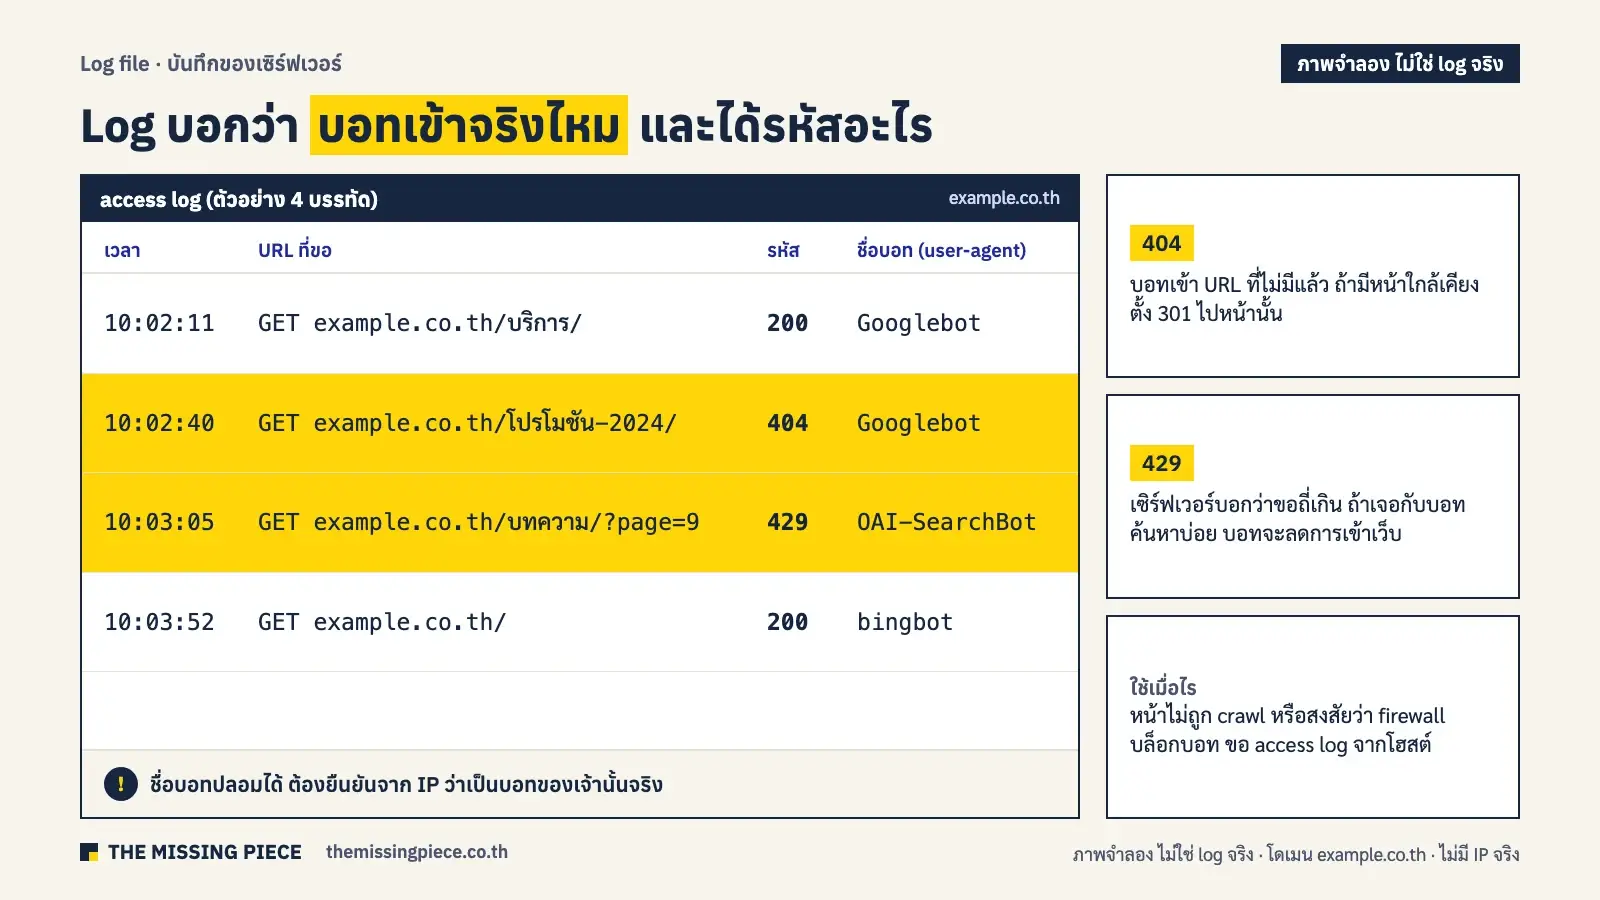
- Log file: บันทึกของเซิร์ฟเวอร์ว่าใครขอหน้าไหน เมื่อไร ได้รหัสอะไร เป็นแหล่งที่ตรงที่สุดที่บอกว่า Googlebot หรือ AI crawler เข้ามาจริงไหม The Art of SEO บทที่ 4 จัด server log เป็นหนึ่งในแหล่งข้อมูลหลักของงาน SEO เว็บเล็กยังไม่ต้องดูทุกวัน แต่ควรรู้วิธีขอ log จากโฮสต์ไว้ใช้ตอนหน้าไม่ถูก crawl หรือสงสัยว่า firewall บล็อกบอท ชื่อบอทใน log ปลอมได้ จึงต้องยืนยันจาก IP ด้วย
- Hreflang: แท็กที่บอก Google ว่าหน้านี้มีเวอร์ชันภาษาหรือประเทศอื่น ใช้เฉพาะเว็บที่มีหลายภาษา เช่น ไทยกับอังกฤษ เว็บที่มีภาษาไทยภาษาเดียวไม่ต้องใช้ The Art of SEO บทที่ 7 อธิบายกฎหลักไว้ คือทุกเวอร์ชันต้องชี้หากันครบทุกคู่
คำแนะนำ technical SEO เก่าที่ควรเลิกใช้
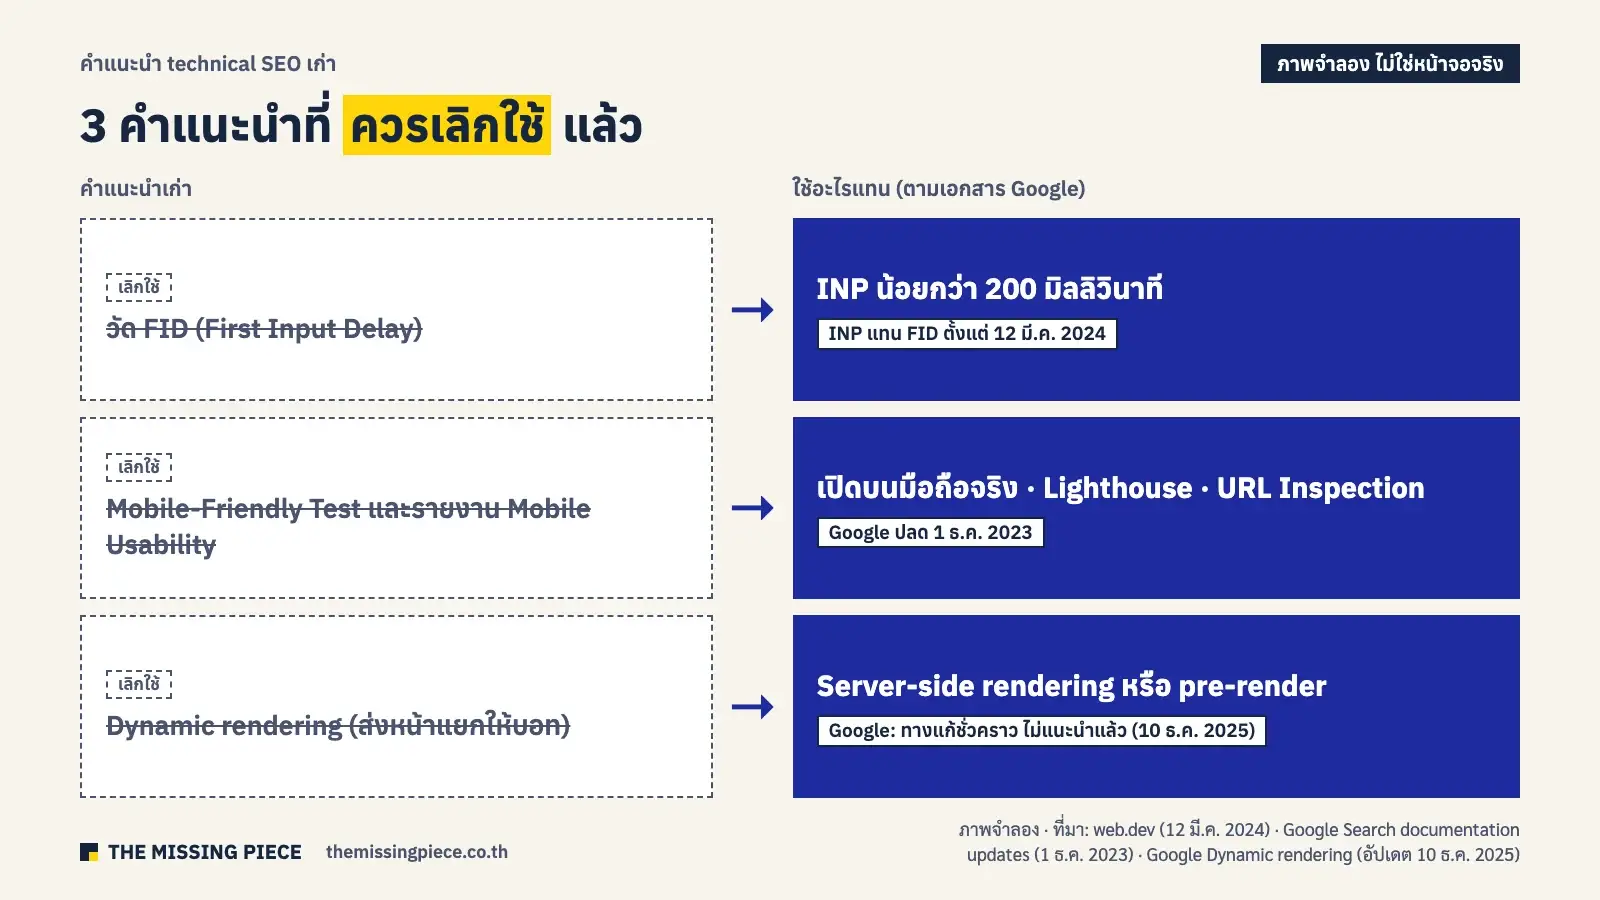
คำแนะนำ technical SEO หลายข้อที่ยังเห็นในบทความภาษาไทย หมดอายุไปแล้วตามเอกสารของ Google เอง บทความเก่าบางแห่งยังแนะนำ FID ซึ่ง Google เปลี่ยนเป็น INP แล้ว และบางแห่งยังให้ใช้ Mobile-Friendly Test หรือรายงาน Mobile Usability ที่ถูกปลดไปแล้ว ตารางนี้สรุปของที่ควรเปลี่ยน
| คำแนะนำเก่า | สถานะปัจจุบัน | ใช้อะไรแทน |
|---|---|---|
| วัด FID (First Input Delay) | INP แทนที่ FID ใน Core Web Vitals ตั้งแต่ 12 มี.ค. 2024 | INP น้อยกว่า 200 มิลลิวินาที |
| Mobile-Friendly Test และรายงาน Mobile Usability | Google ปลดและลบออกจากเอกสาร 1 ธ.ค. 2023 | เปิดบนมือถือจริง · Lighthouse · URL Inspection |
| Dynamic rendering (ส่งหน้าแยกให้บอท) | Google ระบุว่าเป็นทางแก้ชั่วคราว ไม่แนะนำแล้ว | Server-side rendering หรือ pre-render |
The Art of SEO ฉบับที่ 4 (2023) ยังเป็นหนังสือ technical SEO ที่ละเอียดที่สุดเล่มหนึ่ง แต่ 3 แถวแรกในตารางนี้เปลี่ยนหรือมีผลจริงในช่วงหรือหลังหนังสือออก เราจึงใช้หนังสือเป็นหลักคิด และเช็กเครื่องมือกับค่าเกณฑ์กับเอกสาร Google ฉบับปัจจุบันทุกครั้ง
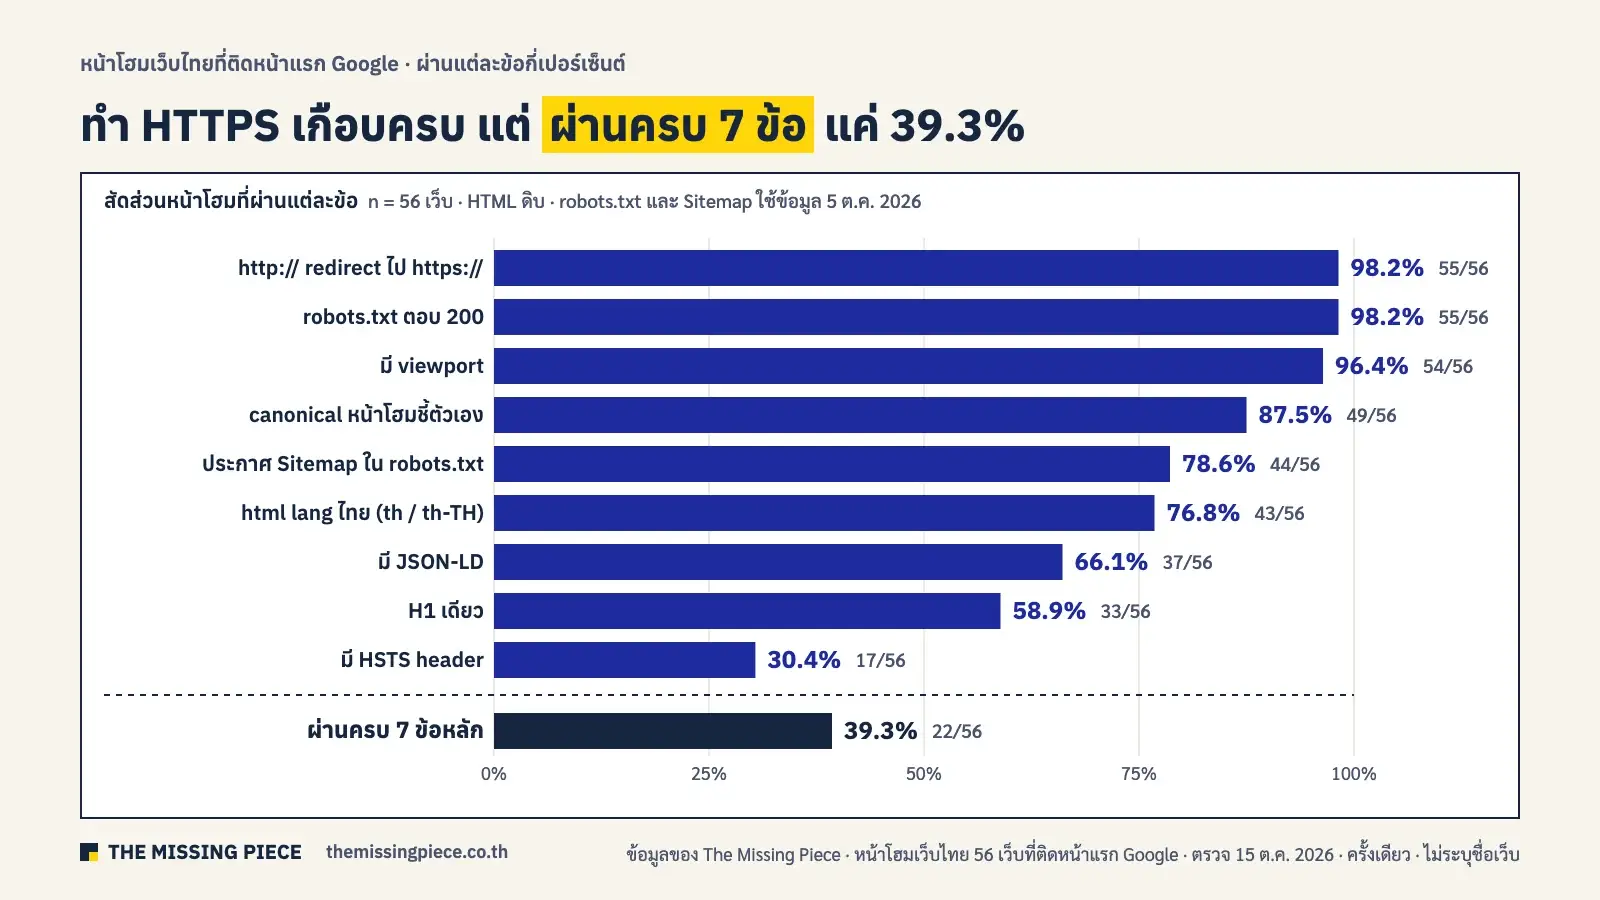
เว็บไทยหน้าแรก Google ทำ technical SEO พื้นฐานกันแค่ไหน (56 เว็บ)
เราตรวจหน้าโฮมของเว็บไทยที่ติดหน้าแรก Google 56 เว็บ ด้วย 7 ข้อพื้นฐานที่ตรวจจาก HTML ได้ (15 ต.ค. 2026) ผลคือ 39.3% (22 จาก 56 เว็บ) ผ่านครบทั้ง 7 ข้อ เรื่องใหญ่ที่บทความไทยสอนกันอย่าง HTTPS, viewport และ robots.txt ทำกันเกือบครบแล้ว จุดที่หลุดคือรายละเอียด
กลุ่มตัวอย่างมาจากการศึกษา sitemap ของเรา 62 โดเมน ที่ติดหน้าแรก Google ประเทศไทยใน 13 คำค้นธุรกิจ (เก็บ 5 ต.ค. 2026) เช่น ประกันรถยนต์ คลินิกความงาม และทัวร์ญี่ปุ่น มีทั้ง SME และแบรนด์ใหญ่ เราตัดออก 6 เว็บ (ตอบ 403 1 เว็บ ส่งหน้า bot challenge 1 เว็บ และแทบไม่มีข้อความไทยใน HTML ดิบ 4 เว็บ) เหลือ 56 เว็บ ทุกตัวเลขนับเป็นยอดรวม ไม่ระบุชื่อเว็บ
| เช็ก | ผ่าน | จำนวน |
|---|---|---|
| http:// redirect ไป https:// | 98.2% | 55/56 (301 54 เว็บ · 307 1 เว็บ · อีก 1 เว็บยังเปิด http ได้โดยไม่ redirect) |
| robots.txt ตอบ 200 (ข้อมูล 5 ต.ค.) | 98.2% | 55/56 |
| มี viewport | 96.4% | 54/56 |
| canonical หน้าโฮมชี้ตัวเอง | 87.5% | 49/56 (อีก 7 เว็บไม่มี canonical บนหน้าโฮม) |
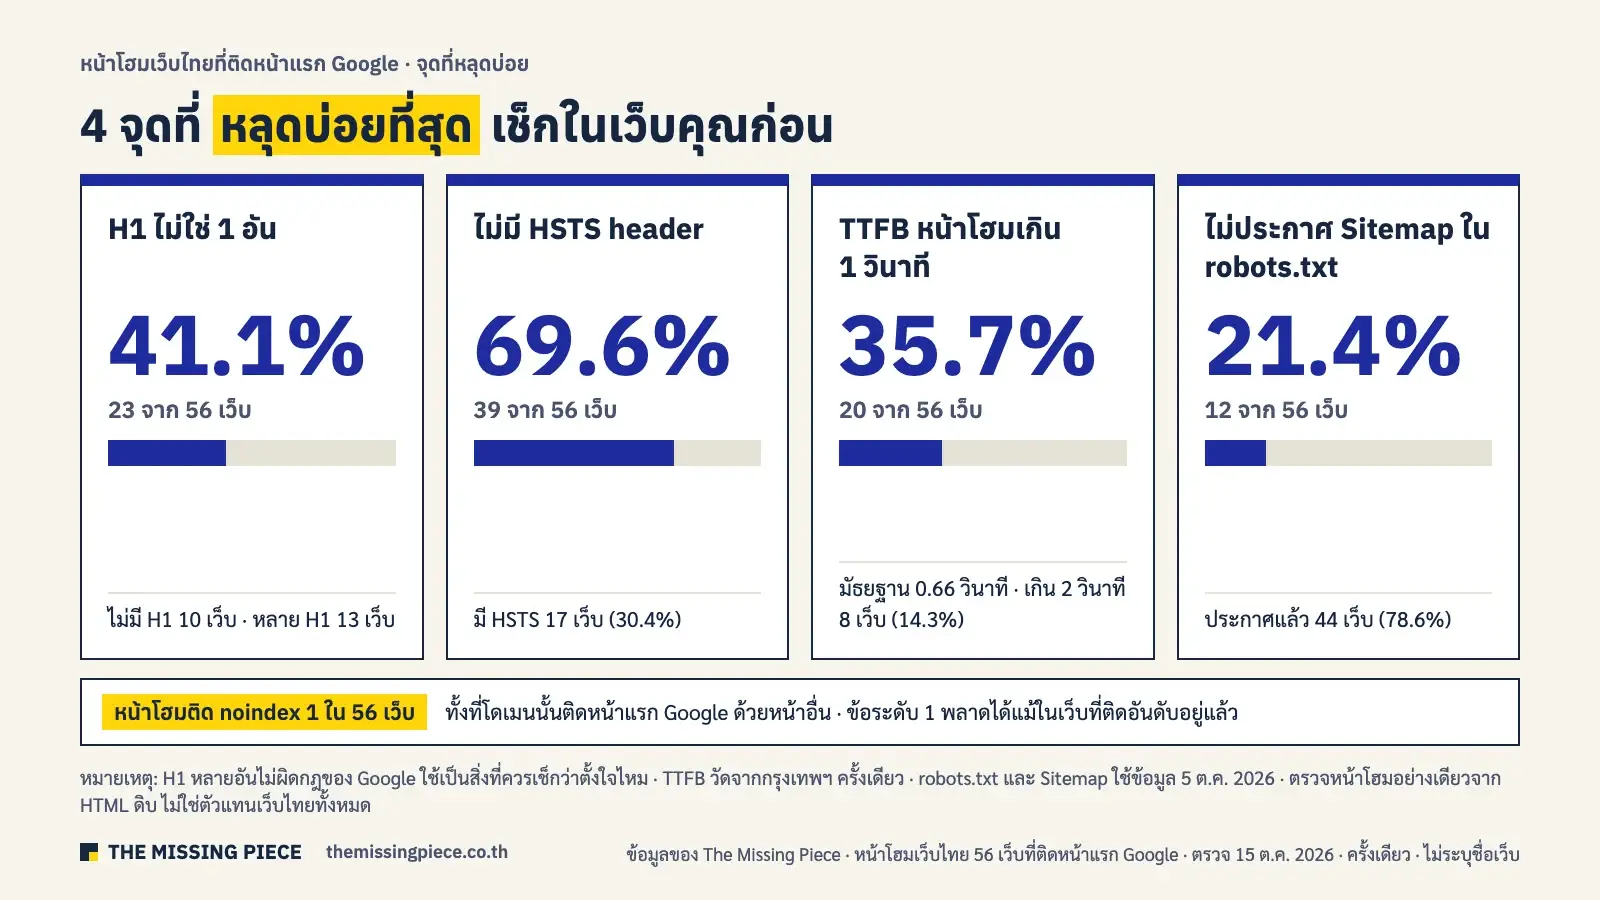
| ประกาศ Sitemap ใน robots.txt (ข้อมูล 5 ต.ค.) | 78.6% | 44/56 |
| html lang ภาษาไทย (th / th-TH) | 76.8% | 43/56 |
| มี JSON-LD | 66.1% | 37/56 |
| H1 เดียว | 58.9% | 33/56 (ไม่มี H1 10 เว็บ · หลาย H1 13 เว็บ) |
| มี HSTS header | 30.4% | 17/56 |
| หน้าโฮมไม่ติด noindex | 98.2% | 55/56 |
| TTFB หน้าโฮม | มัธยฐาน 0.66 วินาที | เกิน 1 วินาที 20 เว็บ (35.7%) · เกิน 2 วินาที 8 เว็บ (14.3%) |
| ผ่านครบ 7 ข้อหลัก | 39.3% | 22/56 |
7 ข้อหลักคือ redirect ไป HTTPS, canonical ชี้ตัวเอง, viewport, robots.txt ตอบ 200, ประกาศ Sitemap, ไม่มี noindex และ H1 เดียว ข้อที่ดึงคะแนนลงมากที่สุดคือ H1 (41.1% ไม่ใช่ 1 อัน) และ Sitemap ที่ไม่ได้ประกาศ (21.4%) ส่วนที่น่าสังเกตที่สุดคือ 1 ใน 56 เว็บมี meta robots “noindex, nofollow” บนหน้าโฮม ทั้งที่โดเมนนั้นติดหน้าแรก Google ด้วยหน้าอื่น เป็นตัวอย่างว่าข้อระดับ 1 พลาดได้แม้ในเว็บที่ติดอันดับอยู่แล้ว
เทียบทิศทางกับ Web Almanac 2025 ของ HTTP Archive (หน้ามือถือทั่วโลก) ที่พบ canonical 67%, viewport 95.2% และ HTTPS 91.5% กลุ่มเว็บไทยที่ติดหน้าแรกทำ canonical และ HTTPS ได้ดีกว่าค่าเฉลี่ยโลก ซึ่งเข้าใจได้เพราะเป็นเว็บที่ติดอันดับอยู่แล้ว สองชุดนี้เก็บคนละกลุ่มคนละวิธี จึงเทียบได้แค่ทิศทาง
ข้อจำกัดของข้อมูลชุดนี้:
- ตรวจหน้าโฮมอย่างเดียว ครั้งเดียว (15 ต.ค. 2026) จาก HTML ดิบที่ไม่รัน JavaScript
- ไม่ใช่ตัวแทนเว็บไทยทั้งหมด เป็นเว็บที่ติดหน้าแรกใน 13 คำค้น และเว็บที่บล็อกโปรแกรมตรวจถูกตัดออก
- TTFB วัดจากกรุงเทพฯ ครั้งเดียว ขึ้นกับเครือข่ายของเรา · robots.txt และ Sitemap ใช้ข้อมูลวันที่ 5 ต.ค. 2026
- H1 หลายอันไม่ได้ผิดกฎของ Google เราใช้เป็นสิ่งที่ควรเช็กว่าตั้งใจไหม ไม่ใช่ความผิด
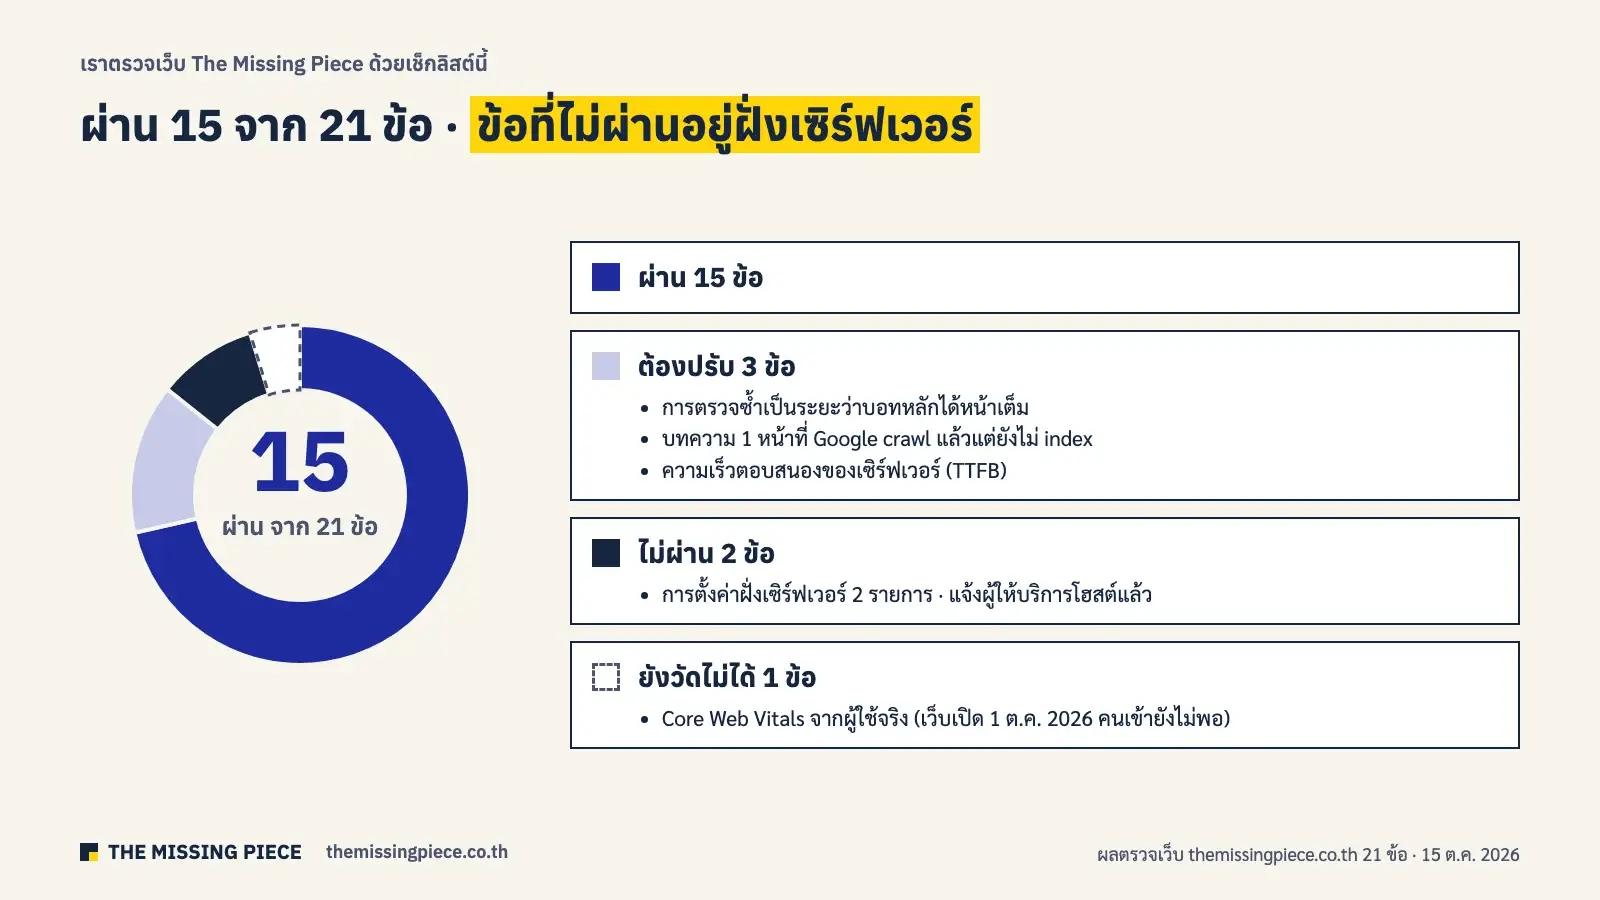
เราตรวจเว็บตัวเองด้วยเช็กลิสต์นี้: ผ่าน 15 ไม่ผ่าน 2
เราตรวจเว็บ The Missing Piece ด้วยเช็กลิสต์ 21 ข้อ (20 ข้อในบทความนี้ แยกการตรวจ Core Web Vitals เป็นข้อมูลแล็บกับข้อมูลผู้ใช้จริง) ผลคือ ผ่าน 15 ข้อ ต้องปรับ 3 ข้อ ยังไม่ผ่าน 2 ข้อ และยังวัดไม่ได้ 1 ข้อ เราตรวจระหว่าง 7–15 ต.ค. 2026 จาก request จริง การ crawl เว็บตัวเอง และ Search Console
- ผ่าน (15): robots.txt ไม่บล็อก Googlebot และประกาศ sitemap · นโยบาย AI crawler ชัดเจน · URL ใน sitemap 63/63 ตอบ 200 มี canonical ชี้ตัวเองและไม่มี noindex (14 ต.ค.) · เนื้อหาหลักอยู่ใน HTML จากเซิร์ฟเวอร์ · H1 เดียวทุกหน้า · ลิงก์ภายในไม่มีลิงก์เสีย (7 ต.ค.) · HTTPS ทั้งเว็บ · viewport และ lang=”th” · structured data ตรงประเภทหน้า · รูปส่วนใหญ่มีขนาดกำกับ · มี log ว่าบอทไหนเข้า · Core Web Vitals แบบแล็บบนมือถือ หน้าโฮม LCP 1.66 วินาที CLS 0 (14 ต.ค.)
- ต้องปรับ (3): การตรวจซ้ำเป็นระยะว่าบอทหลักได้หน้าเต็ม · บทความ 1 หน้าที่ Google crawl แล้วแต่ยังไม่ index · ความเร็วตอบสนองของเซิร์ฟเวอร์ (TTFB)
- ยังไม่ผ่าน (2): การตั้งค่าฝั่งเซิร์ฟเวอร์ 2 รายการ ซึ่งแจ้งผู้ให้บริการโฮสต์แล้ว
- ยังวัดไม่ได้ (1): Core Web Vitals จากผู้ใช้จริง เพราะเว็บเปิดเมื่อ 1 ต.ค. 2026 ยังมีคนเข้าไม่พอให้ Google มีข้อมูล
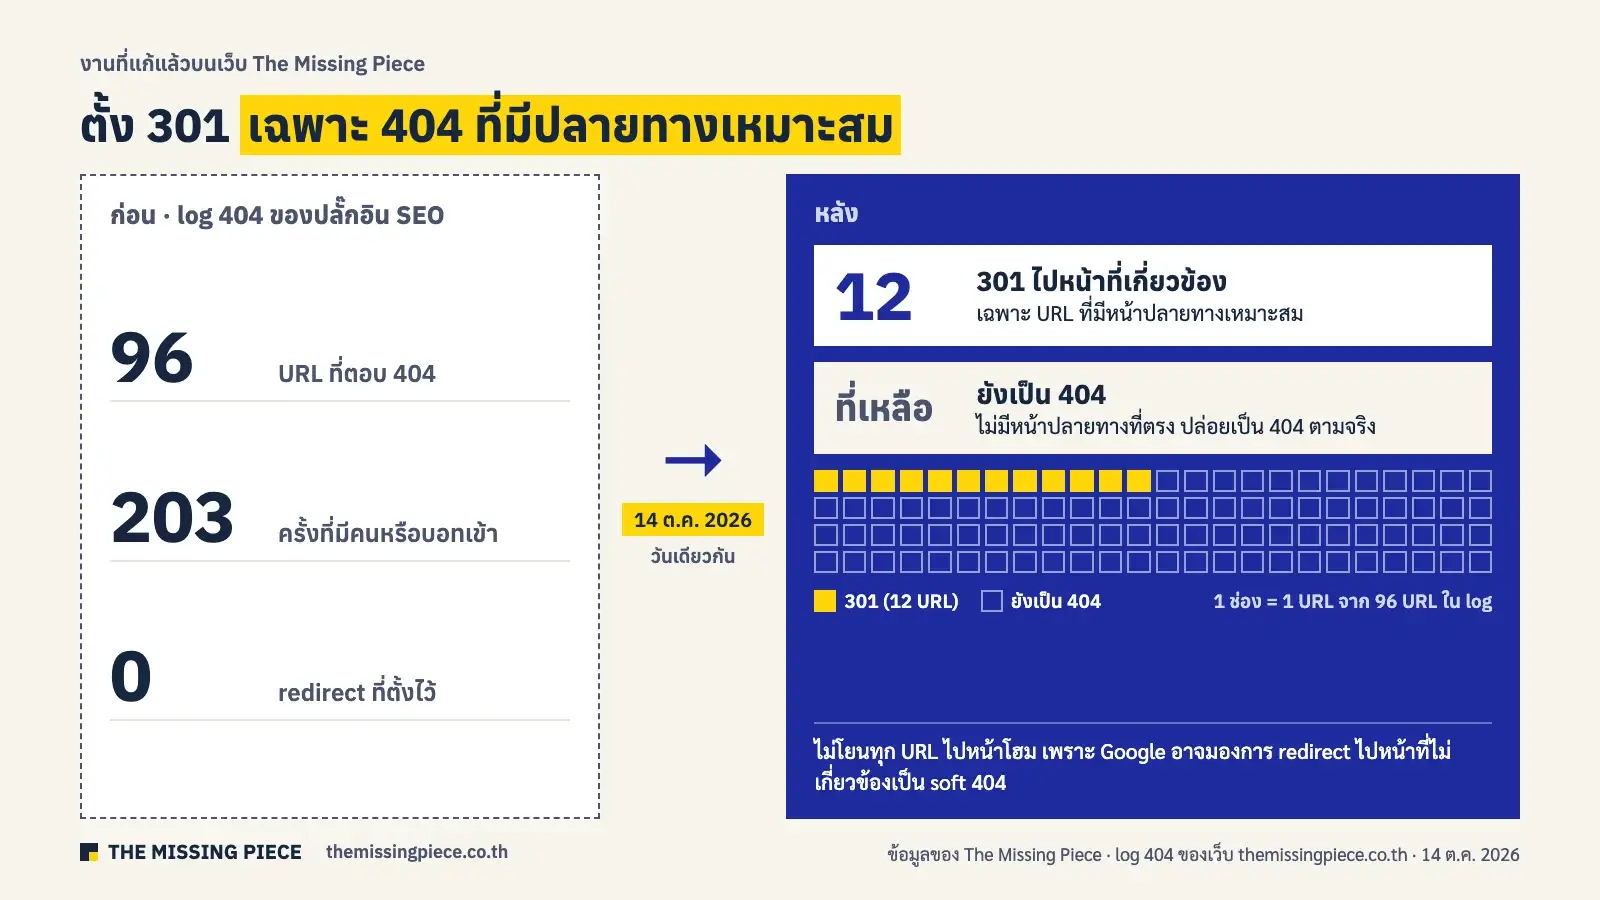
สิ่งที่แก้ไปแล้วในเดือนนี้คือ 404 ที่มีคนเข้าจริง log 404 ของปลั๊กอิน SEO บันทึก 96 URL รวม 203 ครั้ง และยังไม่มี redirect เลยสักรายการ (14 ต.ค. 2026) เราตั้ง 301 ให้ 12 URL ที่มีหน้าปลายทางเหมาะสมในวันเดียวกัน แทนการโยนทุก URL ไปหน้าโฮม เพราะ Google อาจมองการ redirect ไปหน้าที่ไม่เกี่ยวข้องเป็น soft 404
ข้อสังเกตที่ได้คือ ข้อที่ไม่ผ่านทั้งสองข้อเป็นเรื่องฝั่งเซิร์ฟเวอร์ ไม่ใช่ WordPress หรือปลั๊กอิน เจ้าของเว็บแก้เองในหลังบ้านไม่ได้ ต้องคุยกับผู้ให้บริการโฮสต์ ตรงกับข้อมูลเว็บไทยด้านบนที่เรื่องฝั่งเซิร์ฟเวอร์เป็นจุดที่หลุดบ่อย หัวข้อถัดไปจึงมีข้อความกลางสำหรับส่งถึงโฮสต์ ใช้ได้กับทุกเว็บ
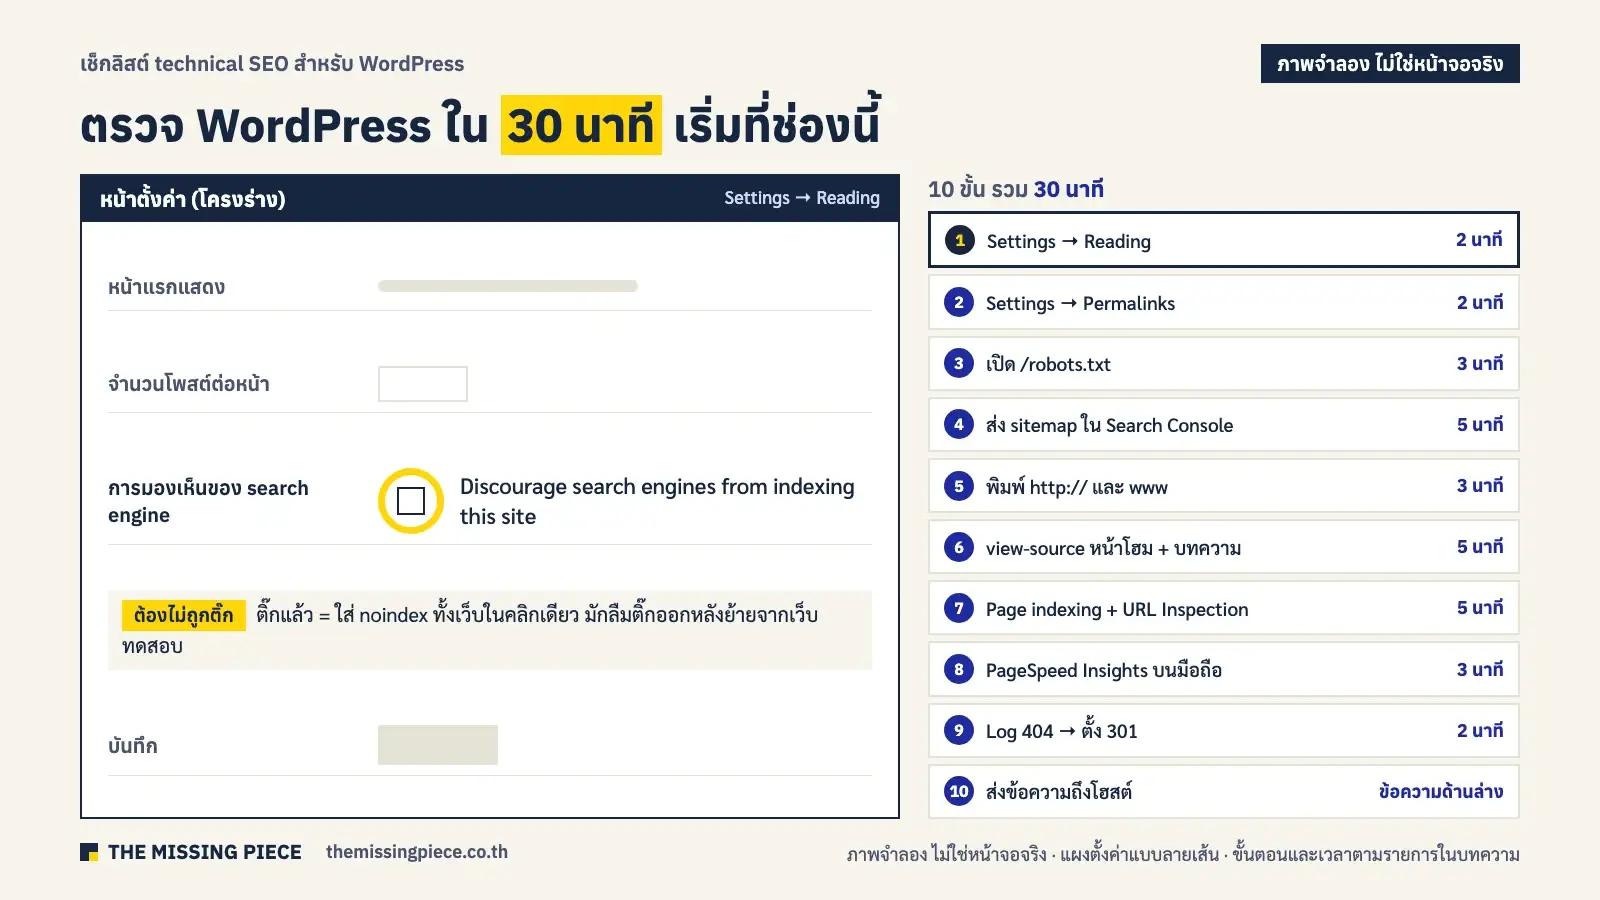
เช็กลิสต์ technical SEO สำหรับ WordPress ใน 30 นาที (SME ทำเองได้)
เช็กลิสต์นี้ใช้กับเว็บ WordPress ของธุรกิจเล็ก ใช้เครื่องมือฟรีทั้งหมด และครอบคลุมระดับ 1–2 เกือบครบ ทำตามลำดับ ถ้าเจอข้อที่ไม่ผ่าน ให้จดไว้แล้วทำข้อต่อไป อย่าหยุดแก้กลางทาง เพราะเป้าคือเห็นภาพรวมก่อน
- Settings → Reading (2 นาที): ดูว่าไม่ได้ติ๊ก “Discourage search engines from indexing this site” ช่องนี้ใส่ noindex ทั้งเว็บ และมักลืมติ๊กออกหลังย้ายจากเว็บทดสอบ
- Settings → Permalinks (2 นาที): ใช้แบบ Post name เพื่อให้ URL อ่านได้ ถ้าเว็บมีบทความแล้ว อย่าเปลี่ยนโดยไม่ตั้ง 301
- เปิด /robots.txt (3 นาที): ต้องไม่มี
Disallow: /ใต้User-agent: *และควรมีบรรทัดSitemap: - เปิด sitemap ของปลั๊กอิน SEO แล้วส่งใน Search Console (5 นาที): Rank Math หรือ Yoast สร้างให้อัตโนมัติ ส่งที่เมนู Sitemaps
- เช็ก http:// และ www/ไม่มี www (3 นาที): ใช้เว็บเช็ก redirect หรือ
curl -Iทุกแบบต้องได้ 301 ไปเวอร์ชันเดียวที่เป็น https เพราะ Chrome ลองเปิดเป็น https ให้เองก่อน การพิมพ์ใน Chrome จึงอาจดูผ่านทั้งที่ยังไม่ได้ตั้ง redirect - view-source หน้าโฮมและบทความ 1 หน้า (5 นาที): ค้น
noindex(ไม่ควรเจอ),rel="canonical"(ชี้ตัวเอง),viewportและนับ<h1 - Search Console → Page indexing (5 นาที): ดูเหตุผลที่หน้าไม่ถูก index และใช้ URL Inspection กับหน้าสำคัญ 3 หน้า
- PageSpeed Insights หน้าโฮมบนมือถือ (3 นาที): จด LCP, INP, CLS และ Time to First Byte
- Log 404 ของปลั๊กอิน SEO (2 นาที): URL ที่มีคนเข้าจริงและมีหน้าใกล้เคียง ตั้ง 301 ไปหน้านั้น
- ส่งข้อความถึงผู้ให้บริการโฮสต์: ใช้ข้อความด้านล่าง สำหรับเรื่องที่แก้ในหลังบ้าน WordPress ไม่ได้
ข้อ 1 ไม่ใช่เรื่องไกลตัว ในข้อมูล 56 เว็บด้านบน 1 เว็บติด noindex ที่หน้าโฮม ส่วนการตรวจ title และ meta description ซึ่งเป็นงาน on-page ให้ทำต่อตาม เช็กลิสต์ On-Page SEO
ข้อความภาษาไทยสำหรับส่งถึงผู้ให้บริการโฮสต์
คัดลอกข้อความนี้ แก้ชื่อโดเมน แล้วส่งผ่านระบบ ticket หรืออีเมลซัพพอร์ตของโฮสต์ได้เลย ข้อ 2 ให้โฮสต์เริ่มจากค่าเวลาสั้นก่อน เพราะ HSTS ตั้งแล้วย้อนกลับยาก ถ้า HTTPS มีปัญหาภายหลัง เบราว์เซอร์ของคนอ่านจะเปิดเว็บไม่ได้
เรื่อง: ขอตรวจการตั้งค่าเซิร์ฟเวอร์ของโดเมน example.co.th

สวัสดีครับ รบกวนช่วยตรวจและแจ้งผล 5 เรื่องนี้ครับ
1) HTTPS เปิดทั้งเว็บ และ http:// redirect ไป https:// แบบ 301 แล้วหรือยัง
2) ช่วยเพิ่ม header Strict-Transport-Security (HSTS) ให้ได้ไหม ขอเริ่มจากค่า max-age สั้นก่อน
3) ไฟล์ static (CSS, JavaScript, รูป) ตั้ง Cache-Control หรือ Expires แล้วหรือยัง ถ้ายัง ขอเปิดให้ด้วย
4) ช่วยยืนยันว่าระบบ firewall หรือระบบป้องกัน bot ของเซิร์ฟเวอร์ ไม่บล็อกและไม่ส่งหน้ายืนยัน (challenge)
   ให้ Googlebot, Bingbot หรือ bot ของ AI search เช่น OAI-SearchBot ที่ยืนยันตัวตนได้
5) ขอ access log ย้อนหลัง 7 วัน เพื่อดูว่า bot ไหนเข้าเว็บและได้รหัสอะไร

ขอบคุณครับ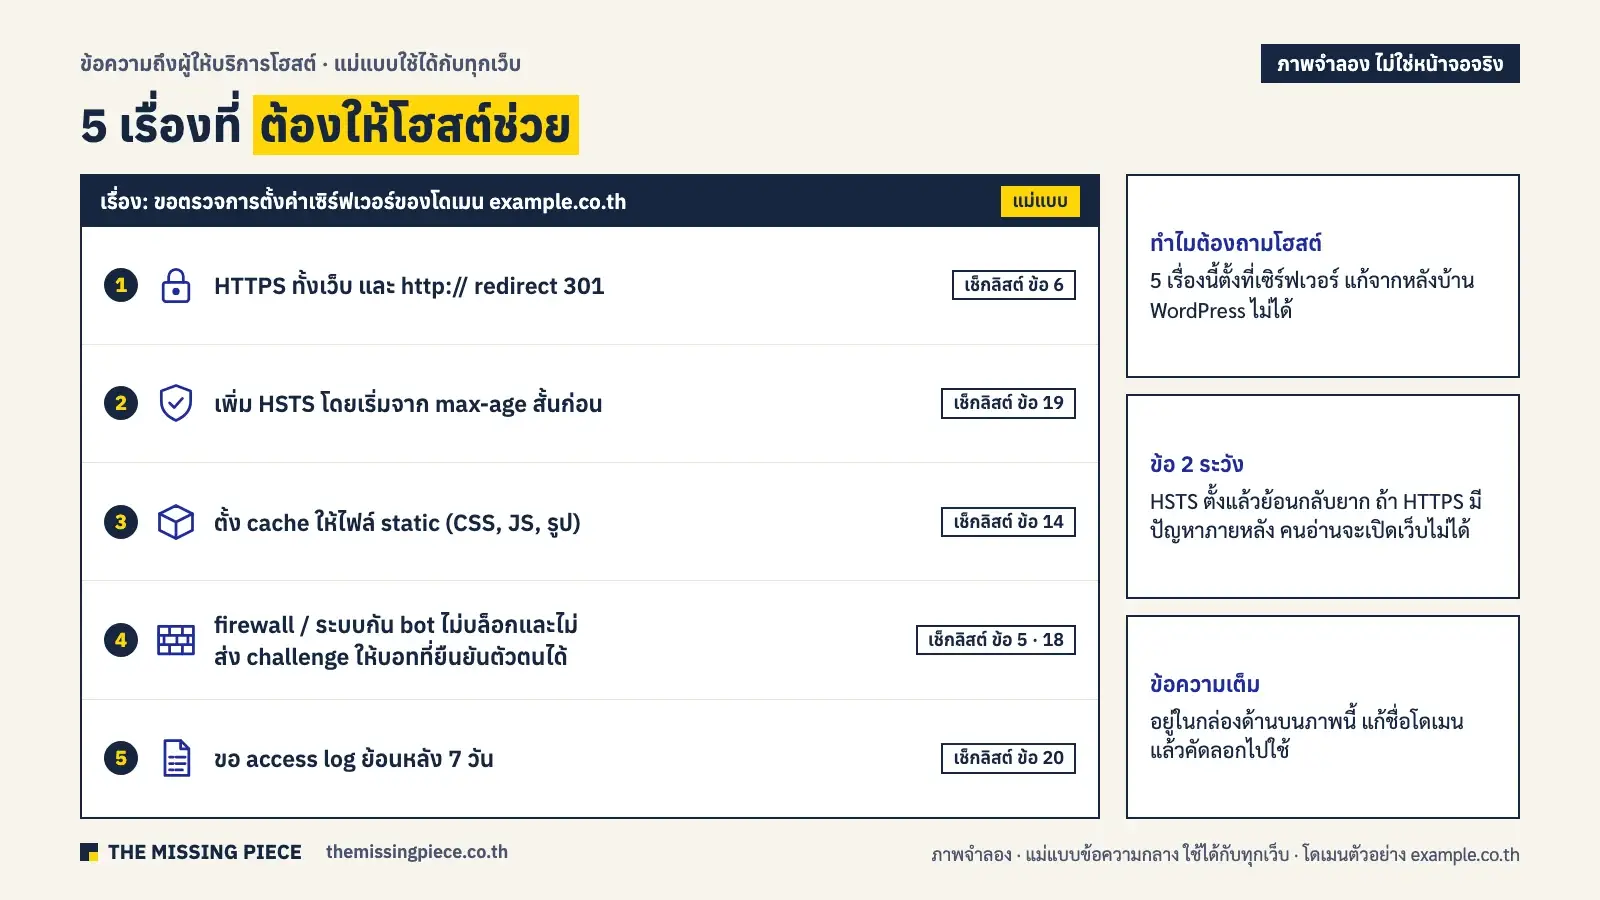
ตรวจ technical SEO เอง (technical SEO audit) บ่อยแค่ไหน ใช้เครื่องมืออะไร
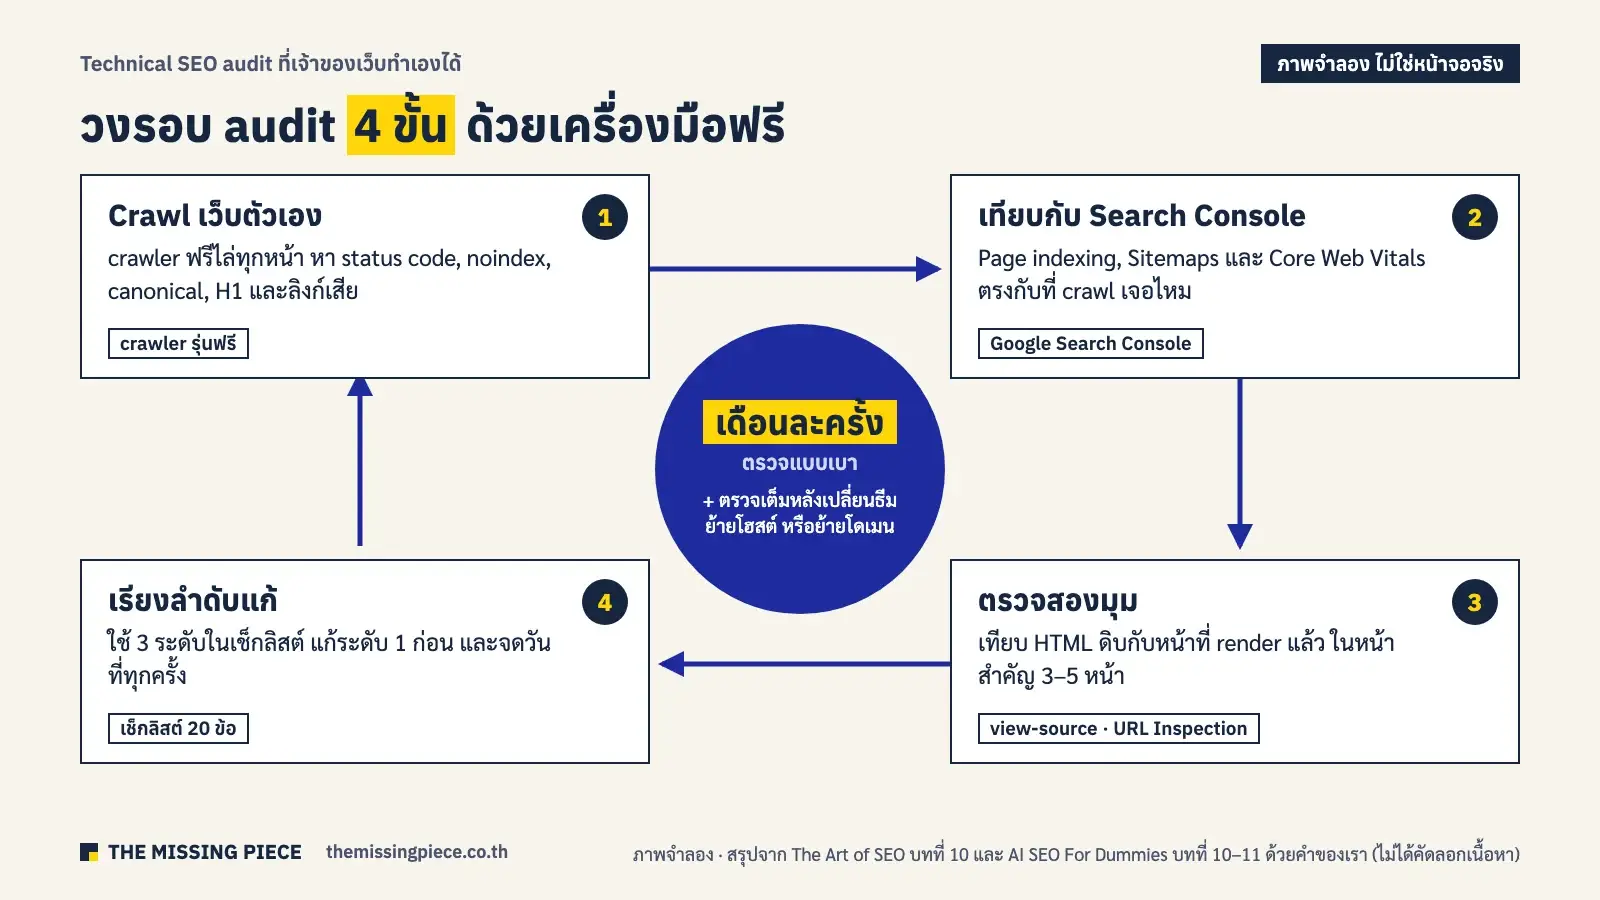
Technical SEO audit คือการตรวจเว็บทั้งเว็บตามเช็กลิสต์ เพื่อหาว่าหน้าไหนติดขั้น crawl, render หรือ index เจ้าของเว็บเล็กทำเองได้ด้วยเครื่องมือฟรี ตรวจแบบเบาเดือนละครั้ง และตรวจเต็มทุกครั้งที่เว็บเปลี่ยนใหญ่ เช่น เปลี่ยนธีม ย้ายโฮสต์ ย้ายโดเมน หรืออัปเดตปลั๊กอินที่แตะ URL (ขั้นตอนตรวจทั้งเว็บอยู่ใน SEO Audit คืออะไร)
- Crawl เว็บตัวเอง: ใช้ crawler ฟรีไล่ทุกหน้า หา status code, noindex, canonical, H1 และลิงก์เสีย
- เทียบกับ Search Console: ดู Page indexing, Sitemaps และ Core Web Vitals ว่าตรงกับที่ crawl เจอไหม
- ตรวจสองมุม: เทียบ HTML ดิบกับหน้าที่ render แล้วในหน้าสำคัญ 3–5 หน้า
- เรียงลำดับ: ใช้ 3 ระดับในเช็กลิสต์ แก้ระดับ 1 ก่อน และจดวันที่ทุกครั้งที่แก้
ขั้นตอนนี้ย่อมาจาก The Art of SEO บทที่ 10 ที่เริ่ม audit ด้วยการ crawl แล้วต่อด้วย Search Console, analytics และการตรวจด้วยคน และเตือนให้ตรวจซ้ำทุกครั้งหลัง deploy เพราะการเปลี่ยนเว็บครั้งเดียวทำ noindex หลุดได้ทั้งเว็บ เครื่องมือฟรีที่ใช้ได้มี Google Search Console, PageSpeed Insights, Rich Results Test และ crawler รุ่นฟรี รายชื่อและวิธีเลือกอยู่ที่ SEO Tools ฟรีและเสียเงิน 2026
Technical SEO เป็นงานที่เห็นผลก็ต่อเมื่อเนื้อหาตรงกับสิ่งที่คนค้น ถ้าหน้าผ่านเช็กลิสต์ครบแล้วแต่ยังไม่ขึ้น ให้กลับไปดูว่าเลือกคำค้นที่สู้ได้ไหมด้วย Keyword Difficulty และเนื้อหาตรงเจตนาไหมด้วย Search Intent
ถ้าอยากปูพื้นงานค้นหาทั้งระบบทีละขั้นก่อน เริ่มที่ เรียน SEO ฟรีทีละขั้น
Technical SEO เป็นฐานของงาน SEO ทั้งหมด ส่วนภาพรวมของทุกขาอยู่ที่ SEO คืออะไร บทความนี้เขียนโดยทีม The Missing Piece นำโดย ไอซ์ ศิริพงษ์ จากเอกสารทางการของ Google ผลตรวจเว็บเราเอง และข้อมูลหน้าโฮมเว็บไทย 56 เว็บที่เราเก็บเอง
อยากให้การตรวจ technical SEO และการวัดผลทำงานต่อเองทุกสัปดาห์ ทั้งบน Google และในคำตอบ AI: คอร์สเรียน SEO & AI Search แบบ Agentic สอนสด 2 วันด้วย Claude Code (จ. 21 – อ. 22 ธ.ค. 2026) สร้าง agent ที่วัดว่า ChatGPT กับ Gemini พูดถึงแบรนด์คุณไหม แล้วทำงานกับเว็บของคุณต่อทุกสัปดาห์
คำถามที่พบบ่อย
Technical SEO คืออะไร
Technical SEO คืองานด้านระบบของเว็บไซต์ที่ทำให้ Googlebot และ AI crawler เข้าถึงหน้า อ่านเนื้อหา และ index หน้าได้ถูกต้อง ขั้นต่ำที่ Google กำหนดมี 3 ข้อ คือไม่บล็อก Googlebot หน้าตอบ HTTP 200 และมีเนื้อหาที่ index ได้
Technical SEO ต่างจาก On-Page SEO ยังไง
Technical SEO ทำให้บอทเข้าถึงและอ่านหน้าได้ เช่น robots.txt, status code และ HTTPS ส่วน On-Page SEO ทำให้เนื้อหาบนหน้าตอบคำถามและสื่อความหมายชัด เช่น title และหัวข้อ ต้องผ่าน technical ก่อน งาน on-page จึงมีผล
ทำ technical SEO เองได้ไหม ต้องเขียนโค้ดเป็นไหม
เว็บ WordPress ขนาดเล็กทำระดับพื้นฐานเองได้โดยไม่ต้องเขียนโค้ด ใช้หลังบ้าน ปลั๊กอิน SEO และ Search Console ส่วนการตั้งค่าฝั่งเซิร์ฟเวอร์ต้องให้ผู้ให้บริการโฮสต์ช่วย
ความเร็วและประสบการณ์หน้าเว็บช่วยให้ติดอันดับไหม
ช่วยได้บางส่วน Google ระบุว่าระบบจัดอันดับใช้ Core Web Vitals แต่ไม่มีสัญญาณ page experience ตัวเดียว และคะแนนดีไม่รับประกันอันดับบนสุด (อัปเดต 22 ก.ย. 2026) เกณฑ์ดีคือ LCP ภายใน 2.5 วินาที INP น้อยกว่า 200 มิลลิวินาที และ CLS น้อยกว่า 0.1
ควรเปิดให้ AI crawler เข้าเว็บไหม
ถ้าอยากถูกพบและถูกอ้างใน AI search ควรเปิดบอทที่ใช้ค้นหา เช่น OAI-SearchBot เพราะแต่ละบอทตั้งค่าแยกกันได้ และ Google-Extended ไม่มีผลต่อผลค้นหา Google รายละเอียดการตั้งค่าแต่ละบอทอยู่ในบทความ robots.txt สำหรับ AI bots
ควรตรวจ technical SEO บ่อยแค่ไหน
ตรวจแบบเบาเดือนละครั้งผ่าน Search Console และตรวจเต็มทุกครั้งที่เปลี่ยนธีม ย้ายโฮสต์ ย้ายโดเมน หรืออัปเดตที่แตะ URL เพราะการเปลี่ยนครั้งเดียวอาจทำให้ noindex หรือ redirect ผิดหลุดไปทั้งเว็บ
บทเรียนนี้เป็นส่วนหนึ่งของ สอน SEO ฟรี 7 โมดูล ของ The Missing Piece เรียนต่อโมดูลถัดไปได้ที่นั่น
แหล่งอ้างอิง
- Google Search Central, In-depth guide to how Google Search works (อัปเดต 18 ธ.ค. 2025: 3 ขั้น crawl, index, serve · ไม่รับประกันการ crawl, index หรือแสดงผล) (ตรวจ 15 ต.ค. 2026)
- Google Search Central, Google Search technical requirements (อัปเดต 18 ธ.ค. 2025: ไม่บล็อก Googlebot · HTTP 200 · มีเนื้อหาที่ index ได้)
- Google Search Central, How HTTP status codes, and network and DNS errors affect Google Search (อัปเดต 4 ก.พ. 2026: 2xx ไม่รับประกันการ index · 5xx และ 429 ทำให้ลดการ crawl · ตาม redirect ราว 10 ทอด · soft 404)
- Google Search Console Help, 404 (Page Not Found) errors (ตรวจ 15 ต.ค. 2026: การ redirect ไปหน้าอื่น เช่น หน้าโฮม แทน 404 อาจถูกมองเป็น soft 404)
- Google Search Central, Introduction to robots.txt (อัปเดต 10 ธ.ค. 2025) และ Block Search indexing with noindex (อัปเดต 10 ธ.ค. 2025)
- Google Search Central, How to specify a canonical URL (อัปเดต 10 ก.ค. 2026) และ Redirects and Google Search (อัปเดต 14 เม.ย. 2026)
- Google Search Central, Learn about sitemaps (อัปเดต 10 ธ.ค. 2025) และ Crawl budget management for large sites (อัปเดต 22 ก.ค. 2026)
- Google Search Central, Understand the JavaScript SEO basics (อัปเดต 4 มี.ค. 2026) และ Dynamic rendering as a workaround (อัปเดต 10 ธ.ค. 2025: ไม่แนะนำแล้ว)
- Google Search Central, Understanding page experience in Google Search results (อัปเดต 22 ก.ย. 2026: ไม่มีสัญญาณเดียว · ระบบจัดอันดับใช้ Core Web Vitals · คำถามตรวจตัวเองเรื่อง HTTPS) และ Core Web Vitals (อัปเดต 10 ธ.ค. 2025: LCP 2.5 วินาที · INP 200 มิลลิวินาที · CLS 0.1)
- Search Console Help, Security issues report (ไม่ระบุวันที่ ตรวจ 16 ต.ค. 2026: เว็บถูกแฮก หน้าหลอกลวง ดาวน์โหลดอันตราย · เชื่อมกับ Google Safe Browsing · แก้ทั้งเว็บแล้ว Request Review · ใช้เวลาหลายวันถึงหลายสัปดาห์) · Google Chrome Help, Check if a site’s connection is secure (ไม่ระบุวันที่ ตรวจ 16 ต.ค. 2026: Not secure · Dangerous คือเว็บที่ Safe Browsing ติดธง · “Your connection is not private” อาจเกิดจากเว็บ เครือข่าย หรืออุปกรณ์)
- web.dev, What is mixed content? (อัปเดต 7 ก.ย. 2019: หน้า HTTPS ที่เรียกไฟล์ผ่าน HTTP · เบราว์เซอร์บล็อกสคริปต์ · ดูได้ใน DevTools) และ Enable HTTPS on your servers (อัปเดต 27 มี.ค. 2015: ทุก hostname ต้องใช้ใบรับรองที่ถูกต้อง · ใช้ 301 ชี้ไปเวอร์ชัน HTTPS) (ตรวจ 16 ต.ค. 2026)
- Google Blog (Chrome Security Team), HTTPS by default (28 ต.ค. 2025: ประกาศว่า Chrome 154 ต.ค. 2026 จะเปิด Always Use Secure Connections เป็นค่าเริ่มต้น และถามก่อนเปิดเว็บสาธารณะที่ไม่มี HTTPS ครั้งแรก) · Chromium Blog, Towards HTTPS by default (16 ส.ค. 2023: Chrome เปลี่ยน http:// เป็น https:// ให้อัตโนมัติ และกลับไปใช้ http เมื่อเปิด https ไม่ได้) (ตรวจ 16 ต.ค. 2026)
- Google Search Central, Mobile-first indexing best practices (อัปเดต 10 ธ.ค. 2025) · Search Central Blog: Mobile-first indexing has landed (31 ต.ค. 2023)
- Google Search Central, Latest Google Search documentation updates (บันทึก 1 ธ.ค. 2023: ลบ Mobile-Friendly Test และรายงาน Mobile Usability ออกจากเอกสาร) · web.dev, Interaction to Next Paint becomes a Core Web Vital (12 มี.ค. 2024)
- Google Search Central, Google’s common crawlers (อัปเดต 15 ต.ค. 2026: Google-Extended เป็น token ใน robots.txt ไม่มี user agent แยก และไม่มีผลต่อการแสดงใน Google Search) · OpenAI, Overview of OpenAI Crawlers (ไม่ระบุวันที่ ตรวจ 16 ต.ค. 2026: OAI-SearchBot ใช้สำหรับการค้นหา · ตั้งค่าแต่ละบอทแยกกัน · เผยแพร่ช่วง IP เป็น JSON · ไม่ระบุเรื่อง JavaScript)
- Anthropic Help Center, Does Anthropic crawl data from the web (7 เม.ย. 2026: ClaudeBot, Claude-SearchBot, Claude-User · ไม่ระบุเรื่อง JavaScript) · Perplexity, Perplexity Crawlers (ไม่ระบุวันที่ ตรวจ 16 ต.ค. 2026: PerplexityBot, Perplexity-User · ไม่ระบุเรื่อง JavaScript)
- Apple Support, About Applebot (4 ก.ย. 2026: อาจ render หน้าในเบราว์เซอร์ · Applebot-Extended ไม่ crawl) · Bing Webmaster Blog, The new evergreen Bingbot (9 ต.ค. 2019: ใช้เอนจิน Microsoft Edge รัน JavaScript)
- Search Console Help, URL Inspection tool (ตรวจ 16 ต.ค. 2026: View crawled page · Test live URL · View tested page · ใช้ Google-InspectionTool)
- HTTP Archive, Web Almanac 2025, SEO chapter (เผยแพร่ 15 ม.ค. 2026 ปรับปรุง 9 มิ.ย. 2026: canonical, viewport, HTTPS และสัดส่วนเว็บที่ระบุ GPTBot ใน robots.txt)
- Vercel × MERJ, The rise of the AI crawler (17 ธ.ค. 2024 · ข้อมูลจากเครือข่ายของ Vercel หลายเดือน ปริมาณนับ 1 เดือน · งานของผู้ให้บริการ: GPTBot, OAI-SearchBot, ChatGPT-User, ClaudeBot, PerplexityBot, Meta-ExternalAgent, Bytespider และ CCBot ไม่ render · Gemini ผ่านระบบ Googlebot และ AppleBot render · ตรวจ 16 ต.ค. 2026)
- ข้อมูลของ The Missing Piece: ตรวจหน้าโฮมเว็บไทยที่ติดหน้าแรก Google 56 เว็บ (จาก 62 โดเมนในการศึกษา sitemap ของเรา 13 คำค้นธุรกิจ เก็บ 5 ต.ค. 2026) ด้วย HTML ดิบ 15 ต.ค. 2026 ครั้งเดียว ไม่ระบุชื่อเว็บ · ตรวจเว็บ themissingpiece.co.th 21 ข้อ 7–15 ต.ค. 2026 · สังเกตคำตอบ Google AI Overview และ OpenAI ผ่าน API (ChatGPT) (15 ต.ค. 2026 ครั้งเดียวต่อแพลตฟอร์ม n=1 ไม่ใช่อัตรา)
- Nathan Gotch, AI SEO For Dummies (Wiley, 2026), บทที่ 2 (ขั้น crawl ถึง rank · ไม่ใช่ทุกบอทเคารพ robots.txt · เนื้อหาสำคัญควรอยู่ใน HTML จากเซิร์ฟเวอร์) · บทที่ 10 (ตรวจเว็บสองมุม HTML ดิบกับหน้าที่ render) · บทที่ 11 (แก้ปัญหาใหญ่ 3 อันดับแรกก่อน) · บทที่ 22 (การบล็อก AI crawler ไม่ใช่ทางเลือกที่ฉลาดเสมอ)
- Eric Enge, Stephan Spencer, Jessie Stricchiola, The Art of SEO, 4th ed. (O’Reilly, 2023), บทที่ 3 (เส้นทางจากคำค้นถึง index) · บทที่ 4 (server log เป็นแหล่งข้อมูล) · บทที่ 7 (เนื้อหาที่ crawl ได้ · robots.txt, meta robots, canonical, redirect · JavaScript และ SSR · hreflang · page experience · crawl budget) · บทที่ 10 (ขั้นตอน audit และการตรวจหลัง deploy) · บทที่ 12 (mobile-first indexing) · หมายเหตุ: FID, Mobile-Friendly Test และ dynamic rendering ในเล่มล้าสมัยแล้ว
ตรวจข้อมูลล่าสุด: 15 ต.ค. 2026 (ส่วน JavaScript กับบอท AI และเช็ก 4 อย่างเมื่อ Chrome ขึ้น “ไม่ปลอดภัย”: 16 ต.ค. 2026) · เราจะอัปเดตผลตรวจเว็บเราเองเมื่อข้อที่ไม่ผ่านได้รับการแก้ และเพิ่มข้อมูลเว็บไทยเมื่อเก็บรอบใหม่