สรุปสั้น (TL;DR)
LLM ย่อมาจาก Large Language Model หรือโมเดลภาษาขนาดใหญ่ คือ AI ที่ฝึกจากข้อความจำนวนมหาศาลจนเดาคำถัดไปได้แม่นพอจะตอบคำถาม เขียน สรุป และแปลได้ ChatGPT, Gemini และ Claude ล้วนทำงานบน LLM สำหรับนักการตลาด สิ่งที่ต้องรู้คือ LLM รู้เรื่องแบรนด์ของคุณได้ 2 ทาง คือจากความจำตอนฝึก และจากการค้นเว็บสดตอนตอบ
- ความจำของ LLM หยุดอยู่ที่วันตัดข้อมูล (knowledge cutoff) ข้อมูลใหม่กว่านั้นต้องมาจากการค้นเว็บ ซึ่งเป็นส่วนที่เว็บของคุณมีผลโดยตรง
- ผลทดสอบของเรา (ต.ค. 2026, ข้อความ 5 คู่): ข้อความภาษาไทยใช้ token มากกว่าภาษาอังกฤษที่มีความหมายเดียวกัน 1.39 เท่าบน tokenizer o200k ของ OpenAI (ใช้ตั้งแต่ GPT-4o) และ 3.3 เท่าบนรุ่นเก่า
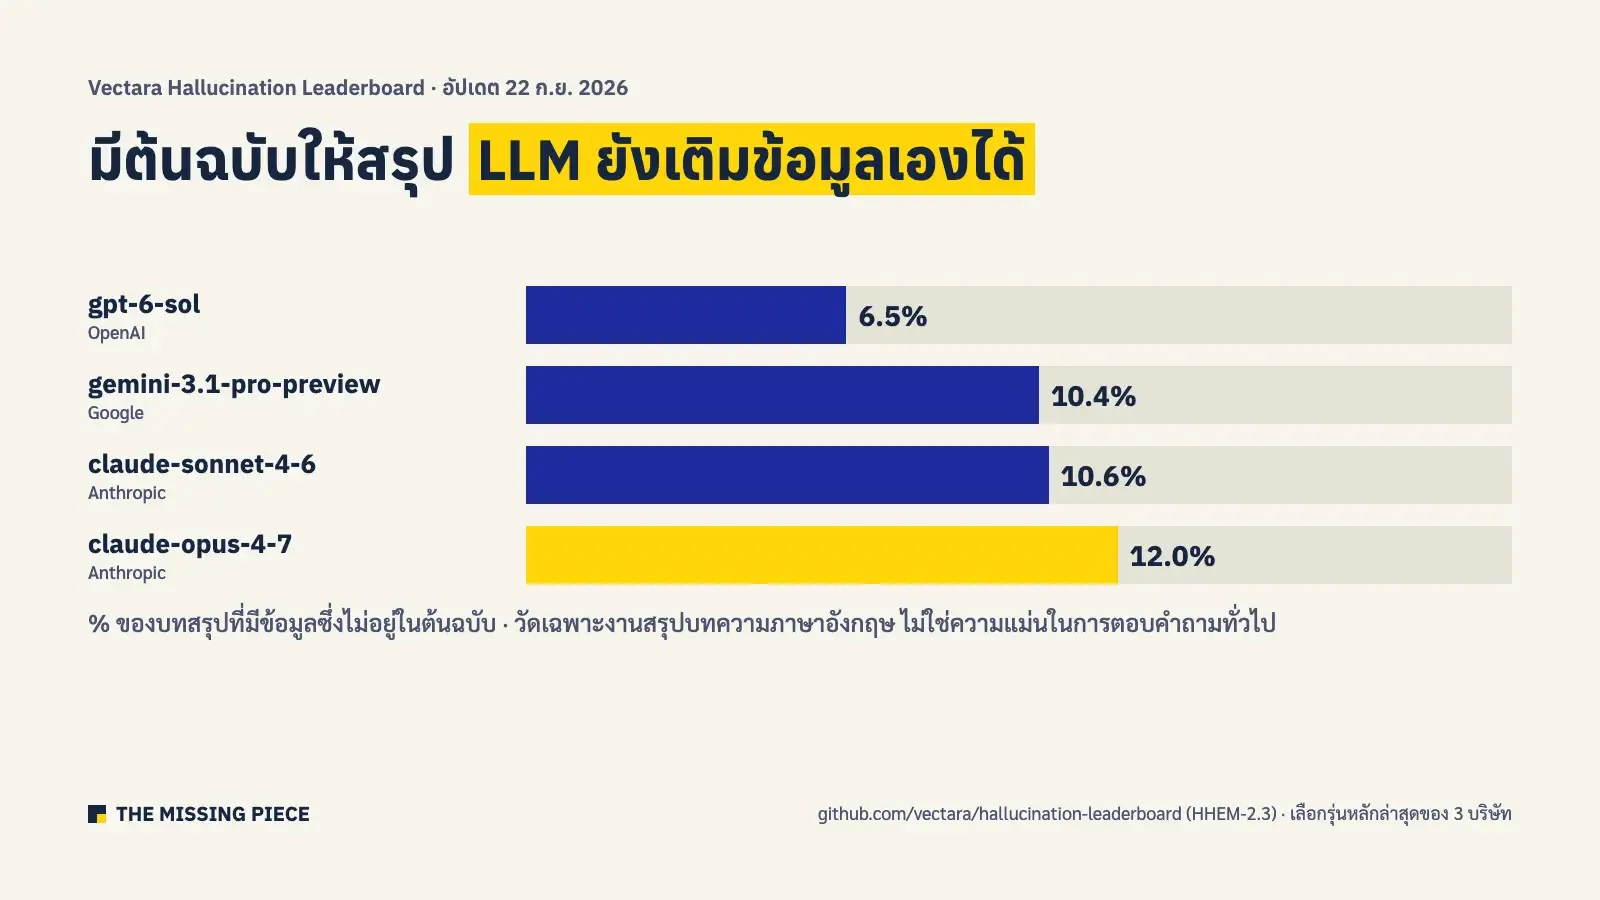
- LLM ตอบผิดได้อย่างมั่นใจ แม้แต่งานสรุปบทความที่มีต้นฉบับให้ รุ่นหลักล่าสุดของ OpenAI, Google และ Anthropic ยังใส่ข้อมูลที่ไม่มีในต้นฉบับราว 6–12% (Vectara, ก.ย. 2026) จึงต้องตรวจตัวเลขทุกครั้ง
สารบัญ
LLM คืออะไร
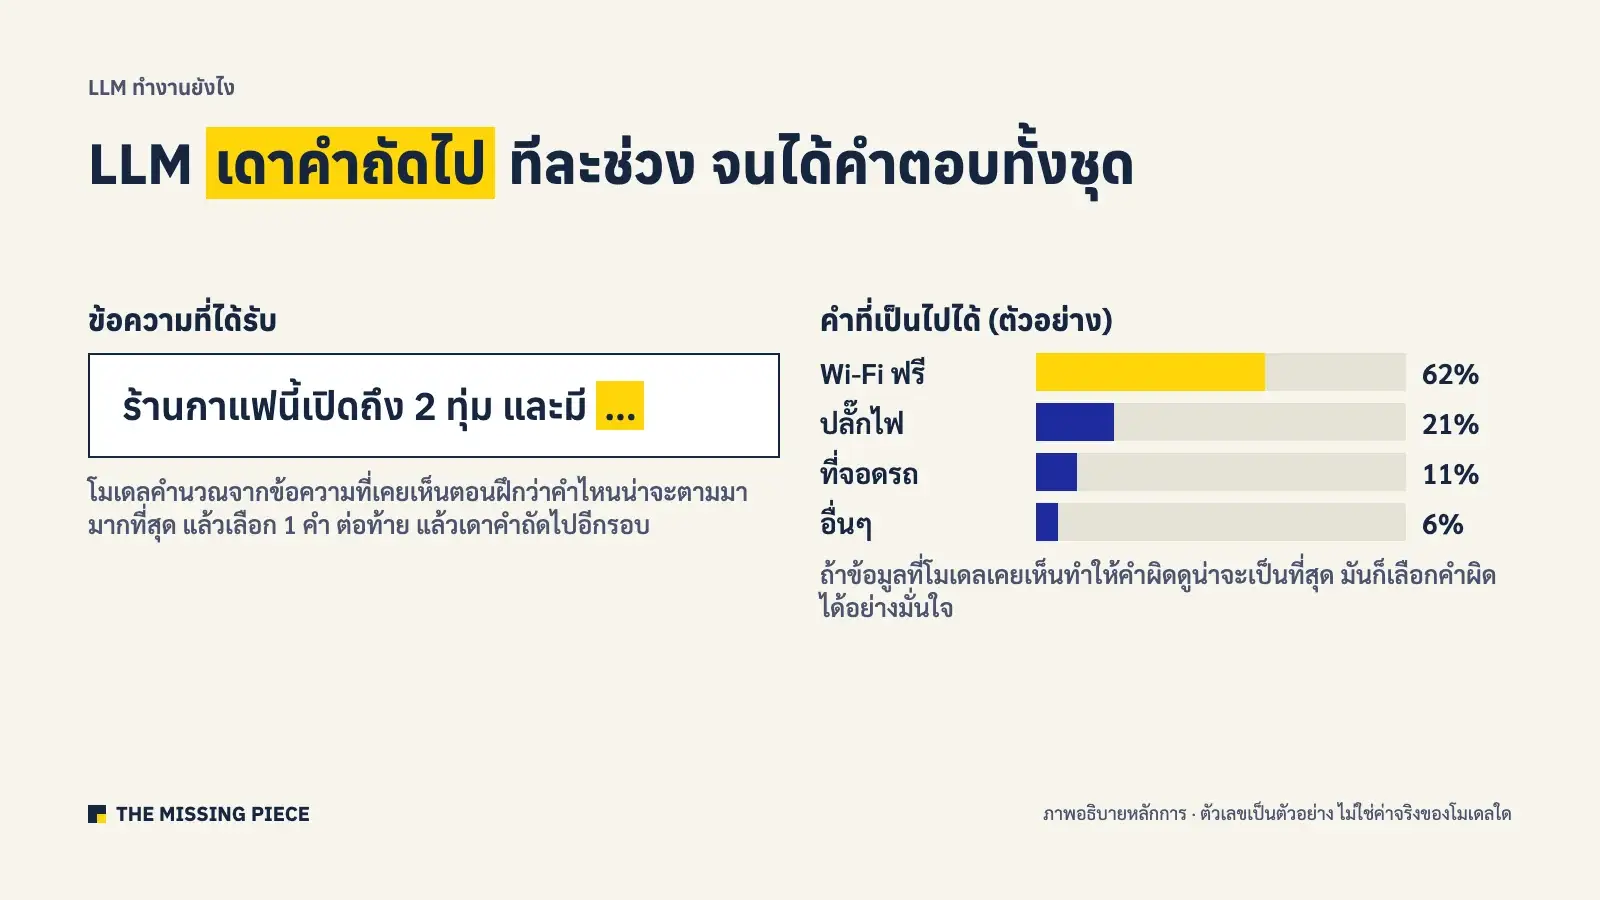
LLM (Large Language Model) หรือโมเดลภาษาขนาดใหญ่ คือ AI ที่เรียนรู้รูปแบบของภาษาจากข้อความจำนวนมหาศาล แล้วใช้รูปแบบนั้นเดาว่าคำถัดไปควรเป็นอะไร เมื่อเดาต่อกันไปเรื่อยๆ ก็ได้เป็นประโยค ย่อหน้า และคำตอบทั้งชุด ความสามารถที่เราเห็นใน ChatGPT, Gemini และ Claude ทั้งการตอบคำถาม เขียนแคปชัน สรุปรายงาน และแปลภาษา มาจากกลไกเดียวกันนี้
คำว่า “ขนาดใหญ่” หมายถึงทั้งปริมาณข้อความที่ใช้ฝึกและขนาดของตัวโมเดล ซึ่งวัดเป็นจำนวนพารามิเตอร์ (ค่าตัวเลขภายในที่โมเดลปรับระหว่างฝึก) โมเดลภาษาไทยของรัฐอย่าง ThaiLLM มีรุ่น 8 พันล้านและ 30 พันล้านพารามิเตอร์ (สวทช., เม.ย. 2026) ส่วนโมเดลหลักของ OpenAI, Google และ Anthropic ไม่เปิดเผยจำนวนพารามิเตอร์
ถ้าคุณค้นคำว่า “LLM” แล้วเจอ “LL.M.” นั่นคือปริญญาโทนิติศาสตร์ ซึ่งเป็นคนละเรื่องกับบทความนี้
LLM ต่างจาก AI, Generative AI และ ChatGPT ยังไง
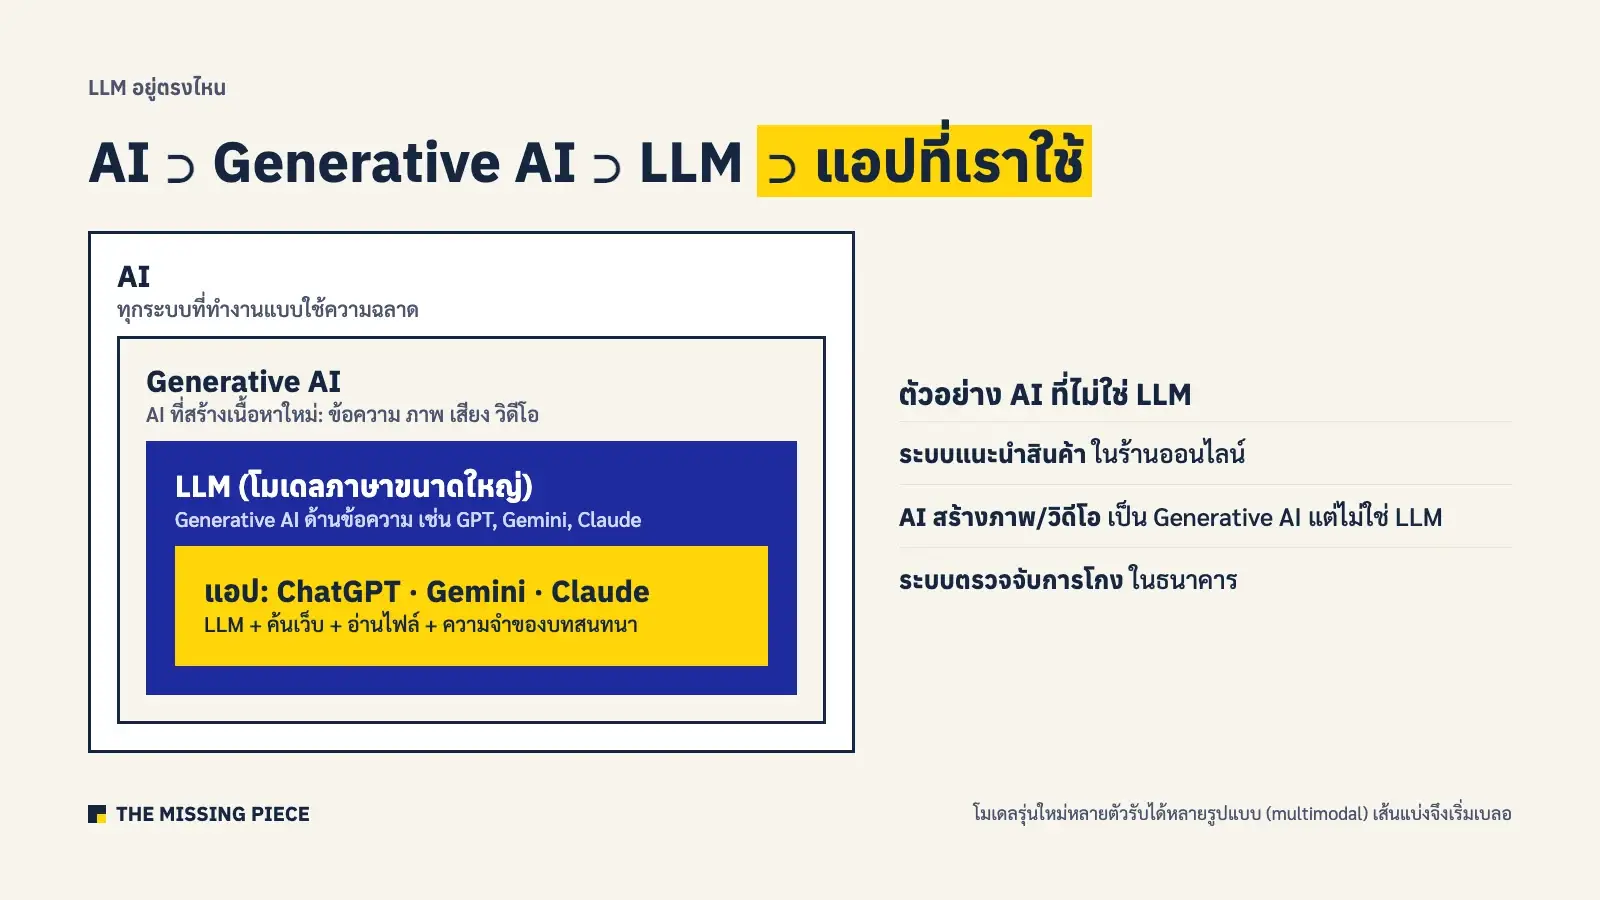
LLM เป็น AI ประเภทหนึ่งที่อยู่ในกลุ่ม Generative AI ส่วน ChatGPT, Gemini และ Claude เป็นแอปที่ใช้ LLM เป็นเครื่องยนต์ ลองนึกเป็นวงซ้อนกัน วงนอกสุดคือ AI ทั้งหมด ข้างในคือ Generative AI ข้างในอีกชั้นคือ LLM ส่วนแอปแชตที่เราใช้คือชั้นที่เอา LLM มาใช้งาน พร้อมความสามารถเสริม เช่น การค้นเว็บ การอ่านไฟล์ และหน่วยความจำของบทสนทนา
Generative AI คืออะไร
Generative AI คือ AI ที่สร้างเนื้อหาใหม่ได้ ไม่ว่าจะเป็นข้อความ ภาพ เสียง หรือวิดีโอ LLM คือ Generative AI ที่เชี่ยวชาญด้านข้อความ ส่วนเครื่องมือสร้างภาพหรือวิดีโอเป็น Generative AI ที่ไม่ใช่ LLM ทุกวันนี้โมเดลรุ่นใหม่หลายตัวรับและสร้างได้หลายรูปแบบในตัวเดียว (multimodal) เส้นแบ่งจึงเริ่มเบลอ แต่แกนของงานข้อความยังเป็น LLM
Gemini เป็น LLM ไหม
Gemini เป็นทั้งชื่อตระกูลโมเดล LLM ของ Google และชื่อแอปผู้ช่วยที่ใช้โมเดลนั้น ฝั่ง OpenAI แยกชื่อชัดกว่า คือ GPT เป็นตระกูลโมเดล ส่วน ChatGPT เป็นชื่อแอป ขณะที่ Claude เป็นทั้งชื่อโมเดลและชื่อแอปของ Anthropic ความต่างนี้สำคัญเวลาอ่านข่าวหรือราคา เพราะ “รุ่นโมเดล” กับ “แพ็กเกจของแอป” เป็นคนละเรื่องกัน
LLM ทำงานยังไง: token และ context window
LLM ไม่ได้อ่านเป็นตัวอักษรหรือคำแบบที่คนอ่าน แต่ตัดข้อความเป็นชิ้นเล็กๆ ที่เรียกว่า token ก่อน แล้วคำนวณว่า token ถัดไปควรเป็นอะไร สถาปัตยกรรมที่ LLM แทบทุกตัวใช้เรียกว่า Transformer ซึ่ง Google เสนอในงานวิจัยปี 2017 จุดเด่นคือดูความสัมพันธ์ของทุกคำในข้อความพร้อมกัน ทุกอย่างที่เกี่ยวกับ LLM ทั้งราคา ความเร็ว และความยาวสูงสุดที่ใส่ได้ นับเป็น token ทั้งหมด
Token คืออะไร
Token คือหน่วยข้อความที่ LLM ใช้ประมวลผล อาจเป็นทั้งคำ ส่วนของคำ หรือตัวอักษรไม่กี่ตัว Google ระบุว่าสำหรับโมเดล Gemini หนึ่ง token เท่ากับราว 4 ตัวอักษรภาษาอังกฤษ และ 100 token เท่ากับราว 60–80 คำภาษาอังกฤษ (Gemini API docs, ต.ค. 2026) ค่าบริการ API (ช่องทางที่โปรแกรมอื่นเรียกใช้ LLM) ของผู้ให้บริการส่วนใหญ่คิดตามจำนวน token ที่ส่งเข้าและที่ได้ออกมา
ทำไมภาษาไทยใช้ token มากกว่า
ภาษาไทยใช้ token มากกว่าภาษาอังกฤษเพราะ tokenizer (ตัวตัดข้อความ) ส่วนใหญ่เรียนรู้จากข้อความภาษาอังกฤษเป็นหลัก คำไทยจึงถูกหั่นเป็นชิ้นเล็กกว่า เราทดสอบด้วยข้อความการตลาด 5 คู่ที่ความหมายเดียวกันทั้งไทยและอังกฤษ นับด้วย tokenizer ของ OpenAI 2 รุ่น ผลคือ tokenizer o200k (ใช้ตั้งแต่ GPT-4o) ใช้ token กับภาษาไทยมากกว่า 1.39 เท่า ส่วนรุ่นเก่า (cl100k ของ GPT-4 และ GPT-3.5) มากกว่าถึง 3.3 เท่า
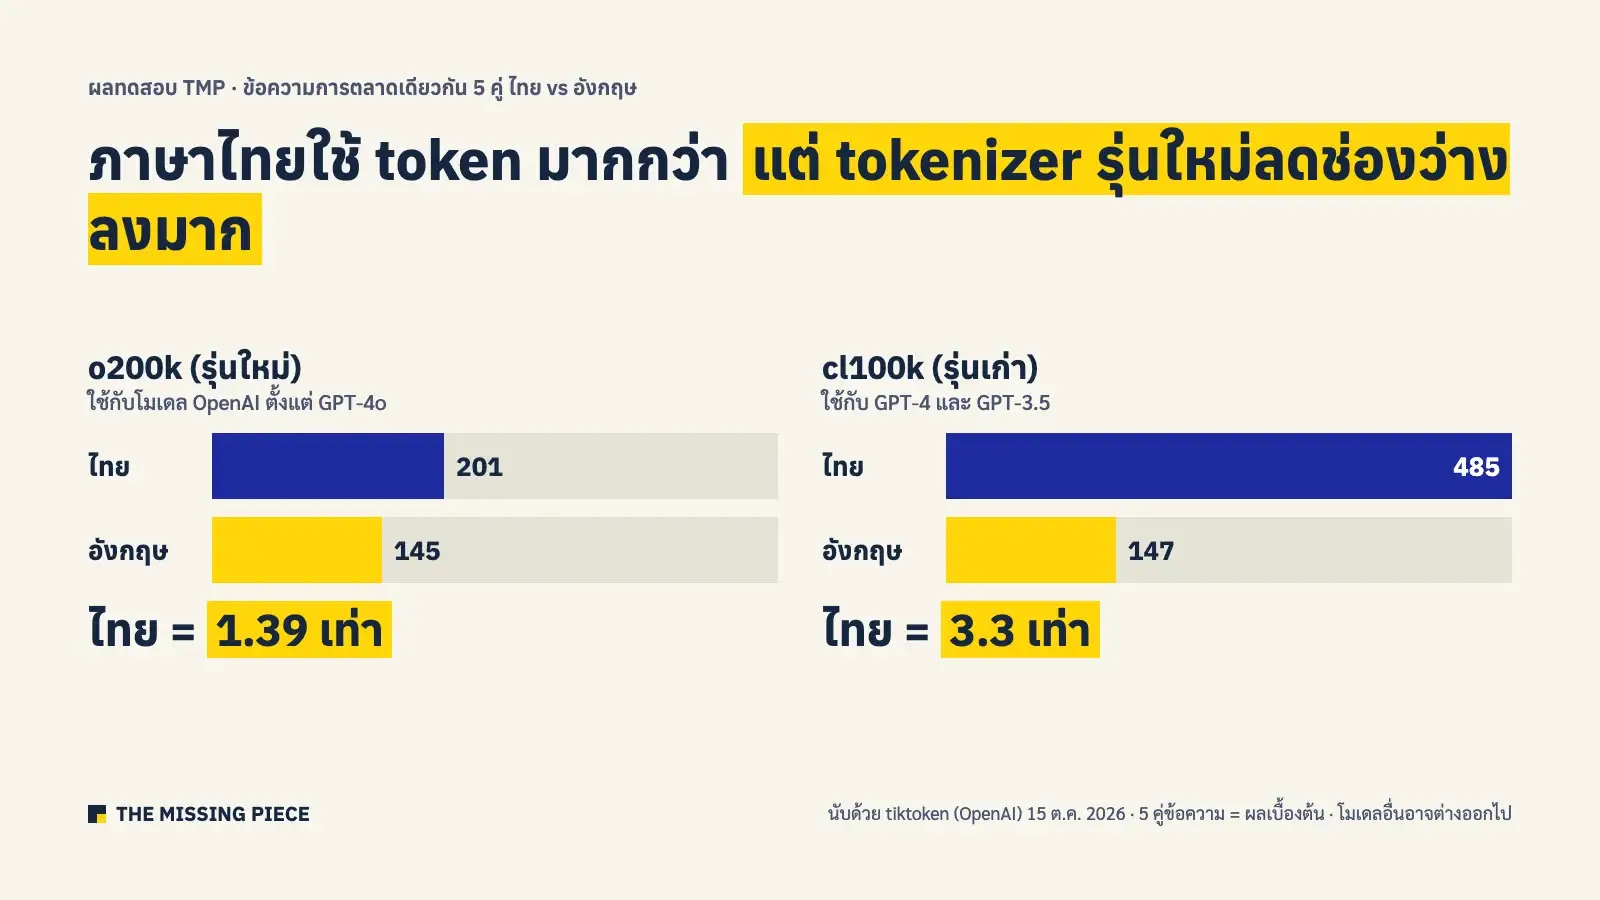
ผลนี้มีผลกับงานจริง 2 เรื่อง เรื่องแรก ถ้าทีมใช้ LLM ผ่าน API ทำงานภาษาไทยปริมาณมาก ควรเผื่องบมากกว่าที่ตัวอย่างภาษาอังกฤษบอก เรื่องที่สอง เครื่องมือหรือโมเดลรุ่นเก่ากว่าจะเสียเปรียบกับภาษาไทยมากกว่า ทดสอบนี้มีแค่ 5 คู่และนับเฉพาะ tokenizer ของ OpenAI จึงเป็นผลเบื้องต้น โมเดลอื่นอาจได้อัตราส่วนต่างออกไป
Context window คืออะไร
Context window คือจำนวน token สูงสุดที่ LLM อ่านและคิดได้ในคราวเดียว ซึ่งรวมทั้งคำสั่ง ไฟล์ที่แนบ ประวัติบทสนทนา และคำตอบ ในปี 2026 โมเดลหลักของ Google และ OpenAI รับได้ราว 1 ล้าน token (Gemini API docs และ OpenAI API docs, ต.ค. 2026) พอใส่เอกสารยาวหลายร้อยหน้าได้ แต่ใส่ได้มากไม่ได้แปลว่าโมเดลจะใช้ทุกรายละเอียดได้ดีเท่ากัน การให้เฉพาะข้อมูลที่เกี่ยวข้องและคำสั่งที่ชัดจึงยังได้ผลดีกว่า
AI รู้จักแบรนด์ของคุณจาก 2 ช่องทาง
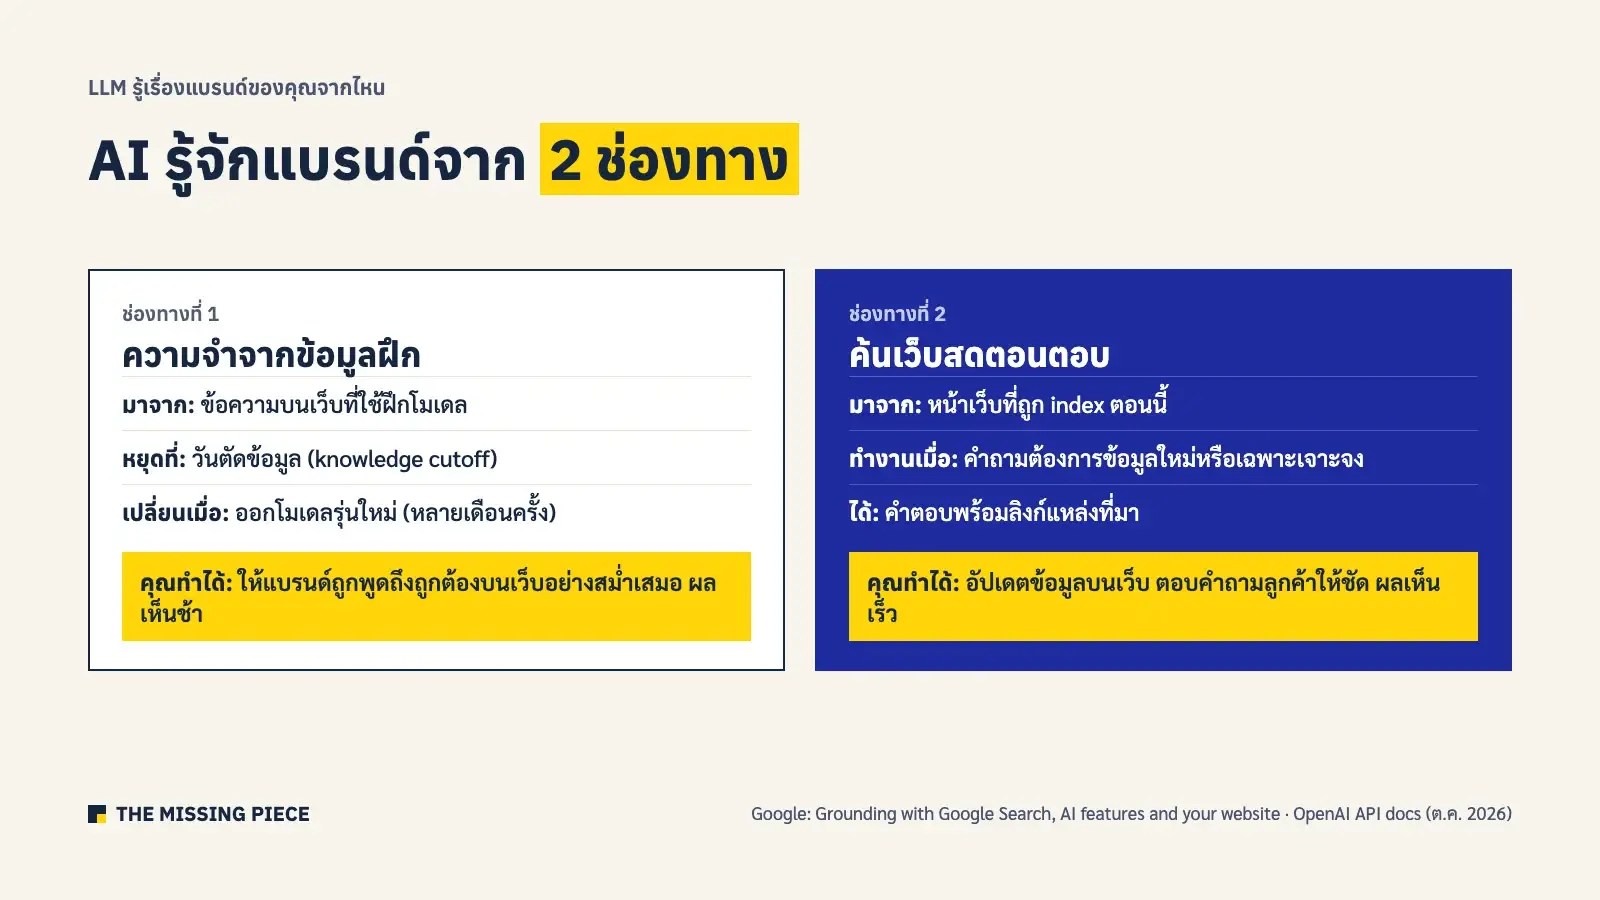
LLM รู้เรื่องแบรนด์ของคุณได้ 2 ทาง ทางแรกคือความจำจากข้อมูลที่ใช้ฝึก ซึ่งหยุดอยู่ที่วันตัดข้อมูล (knowledge cutoff) ทางที่สองคือการค้นเว็บสดตอนตอบ ซึ่ง Google เรียกว่า grounding การเข้าใจ 2 ช่องทางนี้ตอบคำถามที่นักการตลาดถามบ่อย เช่น ทำไม AI ยังพูดถึงโปรโมชันเก่า หรือทำไม AI แนะนำคู่แข่งแต่ไม่พูดถึงเรา
ช่องทางที่ 1: ความจำจากข้อมูลฝึก
ความรู้ที่ฝังอยู่ในตัวโมเดลมาจากข้อความที่ใช้ฝึก และหยุดอยู่ที่วันตัดข้อมูลของรุ่นนั้น โมเดลล่าสุดของ OpenAI ที่เปิดให้ใช้ผ่าน API ในเดือน ต.ค. 2026 มีวันตัดข้อมูลราว เม.ย.–พ.ค. 2026 (OpenAI API docs) อะไรที่เกิดหลังจากนั้น เช่น ราคาใหม่ สาขาใหม่ หรือชื่อสินค้าที่เพิ่งเปลี่ยน โมเดลจะไม่รู้จากความจำ ถ้าแบรนด์ของคุณถูกพูดถึงน้อยบนเว็บก่อนวันนั้น ความจำของโมเดลเกี่ยวกับคุณก็จะน้อยหรือคลาดเคลื่อน
ช่องทางที่ 2: ค้นเว็บสดตอนตอบ
เมื่อคำถามต้องการข้อมูลใหม่หรือข้อเท็จจริงเฉพาะ แอปอย่าง ChatGPT, Gemini และ AI ใน Google Search จะค้นเว็บก่อนตอบ ตัวอย่างที่มีเอกสารชัดคือ Gemini API ของ Google ซึ่งอธิบายไว้ 5 ขั้น คือ รับคำถาม ตัดสินใจว่าต้องค้นไหม สร้างคำค้น 1 คำหรือหลายคำ อ่านผลแล้วสังเคราะห์ และตอบพร้อมลิงก์แหล่งที่มา (Gemini API docs, Grounding with Google Search) ช่องทางนี้คือส่วนที่เว็บของคุณมีผลโดยตรง เพราะหน้าที่ถูก index (เก็บเข้าฐานข้อมูลของเครื่องมือค้นหา) และตอบคำถามได้ชัดคือวัตถุดิบของคำตอบ ถ้า AI แนะนำคู่แข่งแต่ไม่พูดถึงคุณ มักแปลว่าหน้าที่ AI ค้นเจอสำหรับคำถามนั้นพูดถึงคู่แข่งมากกว่า หรือไม่มีหน้าของคุณที่ตอบคำถามนั้นตรงๆ ซึ่งหนังสือ AI SEO For Dummies (บทที่ 20) แนะนำให้ทำหน้าที่ช่วยลูกค้าตัดสินใจไว้รองรับ ส่วน Google Search ไม่มีเงื่อนไขทางเทคนิคเพิ่มสำหรับ AI นอกจากหน้าต้องถูก index และแสดง snippet ได้ (Google Search Central)
หนังสือ AI SEO For Dummies (บทที่ 2 และ 4) อธิบายเรื่องเดียวกันจากฝั่งคนทำการตลาด คือ AI จะแนะนำแบรนด์ได้ก็ต่อเมื่อเจอข้อมูลที่ถูกต้อง สดใหม่ และอธิบายแบรนด์ได้ชัดในหน้าที่มันค้นเจอ การทำให้ทั้ง 2 ช่องทางรู้จักคุณถูกต้องคือแกนของงานที่เรียกว่า AI Search อ่านภาพรวมได้ที่ AI Search คืออะไร และขั้นตอนลงมือที่ วิธีทำ AI SEO ทีละขั้น
RAG (Retrieval-Augmented Generation) คือชื่อเทคนิคทั่วไปของการดึงข้อมูลจากแหล่งภายนอกมาให้ LLM ใช้ตอบ การค้นเว็บสดของแอปแชตเป็นรูปแบบหนึ่งของแนวคิดนี้ ส่วนธุรกิจที่อยากให้ AI ตอบจากเอกสารภายในของตัวเองก็ใช้หลักเดียวกัน เราจะอธิบาย RAG แยกในบทความถัดไป
ทำให้ AI เก็บข้อมูลแบรนด์ได้ง่าย และเจอสิ่งที่ถูกต้อง
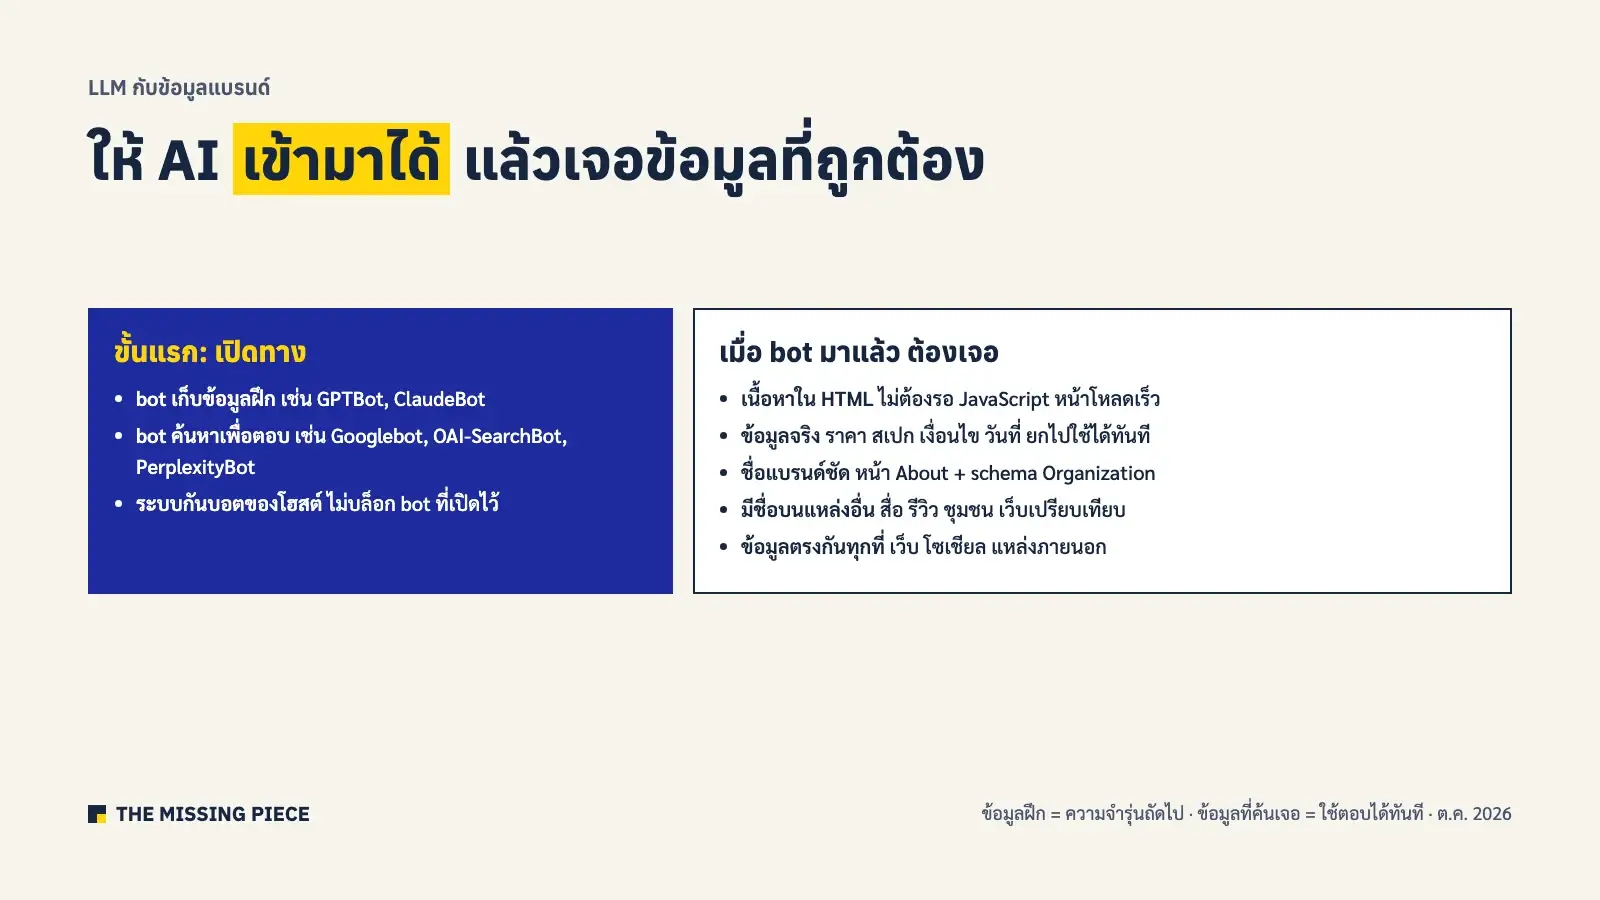
นักการตลาดช่วยให้ AI รู้จักแบรนด์ได้ทั้ง 2 ช่องทางด้วย 2 ขั้น คือเปิดให้ bot ของบริษัท AI เข้ามาเก็บข้อมูลได้ และทำให้สิ่งที่ bot เจอเป็นข้อมูลที่ถูกต้อง ครบ และยกไปใช้ได้ทันที ข้อมูลที่เข้าไปอยู่ในชุดฝึกวันนี้มีโอกาสอยู่ในความจำของโมเดลรุ่นถัดไป ส่วนข้อมูลที่ bot ค้นหาเจอใช้ตอบได้โดยไม่ต้องรอโมเดลรุ่นใหม่
ขั้นแรก: เปิดทางให้ bot เข้ามาได้
- bot เก็บข้อมูลฝึก เช่น GPTBot ของ OpenAI และ ClaudeBot ของ Anthropic ถ้าอยากให้ข้อมูลแบรนด์มีโอกาสเข้าไปอยู่ในความจำของโมเดลรุ่นถัดไป ต้องไม่บล็อก bot กลุ่มนี้ใน robots.txt ส่วน Google ใช้คำสั่ง Google-Extended ควบคุมการนำข้อมูลไปใช้ฝึกและตอบใน Gemini แยกจาก Googlebot และไม่มีผลต่อการติดอันดับใน Google Search
- bot ค้นหาเพื่อตอบ เช่น Googlebot, OAI-SearchBot และ PerplexityBot ต้องเปิดไว้ ถ้าอยากถูกอ้างในคำตอบ วิธีตั้งค่าทีละ bot อยู่ใน robots.txt สำหรับ AI bot และเฉพาะ ChatGPT อยู่ใน ChatGPT SEO คืออะไร
- เช็กระบบกันบอตของโฮสต์และ firewall บางระบบบล็อก bot ที่เข้าถี่โดยไม่บอกเจ้าของเว็บ ทำให้ robots.txt เปิดอยู่แต่ bot เข้าไม่ได้จริง ให้ดู log หรือรายงานของโฮสต์ว่ามี bot ของบริษัท AI เข้ามาสำเร็จหรือไม่
เมื่อ bot มาแล้ว ต้องเจออะไร
- เนื้อหาหลักอยู่ใน HTML ตั้งแต่โหลดหน้า ไม่ต้องรอ JavaScript ทำงาน เพราะ bot ของ AI หลายตัว เช่น GPTBot และ ClaudeBot ไม่รัน JavaScript (Vercel, ธ.ค. 2024) และหน้าเว็บโหลดเร็ว ไม่ติดหน้ายืนยันตัวตน
- ข้อมูลจริงที่ยกไปใช้ได้ทันที เช่น ราคา สเปก เงื่อนไข ตัวเลข และวันที่ เขียนเป็นประโยคที่อ่านเข้าใจได้ในตัว โดยตอบคำถามตั้งแต่ประโยคแรกของแต่ละหัวข้อ
- ชื่อแบรนด์และข้อมูลหลักชัดเจน ใช้ชื่อเดียวกันทุกที่ มีหน้า About ที่บอกว่าใครทำอะไร และใส่ schema แบบ Organization ให้เครื่องอ่านข้อมูลหลักได้ง่าย อ่านวิธีทำให้ AI เข้าใจว่าแบรนด์คือใครใน Entity SEO คืออะไร
- มีชื่อบนแหล่งอื่นที่ AI เชื่อ เช่น สื่อ เว็บรีวิว ชุมชน และเว็บเปรียบเทียบ เพราะ AI ใช้แหล่งภายนอกยืนยันว่าข้อมูลของแบรนด์จริง
- ข้อมูลตรงกันทุกที่ ถ้าเว็บหลักกับแหล่งภายนอกบอกข้อมูลขัดกัน AI อาจเลือกเชื่อแหล่งที่ผิด
ส่วนไฟล์ llms.txt เป็นทางเลือกเสริม ไม่ใช่สิ่งจำเป็น Google ระบุว่าไม่ได้ใช้ไฟล์นี้ใน Search รายละเอียดอยู่ใน llms.txt คืออะไร ต้องทำไหม หนังสือ AI SEO For Dummies (บทที่ 2) อธิบายลำดับเดียวกันว่า AI ต้องเข้าเว็บได้และอ่านเนื้อหาจาก HTML ได้ก่อน จึงจะเข้าใจและแนะนำแบรนด์ได้ และ The Art of SEO (บทที่ 7) อธิบายปัญหาของหน้าที่พึ่ง JavaScript ไว้ตั้งแต่ก่อนยุค AI ซึ่งยังใช้ได้กับ AI bot ในวันนี้
ทำไม LLM ตอบผิดอย่างมั่นใจ (hallucination)
LLM ตอบผิดอย่างมั่นใจเพราะงานของมันคือเดาคำถัดไปที่น่าจะเป็น ไม่ใช่ตรวจว่าข้อมูลจริงไหม อาการนี้เรียกว่า hallucination OpenAI อธิบายว่าส่วนหนึ่งมาจากวิธีฝึกและวัดผลที่ให้รางวัลกับการเดามากกว่าการตอบว่า “ไม่รู้” โมเดลจึงเรียนรู้ที่จะเดาเมื่อไม่แน่ใจ (OpenAI, Why language models hallucinate, ก.ย. 2025)
ปัญหานี้ยังไม่หายไปในปี 2026 แม้แต่งานที่ง่ายกว่าการตอบจากความจำ เช่น การสรุปบทความที่มีต้นฉบับให้ตรงหน้า กระดานวัดผลของ Vectara พบว่ารุ่นหลักล่าสุดของ OpenAI, Google และ Anthropic ยังใส่ข้อมูลที่ไม่มีในต้นฉบับราว 6–12% ของบทสรุป แล้วแต่รุ่น (Vectara Hallucination Leaderboard, อัปเดต 22 ก.ย. 2026) ตัวเลขนี้วัดเฉพาะงานสรุปความภาษาอังกฤษ ไม่ได้บอกความแม่นของการตอบคำถามทั่วไปหรือภาษาไทย
การอ้างแหล่งที่มาก็ผิดได้เช่นกัน ตอนค้นข้อมูลสำหรับบทความนี้ เราถาม OpenAI ผ่าน API (ChatGPT) พร้อมเปิดค้นเว็บว่า LLM คืออะไร คำตอบอ้าง URL ของ IBM ที่ไม่มีอยู่จริง (ทดสอบ 1 ครั้ง, 15 ต.ค. 2026) ลิงก์ที่ดูน่าเชื่อจึงต้องกดเปิดดูทุกครั้งก่อนนำไปอ้างต่อ
อีกอาการที่นักการตลาดควรรู้คือคำตอบไม่นิ่ง ถามคำถามเดิมซ้ำอาจได้คำตอบและแหล่งอ้างอิงต่างกัน ในผลทดสอบ Google AI Mode ภาษาไทยของเรา (20 คำถาม × 3 รอบ, 14 ต.ค. 2026) ถามซ้ำในวันเดียวกัน ลิงก์ที่ AI อ้างซ้ำกันแค่ 24% หนังสือ AI SEO For Dummies (บทที่ 8) จึงแนะนำให้วัดผลจากการถามชุดคำถามเดิมหลายรอบ ไม่ใช่จากครั้งเดียว วิธีทำอยู่ใน Prompt Tracking
LLM มีอะไรบ้างในปี 2026
LLM ที่นักการตลาดไทยเจอบ่อยในปี 2026 มาจาก 4 กลุ่ม คือ GPT ของ OpenAI, Gemini ของ Google, Claude ของ Anthropic และโมเดลแบบเปิด (open-weight) ที่ดาวน์โหลดไปใช้เองได้ เช่น Llama, Gemma และ Qwen ชื่อรุ่นเปลี่ยนเร็วมาก ตารางนี้จึงเน้นว่าแต่ละกลุ่มเจอได้ที่ไหน มากกว่าชื่อรุ่น
| ตระกูลโมเดล | บริษัท | เจอได้ที่ | จุดที่นักการตลาดควรรู้ |
|---|---|---|---|
| GPT | OpenAI | ChatGPT, API, เครื่องมือที่ต่อ API | ChatGPT ค้นเว็บเมื่อคำถามต้องการข้อมูลใหม่ |
| Gemini | แอป Gemini, AI Overviews, AI Mode, Google Workspace | ใช้ข้อมูลจากดัชนีค้นหาของ Google ตอนตอบใน Search | |
| Claude | Anthropic | แอป Claude, Claude Code, API | ใช้ทำงานหลายขั้นต่อเนื่องผ่าน Claude Code ได้ |
| โมเดลแบบเปิด (Llama, Gemma, Qwen ฯลฯ) | Meta, Google, Alibaba และอื่นๆ | ดาวน์โหลดไปรันเอง หรือผ่านผู้ให้บริการคลาวด์ | ข้อมูลไม่ต้องออกนอกองค์กร แต่ต้องมีทีมดูแล |
ถ้าอยากรู้ว่ารุ่นไหนเก่งงานแบบไหน มีกระดานจัดอันดับหลายแห่งที่เปิดให้ดูฟรี เช่น LMArena ที่ให้คนโหวตคำตอบแบบไม่เห็นชื่อโมเดล และ Vectara ที่วัดการใส่ข้อมูลเกิน แต่คะแนนเหล่านี้วัดงานภาษาอังกฤษเป็นหลัก วิธีที่ตรงกับงานของคุณกว่าคือการลองงานจริงของทีมกับ 2–3 โมเดลแล้วเทียบผล ตัวอย่างการใช้ LLM ทำงานการตลาดจริงอยู่ใน AI Agent คืออะไร: คู่มือนักการตลาด
LLM ภาษาไทย: ThaiLLM, Typhoon และ OpenThai
ไทยมี LLM ที่ฝึกเน้นภาษาไทยหลายตัวในปี 2026 ตัวที่เด่นคือ ThaiLLM ของภาครัฐ ชุดโมเดล Typhoon ของกลุ่ม SCBX และ OpenThai จาก iApp โมเดลเหล่านี้เหมาะกับองค์กรที่อยากรันโมเดลเอง ต้องการความเข้าใจภาษาไทยและบริบทไทย หรือมีข้อจำกัดเรื่องการส่งข้อมูลออกนอกประเทศ
| โมเดล | ผู้พัฒนา | ขนาด/จุดเด่น | ลองได้ที่ |
|---|---|---|---|
| ThaiLLM | กระทรวงดิจิทัลฯ ร่วมกับ สวทช. (NECTEC), BDI และหน่วยงานรัฐ | รุ่น 8B และ 30B ฝึกด้วยข้อความไทยกว่า 1 แสนล้าน token ประกาศเปิดตัว เม.ย. 2026 | thaillm.or.th |
| Typhoon | SCB 10X / SCB DataX (กลุ่ม SCBX) | ชุดโมเดลภาษาไทยหลายรุ่น มีรุ่นเฉพาะทาง เช่น การแพทย์ | opentyphoon.ai |
| OpenThai 2.0 | iApp Technology | 27B รับทั้งข้อความและภาพ license Apache 2.0 | Hugging Face (iapp) |
สำหรับนักการตลาดส่วนใหญ่ ผลที่เห็นทุกวันยังมาจาก ChatGPT, Gemini และ AI ใน Google Search เพราะเป็นที่ที่ลูกค้าถามจริง งาน AI Search จึงยังโฟกัสที่แพลตฟอร์มเหล่านี้ก่อน ส่วน LLM ภาษาไทยเหมาะกับงานภายในองค์กร
นักการตลาดควรทำอะไรกับ LLM
นักการตลาดควรแยกให้ออกว่าเรื่องไหนคุมได้และเรื่องไหนคุมไม่ได้ เราคุมความจำของโมเดลไม่ได้โดยตรง แต่คุมสิ่งที่ AI จะเจอตอนค้นเว็บได้มาก คนไทยใช้ Generative AI อย่างแพร่หลายแล้ว ผลสำรวจของ SCB EIC (ผู้ตอบ 1,421 คน, พ.ย.–ธ.ค. 2025) พบว่าผู้บริโภคไทย 72% เคยใช้ Generative AI และราว 30% ใช้เป็นประจำ (เผยแพร่ ก.ค. 2026) คำตอบของ AI จึงเป็นอีกหน้าร้านหนึ่งของแบรนด์
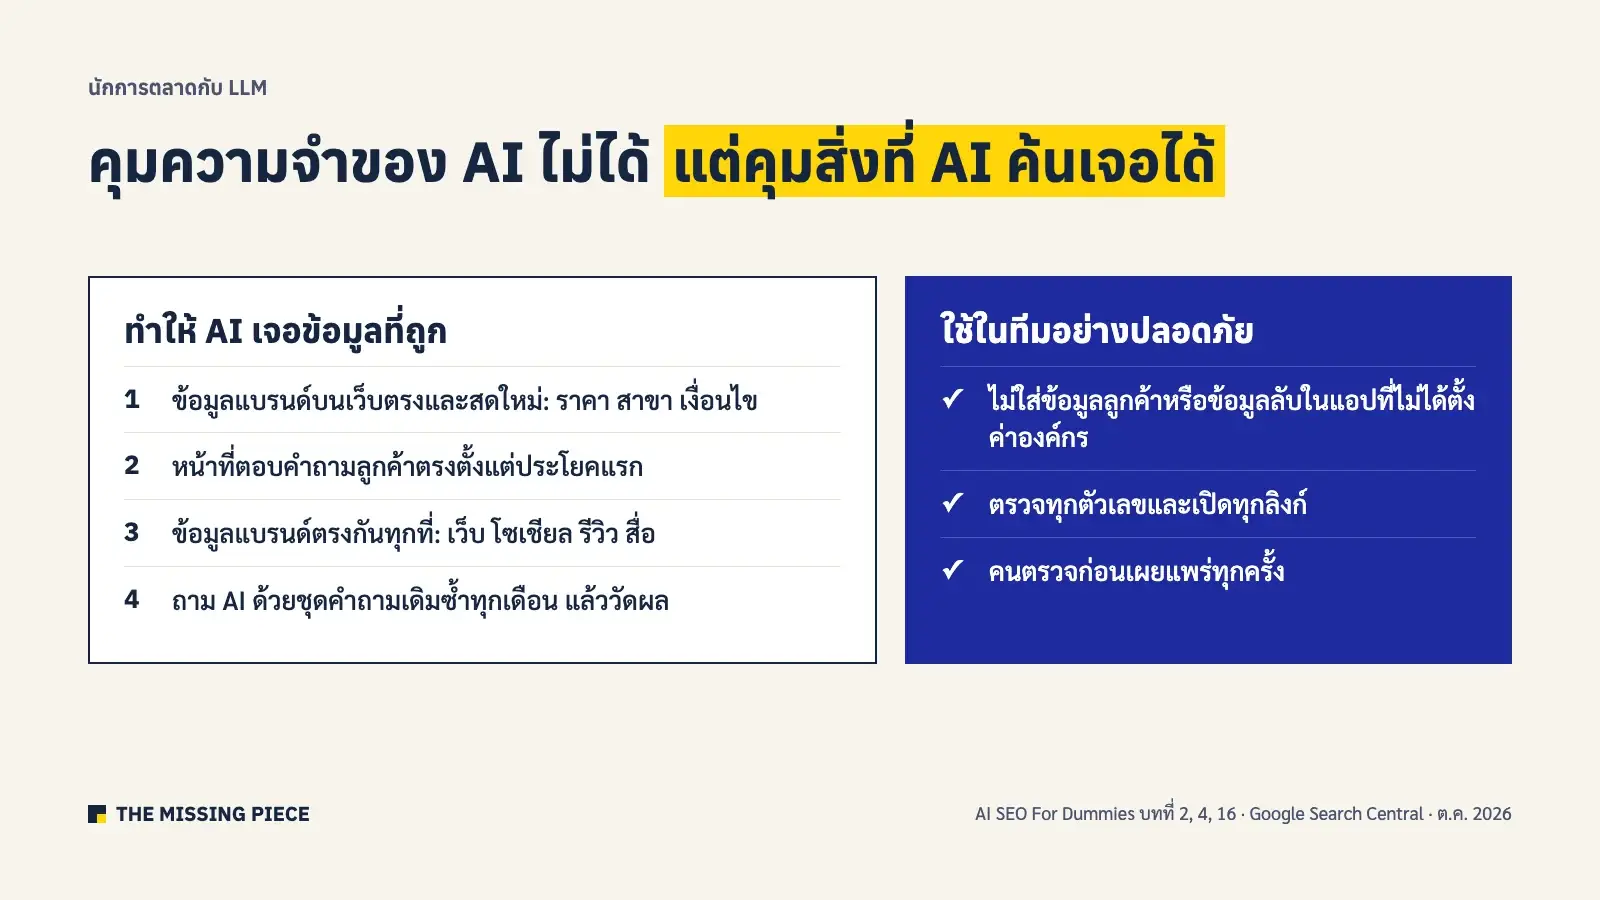
- ทำให้ข้อมูลแบรนด์บนเว็บตรงและสดใหม่ ราคา สาขา เงื่อนไข และชื่อสินค้าต้องอัปเดตบนหน้าที่เครื่องมือค้นหา index ได้ เพราะนี่คือสิ่งที่ AI ดึงไปตอบเมื่อความจำของมันล้าสมัย
- เขียนหน้าที่ตอบคำถามลูกค้าตรงตั้งแต่ประโยคแรก AI ดึงข้อความเป็นช่วงๆ ช่วงที่ตอบตรงและเข้าใจได้ในตัวมีโอกาสถูกหยิบมากกว่า
- ทำให้ข้อมูลแบรนด์ตรงกันทุกที่ เว็บหลัก โซเชียล เว็บรีวิว และสื่อที่พูดถึงคุณควรบอกข้อเท็จจริงเดียวกัน หนังสือ AI SEO For Dummies (บทที่ 16) เน้นว่าความไม่ตรงกันทำให้ AI สับสนและเลือกเชื่อแหล่งอื่น
- ถาม AI ซ้ำเป็นประจำ ตั้งชุดคำถามที่ลูกค้าจะถาม แล้ววัดว่า AI พูดถึงแบรนด์ถูกต้องแค่ไหนทุกเดือน
ด้านการใช้งานในทีม ให้ตั้งกติกา 3 ข้อ คือ ไม่ใส่ข้อมูลลูกค้าหรือข้อมูลลับลงในแอปที่ไม่ได้ตั้งค่าองค์กร ตรวจทุกตัวเลขและลิงก์ที่ LLM ให้มา และให้คนตรวจงานก่อนเผยแพร่ทุกครั้ง หนังสือ The Art of SEO (บทที่ 2) วางหลักเดียวกันว่า AI ช่วยร่างได้ แต่ผู้เชี่ยวชาญต้องตรวจข้อเท็จจริงก่อนเผยแพร่
คำถามที่พบบ่อย
LLM ย่อมาจากอะไร
LLM ย่อมาจาก Large Language Model ภาษาไทยเรียกว่าโมเดลภาษาขนาดใหญ่ คือ AI ที่ฝึกจากข้อความจำนวนมหาศาลจนเดาคำถัดไปได้แม่นพอจะตอบคำถาม เขียน และสรุปข้อความได้
AI กับ LLM ต่างกันยังไง
AI เป็นคำกว้างที่รวมทุกระบบที่ทำงานแบบใช้ความฉลาด ส่วน LLM เป็น AI ประเภทหนึ่งที่เชี่ยวชาญด้านภาษา ChatGPT, Gemini และ Claude เป็นแอปที่ใช้ LLM เป็นเครื่องยนต์
ทำไม ChatGPT ตอบเรื่องแบรนด์ของเราไม่ตรงกับปัจจุบัน
ถ้าไม่ได้ค้นเว็บ คำตอบมาจากความจำของโมเดลที่หยุดอยู่ที่วันตัดข้อมูล ถ้าค้นเว็บแล้วยังผิด มักเป็นเพราะหน้าที่ AI เจอมีข้อมูลเก่าหรือขัดกัน ทางแก้คือทำให้ข้อมูลบนเว็บและแหล่งที่พูดถึงแบรนด์ถูกต้องตรงกัน
ภาษาไทยใช้ token มากกว่าภาษาอังกฤษแค่ไหน
ในผลทดสอบของเรา (ข้อความ 5 คู่, ต.ค. 2026) ภาษาไทยใช้ token มากกว่า 1.39 เท่าบน tokenizer o200k ของ OpenAI (ใช้ตั้งแต่ GPT-4o) และ 3.3 เท่าบนรุ่นเก่า ตัวเลขต่างกันตามโมเดล
LLM ภาษาไทยมีอะไรบ้าง
ตัวที่เด่นในปี 2026 คือ ThaiLLM ของภาครัฐ (เปิดตัว เม.ย. 2026) ชุดโมเดล Typhoon ของกลุ่ม SCBX และ OpenThai 2.0 ของ iApp ซึ่งเหมาะกับงานภายในองค์กรที่ต้องการภาษาไทยหรือรันโมเดลเอง
ทำยังไงให้ AI เก็บข้อมูลแบรนด์ได้ง่ายขึ้น
เปิดให้ bot ของบริษัท AI เข้าเว็บได้ใน robots.txt และเช็กว่าระบบกันบอตไม่บล็อก จากนั้นทำให้เนื้อหาหลักอยู่ใน HTML มีข้อมูลจริงที่ยกไปใช้ได้ ชื่อแบรนด์ชัด และข้อมูลตรงกันทุกที่
แหล่งอ้างอิง
- Google AI for Developers, Understand and count tokens (อัปเดต ต.ค. 2026)
- Google AI for Developers, Grounding with Google Search (อัปเดต ต.ค. 2026)
- Google Search Central, AI features and your website (อัปเดต 10 ธ.ค. 2025)
- LMArena (กระดานจัดอันดับโมเดลจากการโหวตของผู้ใช้)
- OpenAI, Models (อ่าน ต.ค. 2026)
- OpenAI, Why language models hallucinate (5 ก.ย. 2025)
- Vectara, Hallucination Leaderboard (อัปเดต 22 ก.ย. 2026)
- สวทช., ThaiLLM (1 เม.ย. 2026)
- Typhoon (SCB 10X) · OpenThai 2.0 (iApp, Hugging Face)
- The Standard, SCB EIC: ผู้บริโภคไทยกับ Generative AI (17 ก.ค. 2026) · ThaiPublica (n = 1,421, พ.ย.–ธ.ค. 2025)
- The Missing Piece, ทดสอบ token ไทย-อังกฤษ ข้อความการตลาด 5 คู่ ด้วย tiktoken o200k_base และ cl100k_base (15 ต.ค. 2026, ผลเบื้องต้น) และผลทดสอบ Google AI Mode ภาษาไทย (ต.ค. 2026)
- Nathan Gotch, AI SEO For Dummies (Wiley, 2026) บทที่ 2, 4, 8, 16, 20
- Eric Enge, Stephan Spencer, Jessie Stricchiola, The Art of SEO, 4th ed. (O’Reilly, 2023) บทที่ 2 และ 7
- Vercel, The rise of the AI crawler (17 ธ.ค. 2024)
อัปเดตล่าสุด: ต.ค. 2026