สรุปสั้น (TL;DR)
Schema markup คือโค้ดที่บอก Google และ search engine อื่นว่าข้อมูลบนหน้าเว็บคืออะไร เช่น บทความ สินค้า ราคา หรือที่อยู่ร้าน โดยใช้คำศัพท์กลางของ schema.org schema ไม่ได้ทำให้อันดับดีขึ้นโดยตรง แต่ทำให้หน้ามีสิทธิ์ได้ผลค้นหาแบบพิเศษ (rich results) และช่วยให้ Google เข้าใจว่าหน้านี้กับธุรกิจของคุณคือใคร
- Google เลิกแสดง FAQ rich results ตั้งแต่ 7 พ.ค. 2026 และเลิก HowTo ตั้งแต่ ก.ย. 2023 แต่ในผลสำรวจหน้าไทยที่ติด 10 อันดับแรก 236 หน้าของเรา (7 ต.ค. 2026) ยังมี FAQPage 9% และยังมี markup ของช่องค้นหาในผลค้นหา (sitelinks search box) ที่เลิกไปตั้งแต่ปี 2024 อยู่ 18%
- 37% ของหน้าไทยที่ติดหน้าแรกไม่มี structured data เลย และหน้าอันดับ 1–3 มี JSON-LD ในสัดส่วนพอๆ กับอันดับ 4–10 (56% กับ 59%) สอดคล้องกับที่ Google บอกว่า schema ไม่ใช่ปัจจัยจัดอันดับ
- เริ่มจาก JSON-LD ที่ปลั๊กอิน SEO สร้างให้ แล้วเพิ่ม type ที่ตรงกับธุรกิจ เช่น LocalBusiness หรือ Product โดยข้อมูลต้องตรงกับที่แสดงบนหน้า และตรวจด้วย Rich Results Test ทุกครั้ง
สารบัญ
- Schema Markup คืออะไร
- Schema, Structured Data, JSON-LD, Rich Results ต่างกันยังไง
- Schema ช่วย SEO ไหม
- Rich results ปี 2026 เหลือแบบไหน
- FAQ schema ยังควรใส่ไหม
- เว็บไทยที่ติดหน้าแรกใช้ schema อะไร
- JSON-LD คืออะไร + ตัวอย่าง 5 แบบ
- วิธีใส่ Schema ในเว็บ
- ตัวอย่างจริง: schema ของเว็บเรา
- Wikidata จำเป็นไหม
- ตรวจ schema และทำไมใส่แล้วไม่ขึ้น
- Schema กับ AI Search
- คำถามที่พบบ่อย
Schema Markup คืออะไร
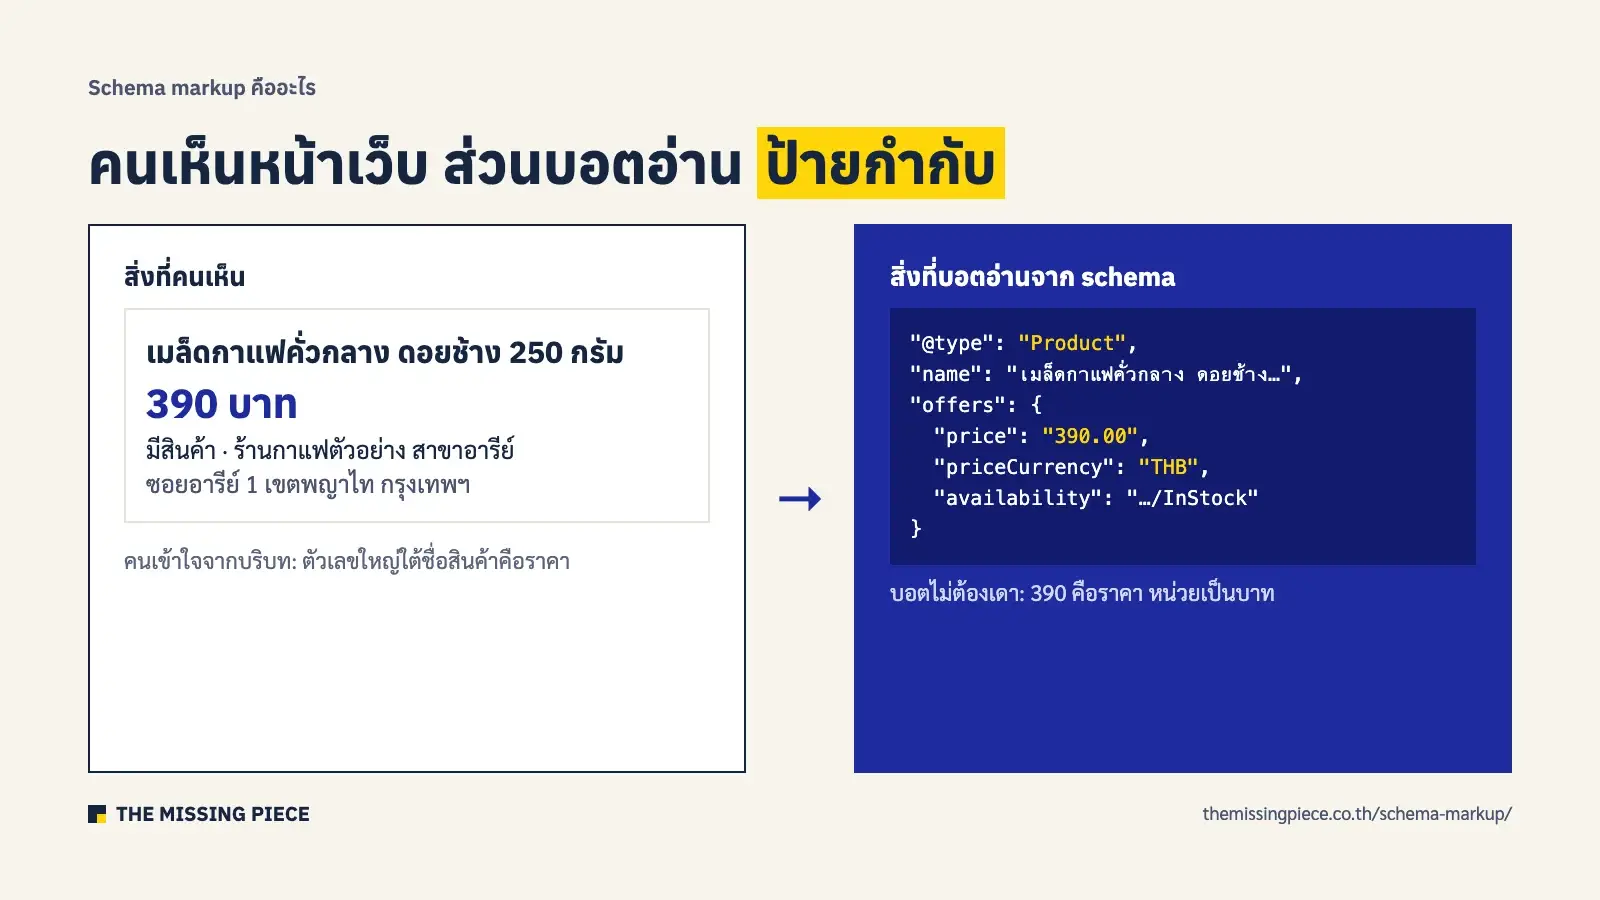
Schema markup (สคีมามาร์กอัป) คือโค้ดที่ใส่ไว้ในหน้าเว็บเพื่อบอก search engine ว่าข้อมูลแต่ละส่วนบนหน้าคืออะไร โดยใช้คำศัพท์กลางจาก schema.org เช่น บอกว่า “390” คือราคาเป็นบาท “ดอยช้าง 250 กรัม” คือชื่อสินค้า และ “ซอยอารีย์ 1” คือที่อยู่ร้าน คนอ่านหน้าเว็บเข้าใจเรื่องพวกนี้เองจากบริบท แต่บอตต้องเดา schema จึงเป็นป้ายกำกับที่ช่วยให้บอตไม่ต้องเดา (schema เป็นงานส่วนหนึ่งของ SEO อ่านภาพรวมได้ใน SEO คืออะไร)
Google ใช้ schema เพื่อเข้าใจเนื้อหาของหน้า และใช้ตัดสินว่าหน้ามีสิทธิ์แสดงเป็นผลค้นหาแบบพิเศษหรือไม่ เช่น ราคาสินค้า ดาวรีวิว หรือกล่องหางาน ตามเอกสาร Introduction to structured data ของ Google (อัปเดต 10 ธ.ค. 2025)
คำว่า “schema” ในบทความนี้หมายถึง schema markup สำหรับเว็บไซต์และ SEO ไม่ใช่ database schema (โครงสร้างฐานข้อมูล) หรือ schema ในทางจิตวิทยา ซึ่งเป็นความหมายที่ขึ้นในผลค้นหาคำว่า “schema คือ” เป็นส่วนใหญ่
Schema, Structured Data, JSON-LD, Rich Results ต่างกันยังไง
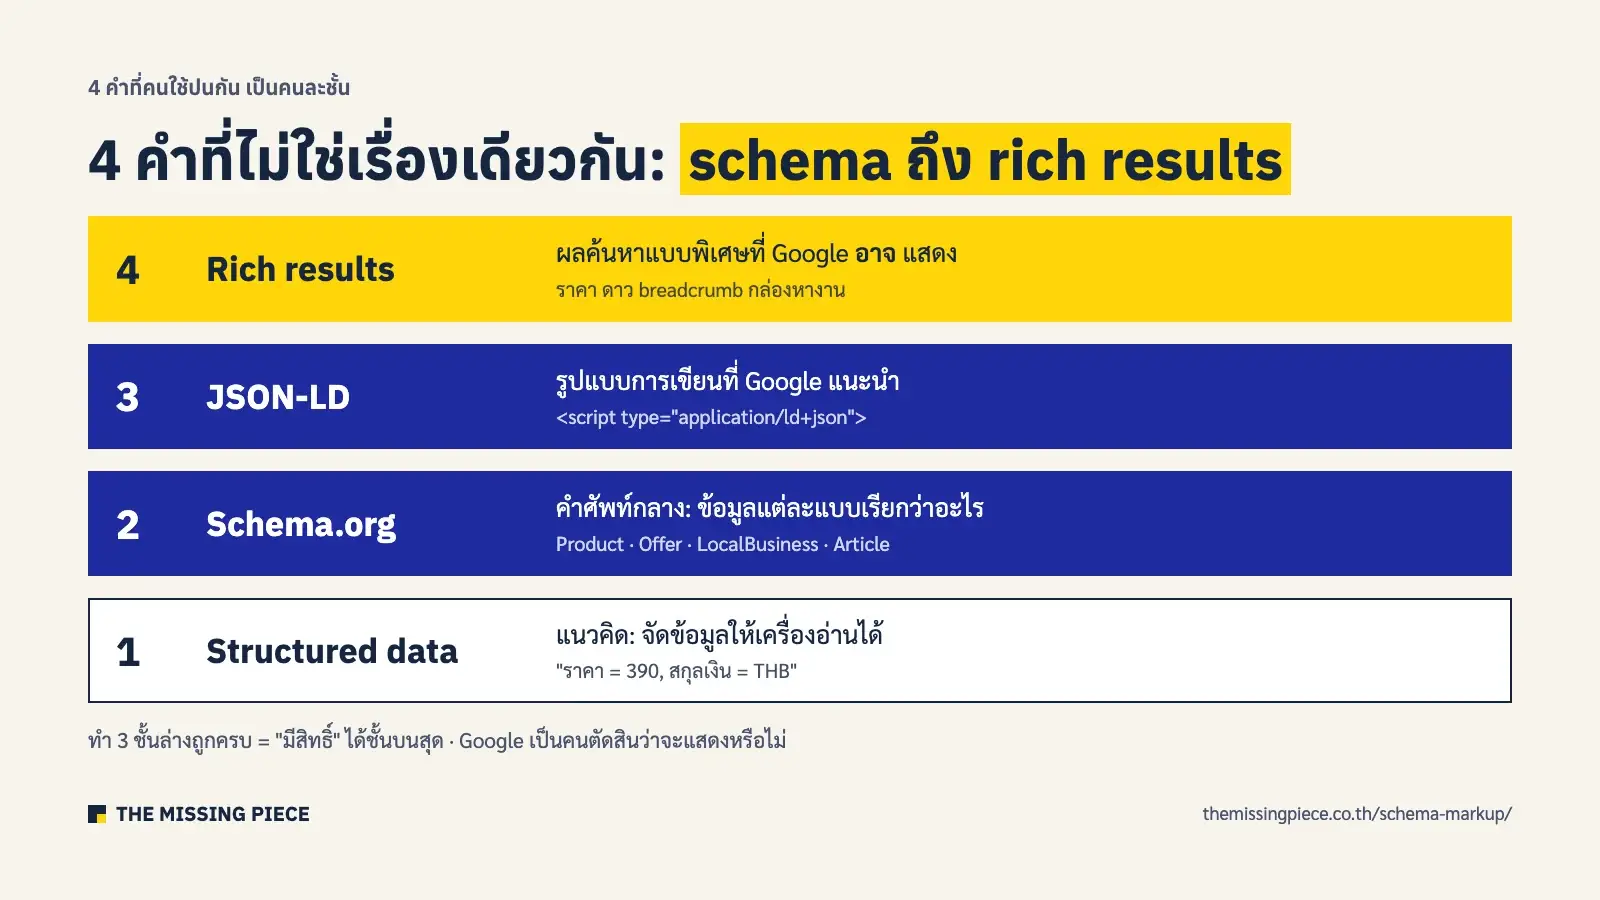
4 คำนี้ถูกใช้แทนกันบ่อย แต่เป็นคนละชั้นกัน structured data คือแนวคิดการจัดข้อมูลให้เครื่องอ่านได้ schema.org คือชุดคำศัพท์ที่ Google, Microsoft, Yahoo และ Yandex ร่วมกันตั้งขึ้น JSON-LD คือรูปแบบการเขียนโค้ดแบบหนึ่ง และ rich results คือผลค้นหาแบบพิเศษที่ Google อาจแสดงเมื่อหน้ามี structured data ครบตามเงื่อนไข
| คำ | คืออะไร | ตัวอย่าง |
|---|---|---|
| Structured data (ข้อมูลมีโครงสร้าง) | แนวคิด: ข้อมูลที่จัดรูปแบบให้เครื่องอ่านเข้าใจได้ | “ราคา = 390, สกุลเงิน = THB” |
| Schema.org | คำศัพท์กลางที่บอกว่าข้อมูลแต่ละแบบเรียกว่าอะไร มีช่องอะไรบ้าง | Product, Offer, LocalBusiness, Article |
| Schema markup | การเอาคำศัพท์ schema.org ไปใส่ในหน้าเว็บจริง | โค้ดที่บอกว่าหน้านี้คือ Product ราคา 390 บาท |
| JSON-LD / Microdata / RDFa | รูปแบบการเขียน markup · Google แนะนำ JSON-LD | ก้อน <script type=”application/ld+json”> |
| Rich results (rich snippets) | ผลค้นหาแบบพิเศษที่ Google อาจแสดง ไม่การันตี | ราคาใต้ลิงก์, ดาวรีวิว, กล่องหางาน, breadcrumb |
Schema ช่วย SEO ไหม
Schema ไม่ได้ช่วยให้อันดับดีขึ้นโดยตรง John Mueller จาก Google ตอบตรงๆ เมื่อ เม.ย. 2025 ว่า structured data ไม่ทำให้เว็บติดอันดับดีขึ้น และ แนวทาง structured data ของ Google (อัปเดต 10 ก.ค. 2026) ระบุว่าแม้ markup ถูกต้องครบ Google ก็ไม่รับประกันว่าจะแสดง rich result สิ่งที่ schema ช่วยได้จริงคือทำให้ Google เข้าใจหน้าและตัวตนของธุรกิจชัดขึ้น และทำให้หน้ามีสิทธิ์ได้ rich results ซึ่งอาจเพิ่มการคลิก
หลักฐานเรื่องการคลิกยังมีน้อยและเก่า การทดสอบแบบแบ่งกลุ่มของ SearchPilot (ก.พ. 2021) พบว่าการใส่ schema รีวิวในหน้าสินค้าอีคอมเมิร์ซเพิ่ม traffic ได้ราว 20% แต่การใส่ราคาคู่กับรีวิวให้ผลไม่ชัด ส่วนการทดสอบ Article schema ของ SearchPilot (ก.ย. 2023) ไม่เห็นความต่าง ส่วนตัวเลขที่ Google ยกเป็นกรณีศึกษาในเอกสาร เช่น Rotten Tomatoes ที่มี CTR สูงกว่า 25% ในหน้าที่มี structured data (100,000 หน้า) เป็นเคสที่ Google ไม่ได้ระบุปี และเก่ากว่าหน้าผลค้นหาตอนนี้มาก
ที่หน้าไทยหลายหน้าเขียนว่า schema ช่วยให้ Google crawl หรือ index เร็วขึ้น หรือช่วยให้ได้ featured snippet ไม่มีเอกสารของ Google รองรับ featured snippet ไม่ต้องใช้ structured data
| Schema ช่วยได้ | Schema ไม่ได้ช่วย |
|---|---|
| ทำให้หน้ามีสิทธิ์ได้ rich results เช่น ราคา ดาวรีวิว breadcrumb กล่องหางาน | ไม่ทำให้อันดับดีขึ้นโดยตรง |
| ช่วยให้ Google เข้าใจว่าหน้านี้คืออะไร และธุรกิจคือใคร (ชื่อ ที่อยู่ โลโก้ โปรไฟล์โซเชียล) | ไม่รับประกันว่าจะได้ rich result แม้โค้ดถูก 100% |
| เชื่อมข้อมูลบทความ ผู้เขียน และองค์กรเข้าด้วยกัน | ไม่ทำให้ crawl หรือ index เร็วขึ้น |
| ใช้ข้อมูลเดียวกับที่ Google ใช้ในฟีเจอร์เฉพาะทาง เช่น ร้านค้า งาน | ไม่ใช่เงื่อนไขของ featured snippet หรือ AI Overviews |
Rich results ปี 2026 เหลือแบบไหน และอะไรที่ Google เลิกแสดงแล้ว
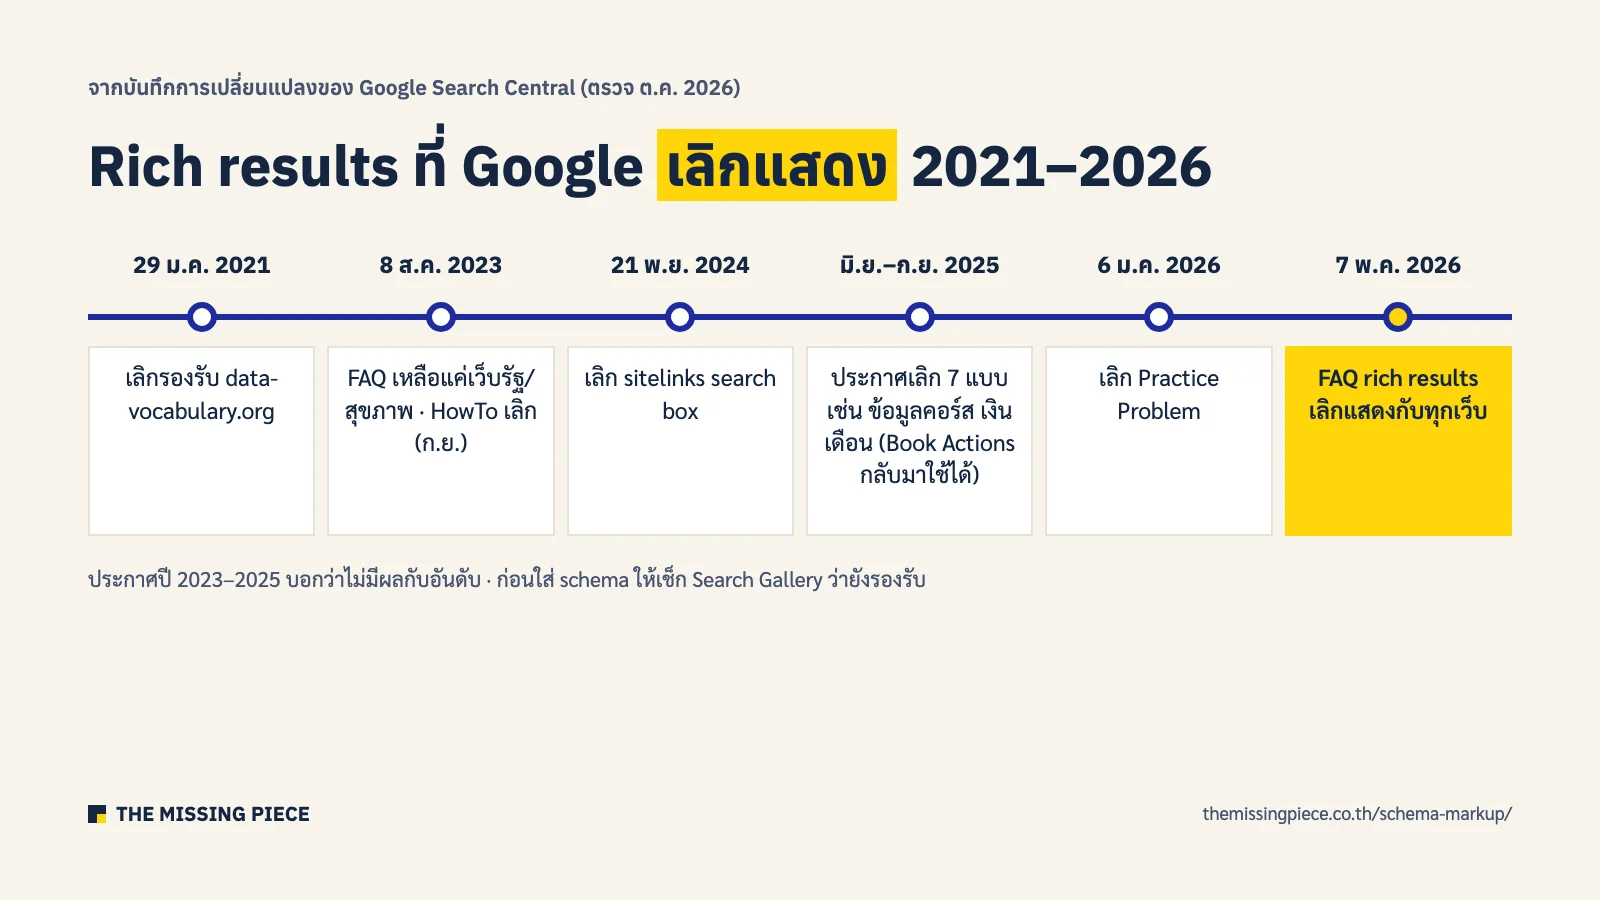
ปี 2026 Google ยังรองรับ rich results ราว 30 แบบตาม Search Gallery (อัปเดต 15 มิ.ย. 2026) เช่น สินค้า รีวิว breadcrumb ร้านค้า งาน อีเวนต์ สูตรอาหาร และวิดีโอ แต่ในช่วงปี 2021–2026 Google เลิกแสดงไปหลายแบบ ในประกาศปี 2023–2025 Google ให้เหตุผลว่าคนใช้น้อยและอยากให้หน้าผลค้นหาเรียบง่ายขึ้น และบอกว่าไม่มีผลกับอันดับ
| เมื่อไร | Google เลิกอะไร |
|---|---|
| 29 ม.ค. 2021 | เลิกรองรับ markup แบบ data-vocabulary.org (เลื่อนจากแผนเดิม เม.ย. 2020) ให้ใช้ schema.org แทน |
| ส.ค.–ก.ย. 2023 | 8 ส.ค. 2023 จำกัด FAQ rich results ให้เว็บรัฐและเว็บสุขภาพที่น่าเชื่อถือ · เลิก HowTo (นำเอกสารออก 14 ก.ย. 2023) |
| 21 พ.ย. 2024 | เลิกแสดงช่องค้นหาในผลค้นหา (sitelinks search box) |
| มิ.ย.–ก.ย. 2025 | ประกาศทยอยเลิก 7 แบบ เช่น ข้อมูลคอร์ส, เงินเดือนโดยประมาณ, Learning Video, Special Announcement, Vehicle Listing (นำเอกสารออก 9 ก.ย. 2025) · Claim Review กำลังทยอยเลิก · ภายหลัง Google ยกเลิกแผนเลิก Book Actions (พ.ย. 2025) |
| 6 ม.ค. 2026 | เลิก Practice Problem |
| 7 พ.ค. 2026 | เลิกแสดง FAQ rich results กับทุกเว็บ (ประกาศ 8 พ.ค. นำเอกสารออก 15 มิ.ย. 2026) · Google ประกาศว่าจะเลิกรายงาน FAQ ใน Search Console และ Rich Results Test ตามมา |
เราเช็กผลค้นหา Google ไทยบนเดสก์ท็อป 46 คำค้นใน 12 กลุ่ม เช่น สูตรอาหาร รีวิวสินค้า ร้านใกล้ฉัน อีเวนต์ หางาน และคอร์ส (6 ต.ค. 2026) เพื่อดูว่าอะไรยังขึ้นจริง ผลคือ AI Overview (คำตอบสรุปจาก AI ด้านบนผลค้นหา) ขึ้นใน 39 คำ (85%) กล่องหางาน (Google for Jobs) ขึ้นครบทั้ง 4 คำหางาน และ local pack (กล่องแผนที่รายชื่อร้าน) ขึ้น 4 จาก 5 คำค้นร้านค้า แต่ไม่เจอกล่องสูตรอาหาร กล่องอีเวนต์ FAQ หรือ featured snippet (กล่องคำตอบบนสุด) เลยสักครั้ง ส่วนดาวรีวิวขึ้นแค่ 6 จาก 117 ผลลัพธ์ที่ตรวจละเอียด (15 คำค้น) และเป็นหน้าเว็บขายของรวมหลายร้าน (marketplace) กับเว็บจองโรงแรมทั้งหมด ไม่มีบทความไหนได้ดาว
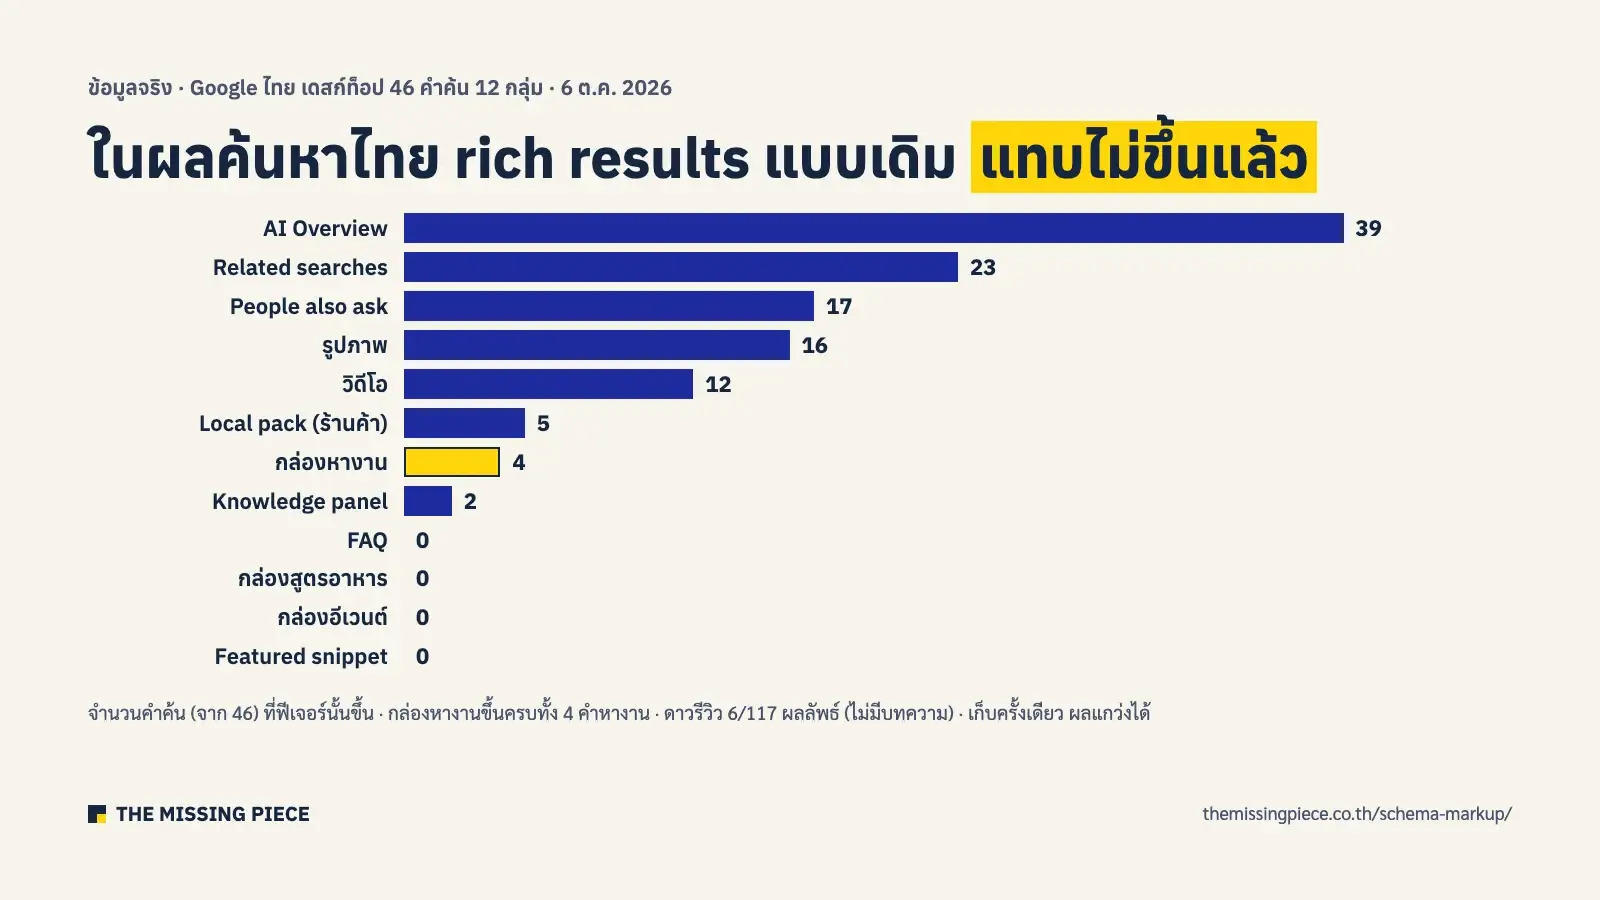
วิธีเก็บ: ผลค้นหา Google ประเทศไทย ภาษาไทย เดสก์ท็อป 10 อันดับแรก เก็บครั้งเดียว 6 ต.ค. 2026 ผ่าน DataForSEO · ผลค้นหาแกว่งมาก เมื่อเรียกคำเดิมซ้ำห่างกัน 8–12 นาที 10 จาก 15 คำได้ชุดฟีเจอร์ต่างกัน จึงเป็นภาพรวมคร่าวๆ ไม่ใช่สถิติ และยังไม่ได้วัดบนมือถือ
ข้อมูลนี้บอกว่าในไทยตอนนี้ คุณค่าของ schema อยู่ที่การให้ Google เข้าใจหน้าและตัวตนของธุรกิจ และการมีสิทธิ์ได้ฟีเจอร์เฉพาะทาง เช่น ร้านค้า งาน โรงแรม มากกว่าการหวังดาวบนบทความ ดาวของร้านใน local pack มาจากรีวิวใน Google Business Profile ไม่ใช่จาก schema บนเว็บ
FAQ schema ยังควรใส่ไหม
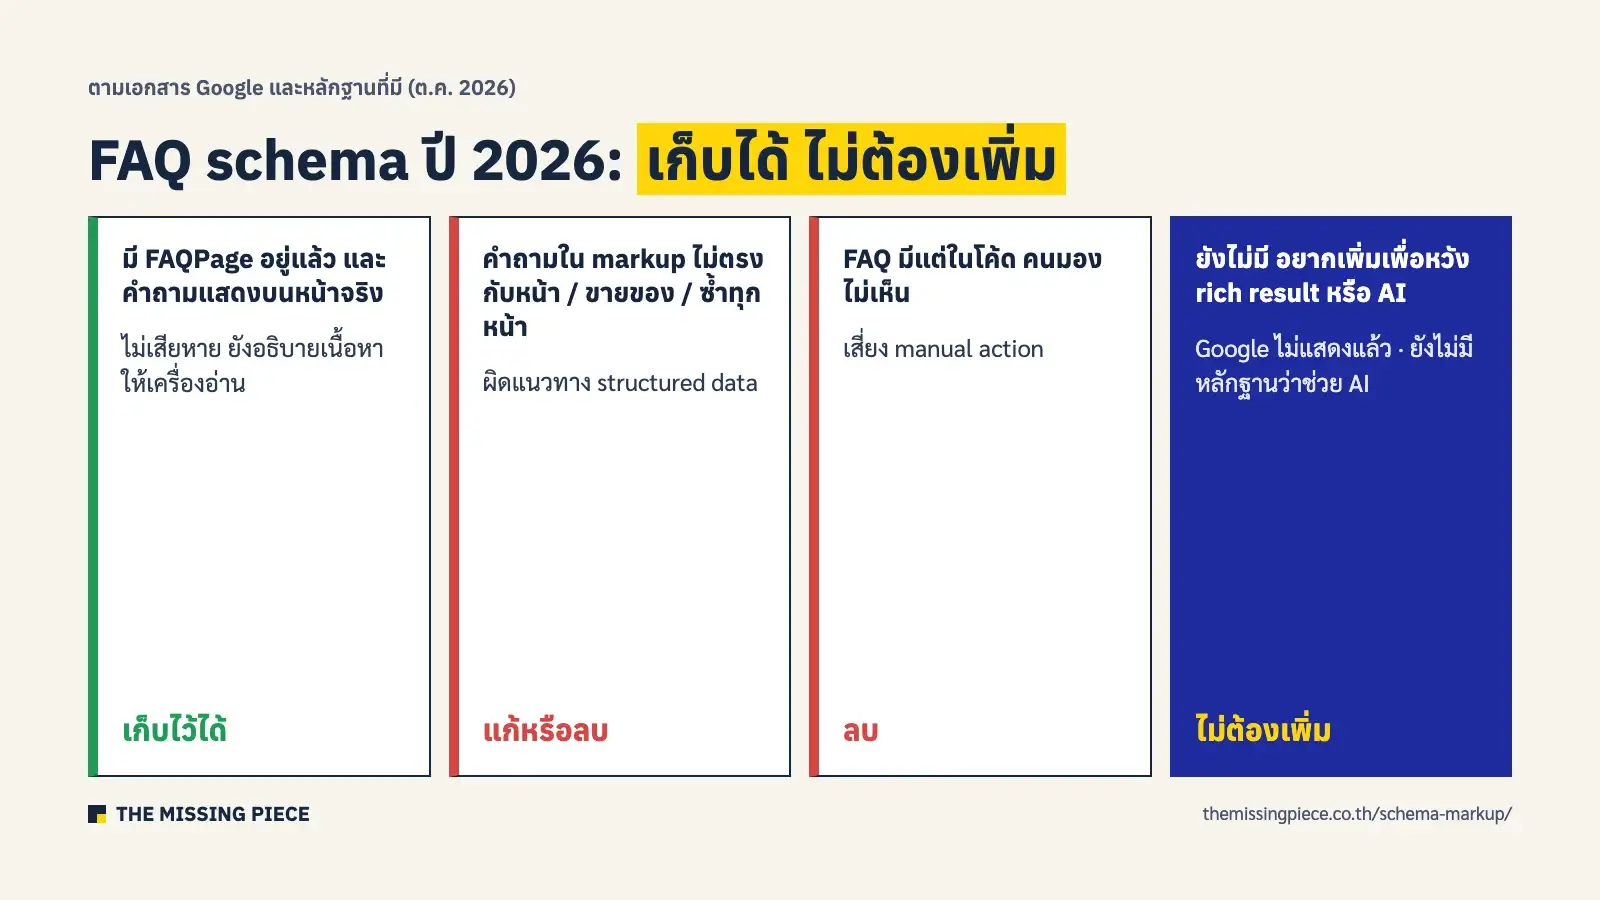
ไม่ต้องใส่ FAQ schema (FAQPage) เพิ่มเพื่อหวัง rich result แล้ว เพราะ Google เลิกแสดง FAQ rich results กับทุกเว็บตั้งแต่ 7 พ.ค. 2026 รวมถึงเว็บรัฐและเว็บสุขภาพที่เคยได้สิทธิ์ แต่ถ้าเว็บมี FAQPage อยู่แล้วก็ไม่ต้องรีบลบ เพราะ markup ที่ Google ไม่ใช้แล้วไม่ทำให้เสียหาย และ FAQPage ยังเป็น type ที่ถูกต้องใน schema.org
FAQ rich result คือคำถามคำตอบที่เคยกางออกใต้ลิงก์ในผลค้นหา Google เปิดตัวฟีเจอร์นี้เมื่อ พ.ค. 2019 พอถึง 8 ส.ค. 2023 ก็จำกัดให้เฉพาะเว็บรัฐและเว็บสุขภาพที่น่าเชื่อถือ แล้ววันที่ 7 พ.ค. 2026 ก็หยุดแสดงทั้งหมด Google ใส่ประกาศในเอกสารเมื่อ 8 พ.ค. 2026 และนำหน้าเอกสาร FAQ ออกเมื่อ 15 มิ.ย. 2026 ตามบันทึกการเปลี่ยนแปลงของ Google Search Central ในประกาศเดียวกัน Google บอกว่าจะเลิกรายงาน FAQ ใน Search Console และใน Rich Results Test ตามมา
| คำถาม | คำตอบ (ตรวจ 7 ต.ค. 2026) | ที่มา |
|---|---|---|
| Google ยังแสดง FAQ rich result ไหม | ไม่แสดงแล้วกับทุกเว็บ ตั้งแต่ 7 พ.ค. 2026 | Google Search Central updates (พ.ค.–มิ.ย. 2026) |
| FAQPage ยังเป็น schema ที่ถูกต้องไหม | ถูกต้อง เป็น type หลักของ schema.org และยังใช้กันบนเว็บ 1–10 ล้านโดเมน | schema.org v30.1 (16 ก.ย. 2026) |
| ใส่ไว้แล้วต้องลบไหม | ไม่ต้อง John Mueller จาก Google บอกเมื่อ 9 พ.ค. 2026 ว่าเว็บส่วนใหญ่ไม่ต้องเปลี่ยนอะไร และถ้าเคยใส่ไว้เพื่อ Search อย่างเดียวจะลบก็ได้ | Search Engine Roundtable (11 พ.ค. 2026) |
| ช่วยอันดับไหม | ไม่ ทั้งตอนที่ยังแสดงและตอนนี้ Google ไม่เคยบอกว่า FAQPage มีผลกับอันดับ | Google, Mueller (เม.ย. 2025) |
| ช่วยให้ AI อ้างอิงไหม | ยังไม่มีหลักฐานว่าช่วย ดูรายละเอียดข้างล่าง | Google, Ahrefs, การทดสอบของเรา |
เรื่อง AI ยังไม่มีหลักฐานว่า FAQPage ช่วยให้ถูกอ้าง คู่มือของ Google เรื่อง generative AI (อัปเดต 10 ก.ค. 2026) จัดเรื่อง “ทุ่มกับ structured data มากเกินไป” ไว้ในรายการสิ่งที่ไม่ต้องทำ โดยบอกว่าไม่จำเป็นสำหรับ AI Search แต่ยังควรใช้เพื่อสิทธิ์ rich results งานศึกษาของ Ahrefs (พ.ค. 2026) ที่เทียบหน้าที่เพิ่ม JSON-LD กับหน้าที่ไม่ได้เพิ่ม ก็ไม่พบว่าถูก AI อ้างมากขึ้น และใน AI Overviews ลดลงเล็กน้อยด้วย (ศึกษาเฉพาะหน้าที่ถูก AI Overviews อ้างอยู่แล้ว) แต่งานนี้รวม schema ทุกแบบ ไม่ได้แยกดู FAQPage
ในการทดสอบ AI Citation ครั้งแรกของเรา (ต.ค. 2026) หน้าที่ AI อ้าง 224 หน้ามี FAQPage 22% และสัดส่วนไม่ต่างกันระหว่างหน้าที่ Perplexity อ้างในเนื้อคำตอบกับหน้าที่แค่อยู่ในรายการ (26% กับ 29%) ตัวแปรที่ต่างชัดคือตาราง HTML บนหน้า (52% กับ 30%) ผลนี้เป็นกลุ่มตัวอย่างเล็กและเป็นความสัมพันธ์ ไม่ใช่เหตุและผล แต่ไปทางเดียวกับ Google คือ AI หยิบจากข้อความที่เห็นบนหน้ามากกว่าจากโค้ด
ฝั่ง Microsoft แนะนำในบล็อกเมื่อ ต.ค. 2025 ว่า schema ช่วยให้ระบบ AI เข้าใจเนื้อหา และคู่คำถามคำตอบถูกหยิบไปใช้ได้ง่าย แต่เป็นคำแนะนำ ไม่ใช่ข้อมูลผลลัพธ์ และเรายังไม่พบเอกสารที่ยืนยันว่า Bing ยังแสดง FAQ rich result ในปี 2026
สรุปเป็นกรณี:
- มี FAQPage อยู่แล้ว และคำถามแสดงบนหน้าจริง: เก็บไว้ได้ ไม่เสียหาย และยังเป็นการอธิบายเนื้อหาให้เครื่องอ่านเข้าใจ ถ้าอยากลบเพื่อให้โค้ดสะอาดก็ลบได้ ไม่กระทบอันดับ
- คำถามใน markup ไม่ตรงกับบนหน้า เป็นคำถามขายของ หรือปลั๊กอินใส่ FAQ ซ้ำทุกหน้า: แก้หรือลบ เพราะผิดแนวทาง structured data ของ Google
- FAQ ที่มีแต่ในโค้ด ไม่แสดงให้คนเห็น: ลบ เป็นการ markup ข้อมูลที่ผู้ใช้มองไม่เห็น เสี่ยง manual action
- จะเพิ่ม FAQPage เพื่อหวัง rich result หรือหวังให้ AI อ้าง: ไม่ต้องทำ ยังไม่มีหลักฐานว่าได้ผลทั้งสองทาง
- จะทำส่วนคำถามที่พบบ่อยให้คนอ่าน: ทำได้และยังมีประโยชน์ ตอบคำถามที่คนถามจริงในประโยคแรก ข้อความที่เห็นบนหน้าคือสิ่งที่ AI ดึงไปใช้
- เวลาที่มีจำกัด: ใช้กับ schema ที่ Google ยังแสดง เช่น Product, LocalBusiness, BreadcrumbList, Article และ JobPosting ดีกว่า
AI SEO For Dummies บทที่ 11 ก็ให้ใช้ FAQPage เฉพาะเมื่อคำถามคำตอบแสดงบนหน้าและตรงกัน ส่วนบทที่ 12 ที่แนะนำ FAQPage เพื่อเพิ่มการมองเห็นในผลค้นหาและ AI เขียนก่อนที่ Google จะเลิกแสดง FAQ ทั้งหมด จึงใช้บทนั้นเป็นแนวทางเขียนส่วนคำถามได้ แต่ไม่ใช่เหตุผลให้เพิ่ม markup
เว็บไทยที่ติดหน้าแรกใช้ schema อะไร (ผลสำรวจ 236 หน้า)
เกือบ 4 ใน 10 หน้าไทยที่ติดหน้าแรกไม่มี structured data เลย เราตรวจโค้ดของหน้าไทยที่ติด 10 อันดับแรกบน Google เดสก์ท็อป 236 หน้า จาก 43 คำค้นทั้งคำธุรกิจและคำ SEO (7 ต.ค. 2026 ชุดเดียวกับการสำรวจ title ในบทความ On-Page SEO) พบว่า 58% มี JSON-LD อีก 5% ใช้ Microdata อย่างเดียว และ 37% ไม่มี structured data แบบไหนเลย
Type ที่เจอบ่อยเป็น type พื้นฐานที่ปลั๊กอิน SEO ใส่ให้อัตโนมัติ ส่วน type ที่ทำให้ธุรกิจมีสิทธิ์ได้ rich results เจอน้อยมาก
| สิ่งที่พบ | จำนวนหน้า (จาก 236) |
|---|---|
| มี JSON-LD ที่อ่านได้ | 137 (58%) |
| ไม่มี structured data เลย | 87 (37%) |
| ใช้ Microdata (บางส่วนหรือทั้งหมด) | 43 (18%) |
| Organization (รวม Corporation และ LocalBusiness) | 90 (38%) |
| BreadcrumbList | 79 (33%) |
| Article / BlogPosting / NewsArticle | 66 (28%) |
| Person | 62 (26%) |
| SearchAction ของ sitelinks search box (เลิกแสดงตั้งแต่ พ.ย. 2024) | 43 (18%) |
| FAQPage (เลิกแสดงตั้งแต่ พ.ค. 2026) | 21 (9%) |
| HowTo | 0 |
| Product | 10 (4%) |
| LocalBusiness | 8 (3%) |
| ดาวรีวิว (AggregateRating / Review) | 3 (1%) |
| JSON-LD ที่เขียนผิดจนอ่านไม่ได้ | 2 (1%) |
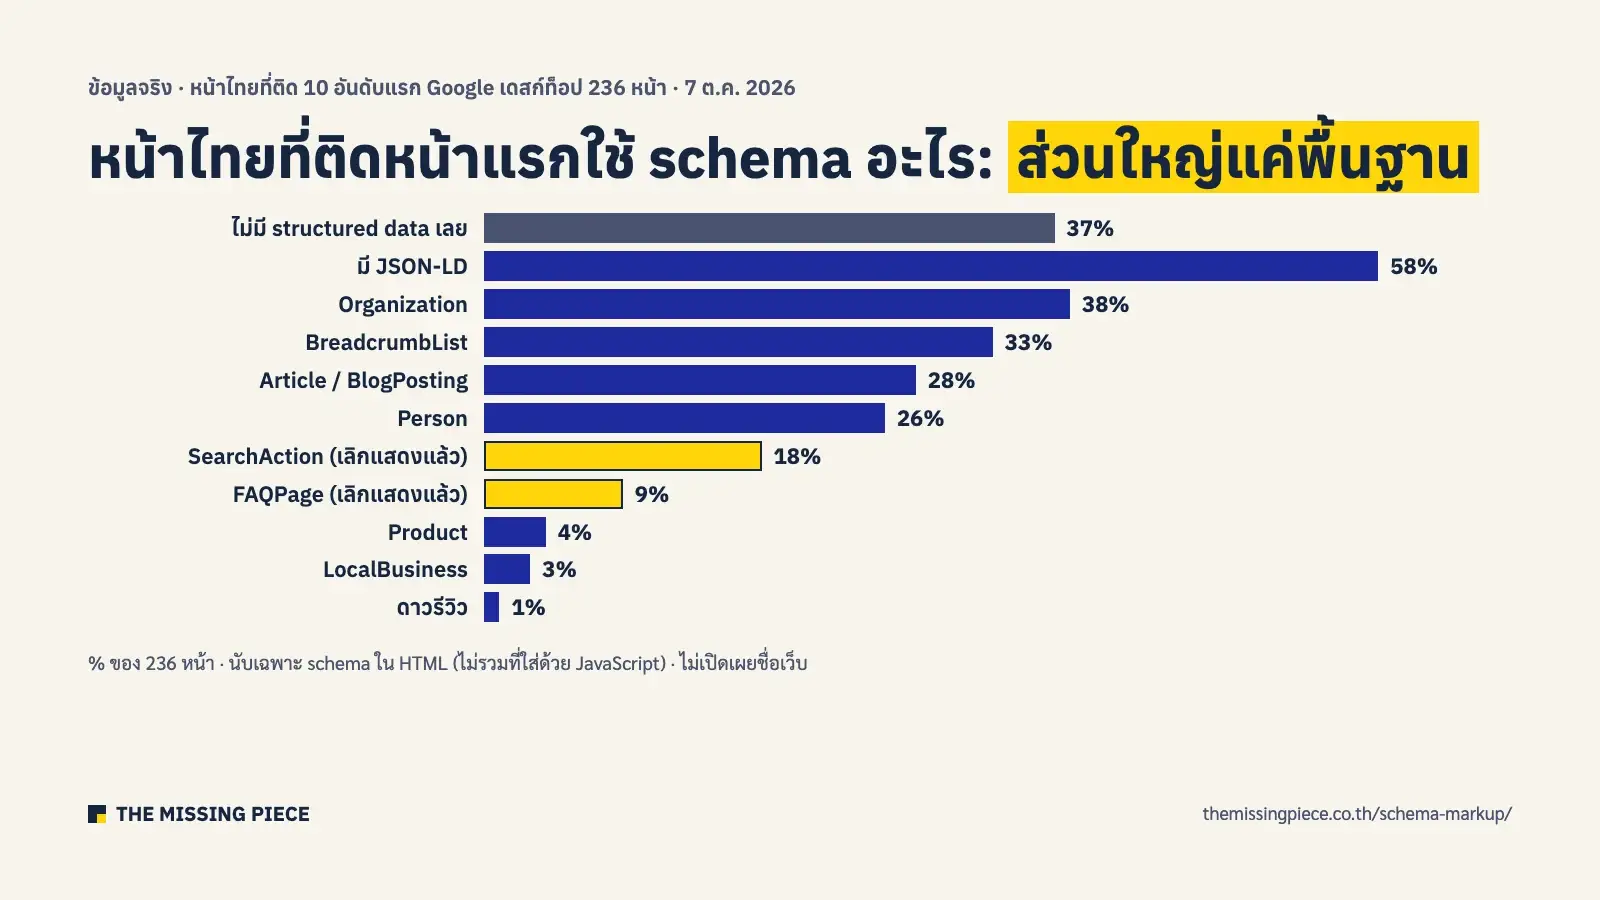
สิ่งที่ข้อมูลนี้บอก: (1) ติดหน้าแรกได้โดยไม่มี schema และหน้าอันดับ 1–3 มี JSON-LD 56% ใกล้กับอันดับ 4–10 ที่ 59% ซึ่งไปทางเดียวกับที่ Google บอกว่า schema ไม่ใช่ปัจจัยจัดอันดับ (2) markup ของฟีเจอร์ที่เลิกแล้วยังค้างอยู่เยอะ ไม่ได้เสียหายอะไร แต่ก็ไม่ได้ประโยชน์ (3) ช่องว่างจริงอยู่ที่ type เฉพาะธุรกิจ เช่น สินค้าและร้านค้า ซึ่งเป็นตัวอย่างในหัวข้อถัดไป
วิธีสำรวจ: ดึง HTML ของแต่ละหน้าครั้งเดียว (7 ต.ค. 2026) ทีละหน้าห่างกัน 2 วินาที นับ JSON-LD, Microdata และ RDFa ที่อยู่ใน HTML · schema ที่ใส่ด้วย JavaScript หรือ Google Tag Manager จะไม่ถูกนับ ตัวเลขจริงจึงอาจสูงกว่านี้เล็กน้อย · ไม่รวมแพลตฟอร์มอย่าง Facebook และ YouTube
JSON-LD คืออะไร + ตัวอย่าง 5 แบบสำหรับธุรกิจไทย
JSON-LD คือการเขียน schema เป็นก้อนโค้ดแยกไว้ในแท็ก <script type="application/ld+json"> ไม่ต้องแทรกเข้าไปใน HTML ที่คนเห็นแบบ Microdata หรือ RDFa Google รองรับทั้ง 3 แบบ แต่แนะนำ JSON-LD เพราะเพิ่มและแก้ได้ง่ายที่สุดเมื่อเว็บมีหลายหน้า ตามเอกสาร Introduction to structured data (ธ.ค. 2025) The Art of SEO บทที่ 7 ก็แนะนำ JSON-LD และให้เริ่มทีละ type แล้วตรวจผลก่อนขยายทั้งเว็บ
ตัวอย่างข้างล่างเป็นร้านกาแฟสมมุติ ใช้ข้อมูลแบบไทย คือที่อยู่ไทย เบอร์ +66 และราคาเป็นบาท ทุกตัวอย่างผ่าน Rich Results Test ของ Google แล้ว ไม่มี error (ตรวจ 7 ต.ค. 2026) ส่วนที่ขึ้นเป็นคำเตือน (non-critical) คือช่องเสริมที่ไม่ได้ใส่ เช่น รีวิว เวลาใช้จริงให้เปลี่ยนข้อมูลเป็นของคุณ และใส่เฉพาะข้อมูลที่แสดงบนหน้านั้นจริง
1. บทความ (BlogPosting)
ใช้กับหน้าบทความ บอกชื่อเรื่อง วันที่เผยแพร่และแก้ไข ผู้เขียน และผู้เผยแพร่ ปลั๊กอิน SEO ส่วนใหญ่สร้างส่วนนี้ให้อัตโนมัติ
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "วิธีเลือกเมล็ดกาแฟคั่วกลางสำหรับดริป",
  "datePublished": "2026-10-01T09:00:00+07:00",
  "dateModified": "2026-10-05T14:30:00+07:00",
  "inLanguage": "th",
  "image": "https://www.example.co.th/images/medium-roast.webp",
  "author": {
    "@type": "Person",
    "name": "สมชาย ใจดี",
    "url": "https://www.example.co.th/about/somchai/"
  },
  "publisher": {
    "@type": "Organization",
    "name": "ร้านกาแฟตัวอย่าง",
    "logo": {
      "@type": "ImageObject",
      "url": "https://www.example.co.th/images/logo.png"
    }
  }
}
</script>
2. องค์กร (Organization)
ใช้ที่หน้าแรกหรือหน้าเกี่ยวกับเรา บอกชื่อบริษัท โลโก้ ช่องทางติดต่อ และโปรไฟล์โซเชียลใน sameAs ข้อมูลชุดนี้ควรตรงกับชื่อและข้อมูลบริษัทในทุกที่ที่แบรนด์ปรากฏ AI SEO For Dummies บทที่ 13 เรียกเรื่องนี้ว่าการทำให้ข้อมูลตัวตนตรงกันทุกที่ (entity alignment) ขั้นตอนทำทั้งบนเว็บและโปรไฟล์ภายนอกอยู่ใน Entity SEO คืออะไร
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://www.example.co.th/#organization",
  "name": "บริษัท ตัวอย่าง จำกัด",
  "alternateName": "Example Co.",
  "url": "https://www.example.co.th/",
  "logo": "https://www.example.co.th/images/logo.png",
  "email": "hello@example.co.th",
  "telephone": "+66-2-123-4567",
  "sameAs": [
    "https://www.facebook.com/examplecoth",
    "https://www.linkedin.com/company/examplecoth"
  ]
}
</script>
3. ร้านค้า (LocalBusiness)
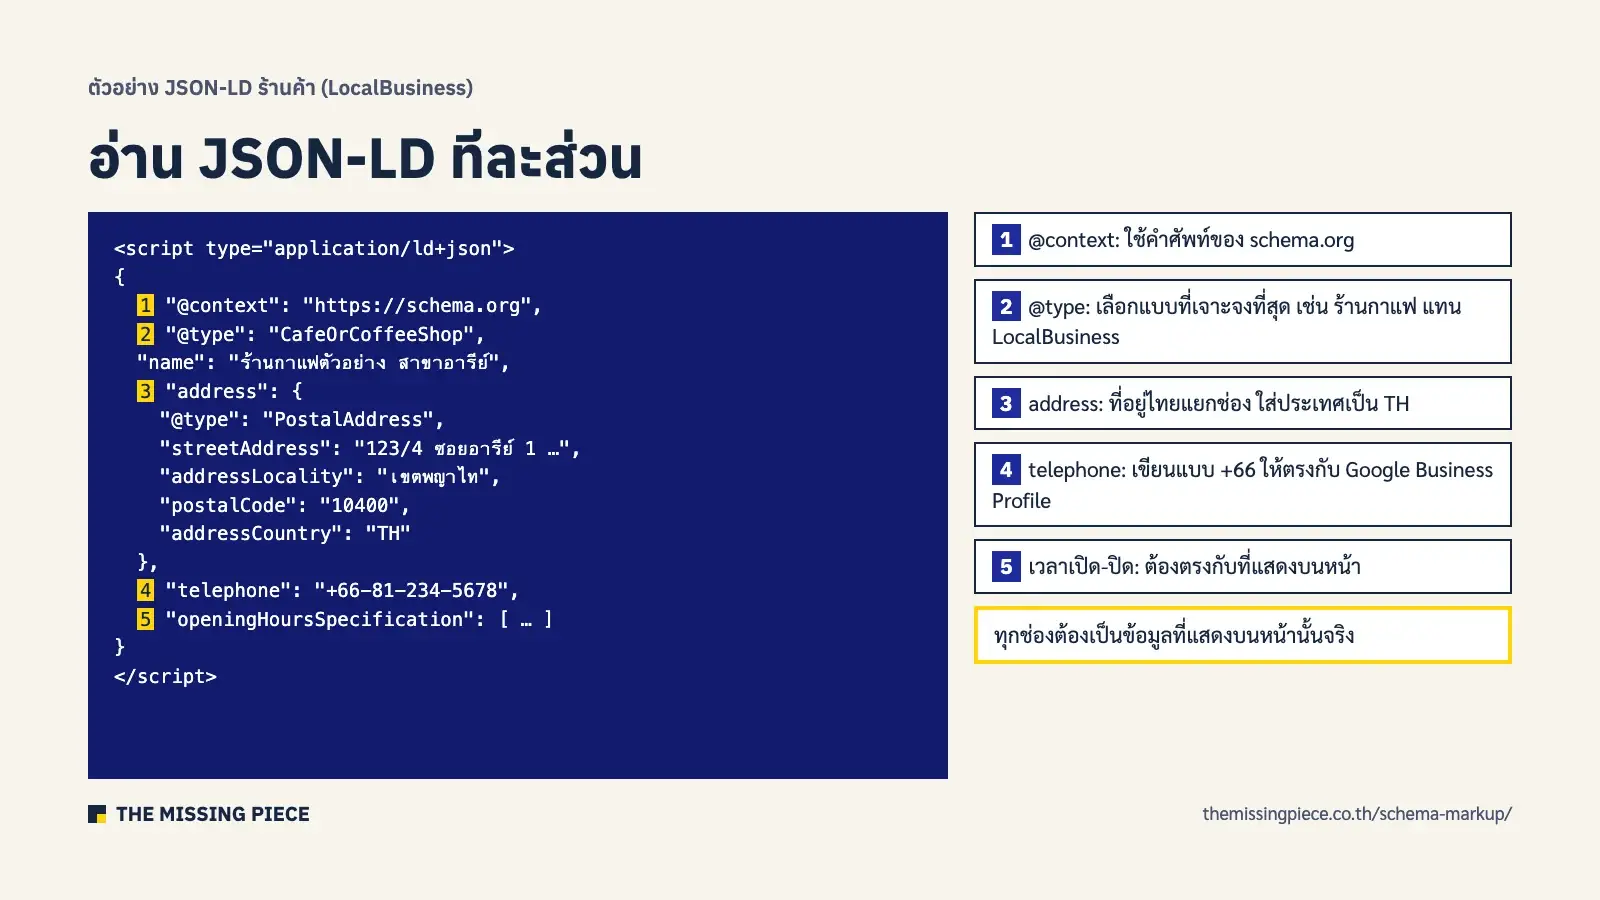
ใช้กับหน้าสาขาหรือหน้าติดต่อของธุรกิจที่มีหน้าร้าน เลือก type ที่เจาะจงที่สุด เช่น CafeOrCoffeeShop, Restaurant, Dentist แทน LocalBusiness กว้างๆ ตามที่ Google แนะนำ ที่อยู่ เบอร์โทร และเวลาเปิดควรตรงกับ Google Business Profile ของร้าน (วิธีดูแลโปรไฟล์ร้านอยู่ใน Local SEO คืออะไร)
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "CafeOrCoffeeShop",
  "name": "ร้านกาแฟตัวอย่าง สาขาอารีย์",
  "url": "https://www.example.co.th/branches/ari/",
  "image": "https://www.example.co.th/images/ari-front.webp",
  "telephone": "+66-81-234-5678",
  "priceRange": "฿฿",
  "address": {
    "@type": "PostalAddress",
    "streetAddress": "123/4 ซอยอารีย์ 1 ถนนพหลโยธิน แขวงพญาไท",
    "addressLocality": "เขตพญาไท",
    "addressRegion": "กรุงเทพมหานคร",
    "postalCode": "10400",
    "addressCountry": "TH"
  },
  "geo": {
    "@type": "GeoCoordinates",
    "latitude": 13.7797,
    "longitude": 100.5446
  },
  "openingHoursSpecification": [
    {
      "@type": "OpeningHoursSpecification",
      "dayOfWeek": [
        "Monday",
        "Tuesday",
        "Wednesday",
        "Thursday",
        "Friday"
      ],
      "opens": "07:00",
      "closes": "18:00"
    },
    {
      "@type": "OpeningHoursSpecification",
      "dayOfWeek": [
        "Saturday",
        "Sunday"
      ],
      "opens": "08:00",
      "closes": "17:00"
    }
  ]
}
</script>
4. สินค้า (Product + Offer)
ใช้กับหน้าสินค้า ราคาต้องเป็นราคาที่แสดงบนหน้า และ priceCurrency เป็น THB ถ้าหน้าสินค้ามีรีวิวจากลูกค้าจริงที่แสดงบนหน้า จึงค่อยเพิ่ม aggregateRating ห้ามใส่รีวิวที่ไม่มีบนหน้าหรือรีวิวที่แลกด้วยของแถม ตามแนวทางรีวิวที่ Google ปรับเมื่อ ก.ค. 2026
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Product",
  "name": "เมล็ดกาแฟคั่วกลาง ดอยช้าง 250 กรัม",
  "image": "https://www.example.co.th/images/doi-chang-250.webp",
  "description": "เมล็ดกาแฟอาราบิก้าจากดอยช้าง จังหวัดเชียงราย คั่วระดับกลาง",
  "sku": "DC-250-M",
  "brand": {
    "@type": "Brand",
    "name": "ร้านกาแฟตัวอย่าง"
  },
  "offers": {
    "@type": "Offer",
    "url": "https://www.example.co.th/shop/doi-chang-250/",
    "price": "390.00",
    "priceCurrency": "THB",
    "availability": "https://schema.org/InStock",
    "itemCondition": "https://schema.org/NewCondition"
  }
}
</script>
5. เส้นทางหน้า (BreadcrumbList)
บอกว่าหน้านี้อยู่ตรงไหนในโครงสร้างเว็บ Google อาจแสดงเป็นเส้นทางแทน URL ใต้ชื่อหน้า ลำดับต้องตรงกับ breadcrumb ที่แสดงบนหน้า และรายการสุดท้าย (หน้าปัจจุบัน) ไม่ต้องใส่ item
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BreadcrumbList",
  "itemListElement": [
    {
      "@type": "ListItem",
      "position": 1,
      "name": "หน้าแรก",
      "item": "https://www.example.co.th/"
    },
    {
      "@type": "ListItem",
      "position": 2,
      "name": "เมล็ดกาแฟ",
      "item": "https://www.example.co.th/shop/beans/"
    },
    {
      "@type": "ListItem",
      "position": 3,
      "name": "เมล็ดกาแฟคั่วกลาง ดอยช้าง 250 กรัม"
    }
  ]
}
</script>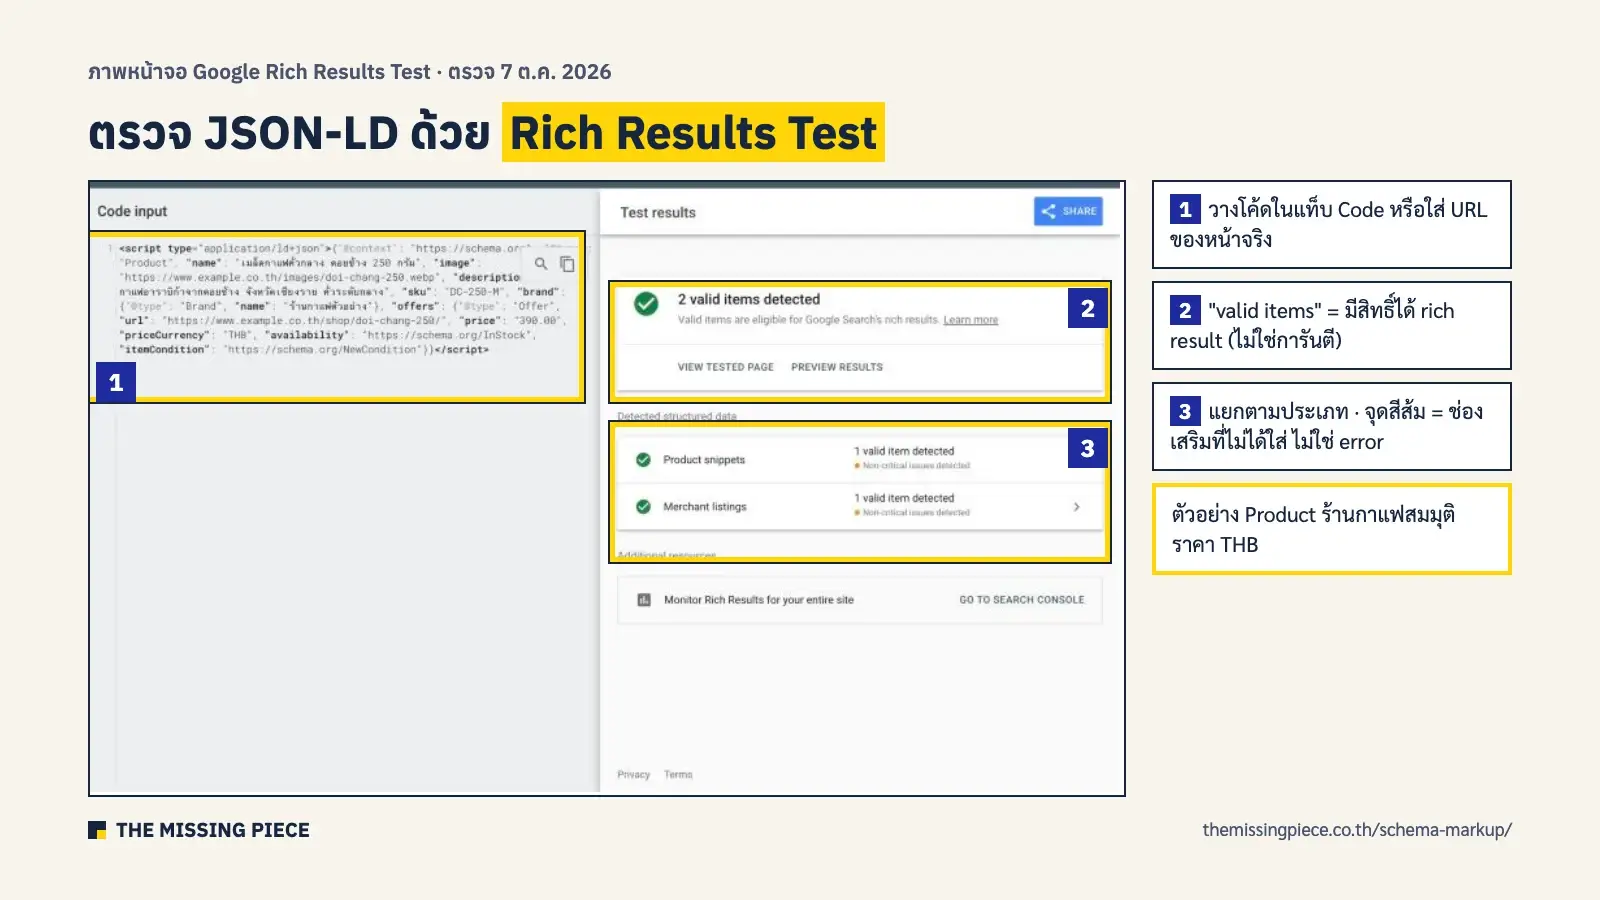
ความเห็นของผม (ไอซ์): ในมุมมองผม schema ควรใส่ให้ละเอียดเท่าที่ละเอียดได้ เพราะเหมือนเราให้ข้อมูลกับ AI พอคนมาค้นหาแล้วเจอเราในมิติต่างๆ AI ก็สามารถดึงข้อมูลของเราไปใช้ได้
ใส่ให้ละเอียดได้ แต่ต้องอยู่ในกรอบเดียว คือข้อมูลทุกช่องใน schema ต้องตรงกับสิ่งที่แสดงบนหน้านั้นจริง แนวทาง structured data ของ Google ห้าม markup ข้อมูลที่ผู้ใช้มองไม่เห็นบนหน้า หรือข้อมูลที่ไม่ตรงกับเนื้อหา ถ้าละเมิด Google อาจลงโทษแบบ manual action (ทีมงาน Google ตรวจแล้วลงโทษเอง) ซึ่งทำให้หน้าหมดสิทธิ์ได้ rich results ดังนั้นถ้าอยากใส่ข้อมูลเพิ่มใน schema ให้เพิ่มข้อมูลนั้นบนหน้าเว็บก่อน เช่น ใส่เวลาเปิดร้านทั้งในหน้าเว็บและใน schema และ Google เองแนะนำว่าใส่ช่องน้อยแต่ครบและถูกต้อง ดีกว่าใส่ทุกช่องแต่ข้อมูลไม่ครบ (Introduction to structured data, ธ.ค. 2025) ส่วนผลต่อการถูก AI อ้างยังไม่มีหลักฐานเชิงข้อมูล ดูหัวข้อ FAQ schema ยังควรใส่ไหม
วิธีใส่ Schema ในเว็บ (WordPress, เว็บสำเร็จรูป, เขียนเอง)
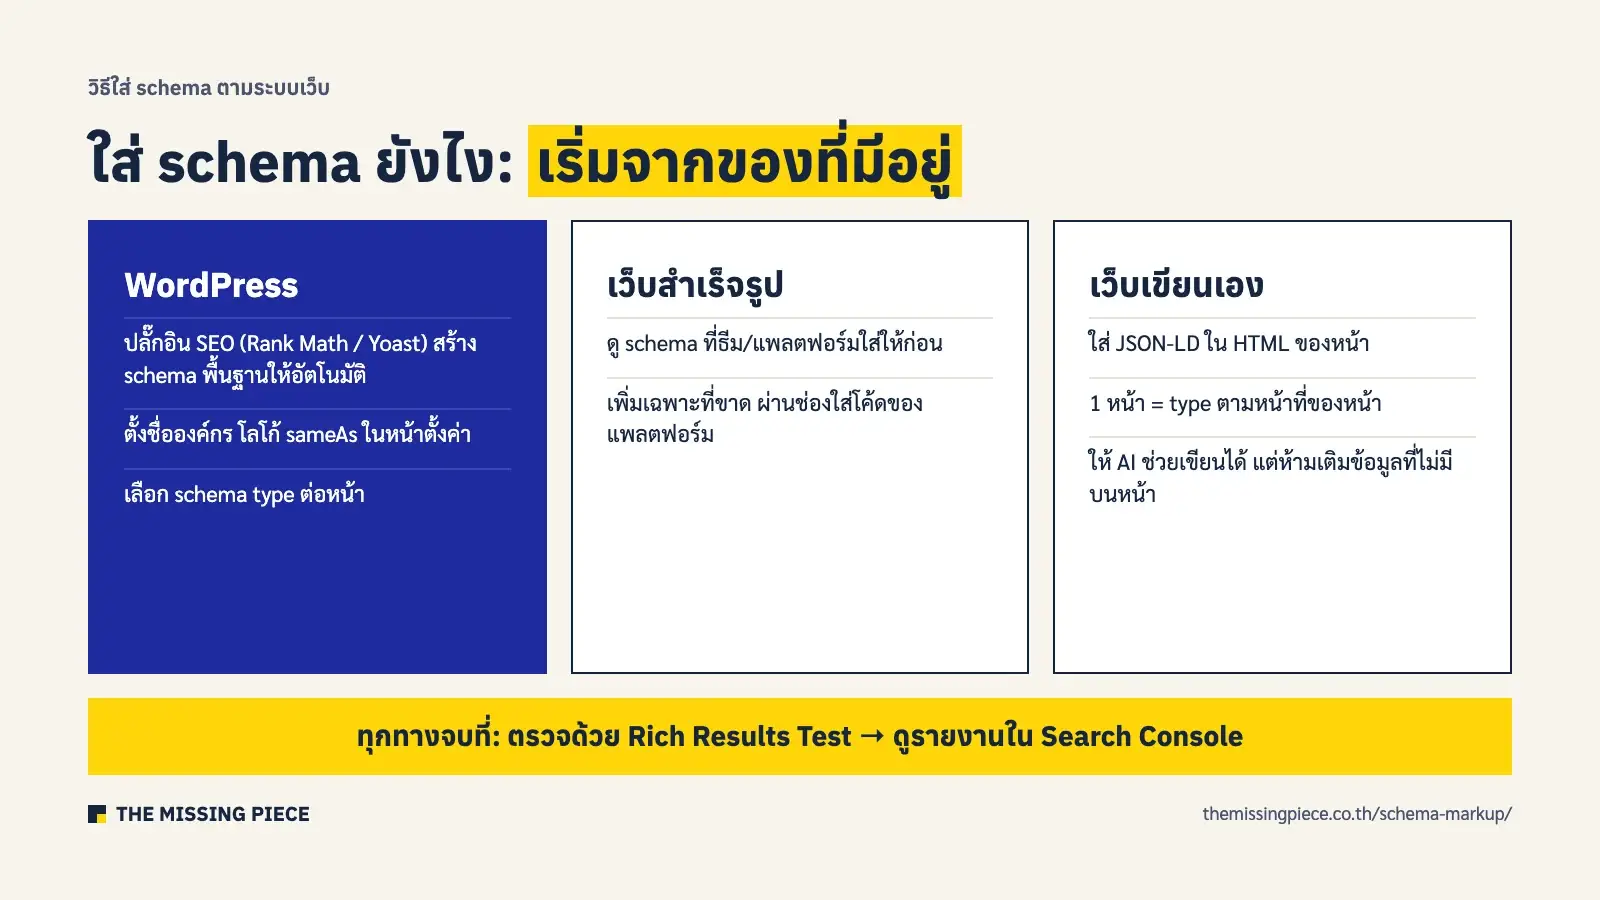
WordPress ใช้ปลั๊กอิน SEO อย่าง Rank Math หรือ Yoast ที่สร้าง schema พื้นฐานให้ทุกหน้าอัตโนมัติ (Organization, WebSite, WebPage, Article, Breadcrumb) เว็บสำเร็จรูปส่วนใหญ่มี schema พื้นฐานในธีม ส่วนเว็บที่เขียนเองให้ใส่ JSON-LD ไว้ใน HTML ของหน้า ในผลสำรวจของเรา หน้าที่มีร่องรอยปลั๊กอินที่พบบ่อยคือ Yoast 38 หน้า และ Rank Math 23 หน้า
ถ้าเพิ่งเริ่มทำ SEO ให้ดูลำดับงานทั้งหมดในเส้นทางเรียน SEO ฟรีทีละขั้น ก่อน schema เป็นงานที่ควรทำหลังจากหน้าเว็บถูก index และเนื้อหาตอบคำถามได้ดีแล้ว
- เช็กของที่มีอยู่ก่อน — เอา URL หน้าหลักๆ ไปใส่ Rich Results Test ดูว่าปลั๊กอินหรือธีมสร้าง schema อะไรไว้แล้ว จะได้ไม่ใส่ซ้ำ
- เลือก type ตามหน้าที่ของหน้า — หน้าแรก = Organization, หน้าสาขา = LocalBusiness, หน้าสินค้า = Product, บทความ = Article, หน้าประกาศงาน = JobPosting
- ตั้งค่าในปลั๊กอินก่อนเขียนเอง — Rank Math และ Yoast ตั้งชื่อองค์กร โลโก้ และ sameAs ได้ในหน้าตั้งค่า และเลือก schema type ต่อหน้าได้ (บางฟีเจอร์อยู่ในรุ่นเสียเงิน)
- เขียนเองเฉพาะที่ปลั๊กอินไม่มี — เช่น LocalBusiness หลายสาขา ใส่เป็น JSON-LD ในหน้านั้น (ธีมหรือปลั๊กอินแทรกโค้ด) และระวังไม่ให้ซ้ำกับของปลั๊กอิน
- ตรวจและติดตาม — ตรวจด้วย Rich Results Test ก่อนขึ้นจริง แล้วดูรายงานใน Search Console หลัง Google เก็บหน้าใหม่ (เมนูที่ต้องเปิดอยู่ใน คู่มือใช้ Google Search Console)
การใส่ JSON-LD ผ่าน Google Tag Manager ทำได้ และ Google อ่านได้หลังเรนเดอร์ JavaScript แต่ใส่ไว้ใน HTML ของหน้าตรงๆ จะชัวร์กว่า เพราะบอตของ AI หลายเจ้า เช่น GPTBot, ClaudeBot และ PerplexityBot ไม่รัน JavaScript ตามข้อมูลของ Vercel (ธ.ค. 2024) และ Google เองเตือนว่า Product markup ที่สร้างด้วย JavaScript อาจทำให้การเก็บข้อมูลสินค้าช้าและไม่สม่ำเสมอ
เลือก schema ตามประเภทธุรกิจ ตารางนี้สรุปว่าธุรกิจแต่ละแบบควรเริ่มจาก type ไหน และ type ไหนยังมีโอกาสได้ rich result ใน Google ตาม Search Gallery (มิ.ย. 2026)
| ธุรกิจ | เริ่มจาก (ทุกเว็บ) | เพิ่มตามธุรกิจ | โอกาสได้ rich result |
|---|---|---|---|
| ร้านค้ามีหน้าร้าน เช่น ร้านอาหาร คลินิก ร้านกาแฟ | Organization, WebSite, BreadcrumbList | LocalBusiness แบบเจาะจง (Restaurant, Dentist, CafeOrCoffeeShop) | ข้อมูลร้านในผลค้นหา · local pack ใช้ข้อมูล Google Business Profile เป็นหลัก |
| ขายของออนไลน์ | Organization, WebSite, BreadcrumbList | Product + Offer (THB), รีวิวจริงที่แสดงบนหน้า | ราคา สถานะสินค้า ดาวรีวิว · Merchant listings |
| บล็อก สื่อ คอนเทนต์ | Organization, WebSite, BreadcrumbList | Article / BlogPosting, Person (ผู้เขียน) | breadcrumb, ข้อมูลบทความ · ไม่ได้ดาวหรือ FAQ |
| รับสมัครงาน | Organization, WebSite | JobPosting | กล่องหางาน (ขึ้นทุกคำหางานในการเช็กของเรา) |
| จัดอีเวนต์ สัมมนา | Organization, WebSite | Event | ยังไม่เปิดในไทย: Google แสดงกล่องอีเวนต์เฉพาะบางประเทศและภาษา ซึ่งยังไม่มีไทย (ตรงกับที่เราเช็กแล้วไม่เจอเลย) |
| สอนคอร์ส | Organization, WebSite | Course (ใช้กับ Course list) | แทบไม่มี: Course list แสดงเฉพาะภาษาอังกฤษ และต้องมีอย่างน้อย 3 คอร์ส · Course info เลิกแสดงแล้วตั้งแต่ ก.ย. 2025 |
ความเห็นของผม (ไอซ์): หลายคนคิดว่า schema เป็นเรื่องยาก แต่ตอนนี้เราให้ AI gen ได้แล้ว แค่ให้ข้อมูลกับ AI แล้วบอกให้มันสร้าง schema ออกมา ก็ได้แล้ว
ตัวอย่าง prompt ที่ใช้ได้กับ ChatGPT, Claude หรือ Gemini:
สร้าง JSON-LD schema.org ประเภท CafeOrCoffeeShop สำหรับหน้าเว็บนี้
ใช้เฉพาะข้อมูลด้านล่าง ห้ามเติมข้อมูลที่ไม่มี ถ้าช่องไหนไม่มีข้อมูลให้ตัดช่องนั้นออก
- ชื่อร้าน: ...
- ที่อยู่: ... (เขต จังหวัด รหัสไปรษณีย์)
- เบอร์โทร: ... (เขียนแบบ +66)
- เวลาเปิด-ปิด: ...
- URL หน้าเว็บ: ...
- รูปหน้าร้าน (URL): ...
ใส่ addressCountry เป็น TH และตอบเป็นโค้ดอย่างเดียวในแท็ก script type="application/ld+json"
AI เขียน schema ได้เร็ว แต่ผิดได้ เช่น ใส่ช่องที่ schema.org ไม่มี ใส่ type ที่ Google ไม่รองรับแล้ว หรือเติมข้อมูลที่ไม่ได้ให้ไป เช่น คะแนนรีวิวที่ไม่มีจริง ดังนั้นตรวจโค้ดจาก AI ด้วย Rich Results Test และ Schema Markup Validator ทุกครั้ง และเทียบทุกช่องกับข้อมูลบนหน้าก่อนเอาขึ้นเว็บ
ตัวอย่างจริง: schema ของหน้าเว็บเรา
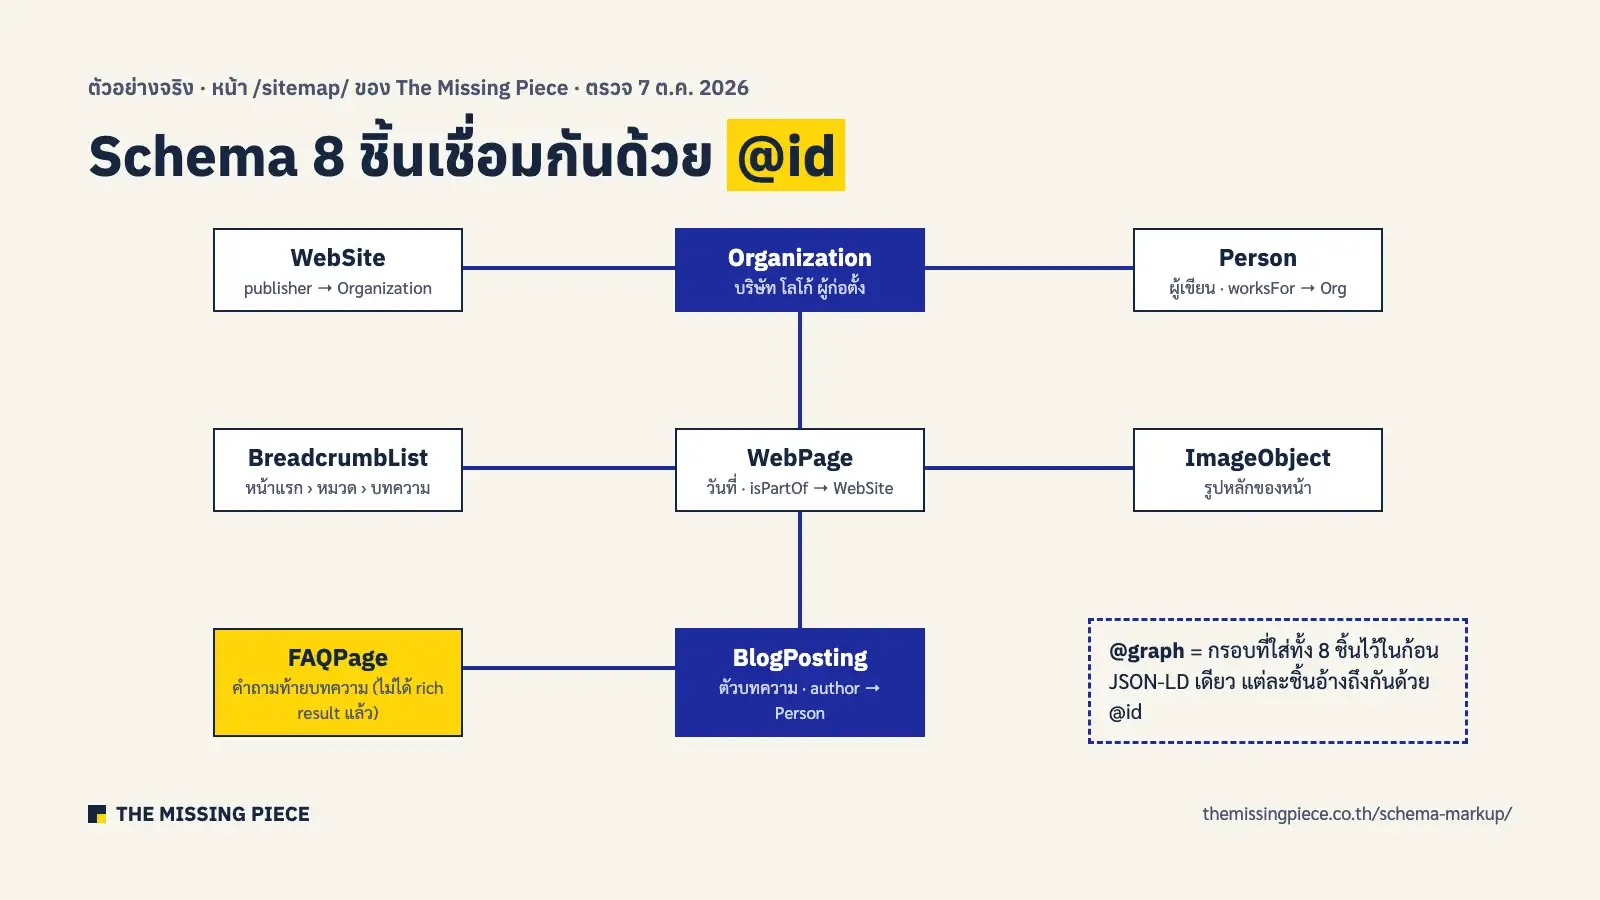
หน้า Sitemap คืออะไร ของ The Missing Piece มี schema 8 ชิ้นอยู่ในก้อน JSON-LD เดียวที่เรียกว่า @graph แต่ละชิ้นมีรหัสประจำตัว (@id) เป็น URL และอ้างถึงกันด้วยรหัสนี้ (ตรวจ 7 ต.ค. 2026) Google จึงรู้ว่าบทความนี้อยู่บนหน้าไหน ใครเขียน และเว็บนี้เป็นขององค์กรไหน โดยไม่ต้องเขียนข้อมูลองค์กรซ้ำทุกหน้า รูปหลักของหน้าก็เป็น ImageObject แยกชิ้น ซึ่งตรงกับที่ AI SEO For Dummies บทที่ 15 แนะนำให้เลือก schema ตามหน้าที่ของสื่อ เช่น รูปใช้ ImageObject และวิดีโอใช้ VideoObject
| ชิ้น (@type) | บอกอะไร | เชื่อมกับ |
|---|---|---|
| Organization | บริษัท ชื่อ โลโก้ ผู้ก่อตั้ง อีเมล | ถูกอ้างจาก WebSite และ BlogPosting (publisher) |
| WebSite | ชื่อเว็บ ภาษา | publisher → Organization |
| WebPage | หน้านี้ วันที่เผยแพร่และแก้ไข | isPartOf → WebSite · breadcrumb → BreadcrumbList |
| BreadcrumbList | หน้าแรก › หมวด › บทความ | ถูกอ้างจาก WebPage |
| ImageObject | รูปหลักของหน้า | primaryImageOfPage ของ WebPage |
| Person | ผู้เขียน ตำแหน่ง โปรไฟล์ (sameAs) | author ของ BlogPosting · worksFor → Organization |
| BlogPosting | ตัวบทความ หัวข้อ วันที่ หมวด | isPartOf → WebPage |
| FAQPage | คำถามที่พบบ่อยที่แสดงท้ายบทความ | อยู่บนหน้าเดียวกัน (ไม่ได้ rich result แล้ว) |
เราเก็บ FAQPage ไว้แม้ Google จะเลิกแสดง FAQ rich results แล้ว เพราะคำถามแสดงอยู่บนหน้าจริงและข้อมูลตรงกับเนื้อหา เหตุผลและข้อควรระวังอยู่ในหัวข้อ FAQ schema ยังควรใส่ไหม
Wikidata จำเป็นไหม ช่วย AI Search แค่ไหน
ธุรกิจส่วนใหญ่ไม่จำเป็นต้องมี Wikidata และยังไม่มีหลักฐานที่ดีว่าการมี item ใน Wikidata ช่วยให้ AI พูดถึงหรืออ้างแบรนด์มากขึ้น Wikidata (วิกิสนเทศ) คือฐานข้อมูลสาธารณะของมูลนิธิวิกิมีเดียที่ใครก็แก้ไขได้ แต่ละสิ่งมีรหัสขึ้นต้นด้วย Q เช่น กรุงเทพมหานครคือ Q1861 ส่วน schema.org คือคำศัพท์ที่เราใช้เขียน markup บนเว็บของตัวเอง สองอย่างนี้เชื่อมกันด้วยช่อง sameAs ใน Organization หรือ Person ที่บอกว่า “องค์กรนี้คือ item นี้ใน Wikidata”
ความต่างที่สำคัญคือ schema บนเว็บเราเป็นข้อมูลที่เราคุมเอง แต่ Wikidata เป็นข้อมูลที่คนอื่นแก้หรือลบได้ และเอกสาร Organization structured data กับ ProfilePage ของ Google (อัปเดต 8 ก.ย. 2026) ไม่พูดถึง Wikidata หรือ Wikipedia เลย ขอแค่ให้ใส่ sameAs ไปหน้าโปรไฟล์บนเว็บอื่น “ถ้ามี”
หลักฐานที่มีตอนนี้ แยกตามความน่าเชื่อถือ:
| ระดับหลักฐาน | ข้อมูล | แปลว่าอะไร |
|---|---|---|
| ทางการ (Google, Wikimedia) | Google ปิด Freebase และย้ายข้อมูลไป Wikidata ช่วงปี 2014–2016 · Wikidata เก็บรหัส Knowledge Graph ของ Google ไว้ (property P2671) · Danny Sullivan จาก Google บอกเมื่อปี 2020 ว่า knowledge panel ดึงจาก “หลายร้อยแหล่ง” โดยยก Wikipedia เป็นตัวอย่าง | Wikidata น่าจะเป็นแหล่งหนึ่งของ Knowledge Graph แต่ Google ไม่เคยบอกว่ามีน้ำหนักเท่าไร |
| ทางการ (บริษัท AI) | Google, Amazon, Meta, Microsoft, Mistral AI และ Perplexity จ่ายเงินใช้ข้อมูลผ่าน Wikimedia Enterprise (ประกาศ 15 ม.ค. 2026) | ข้อมูลที่ซื้อคือเนื้อหา Wikipedia เป็นหลัก ไม่ได้ยืนยันว่า AI ใช้ Wikidata ตอบคำถาม |
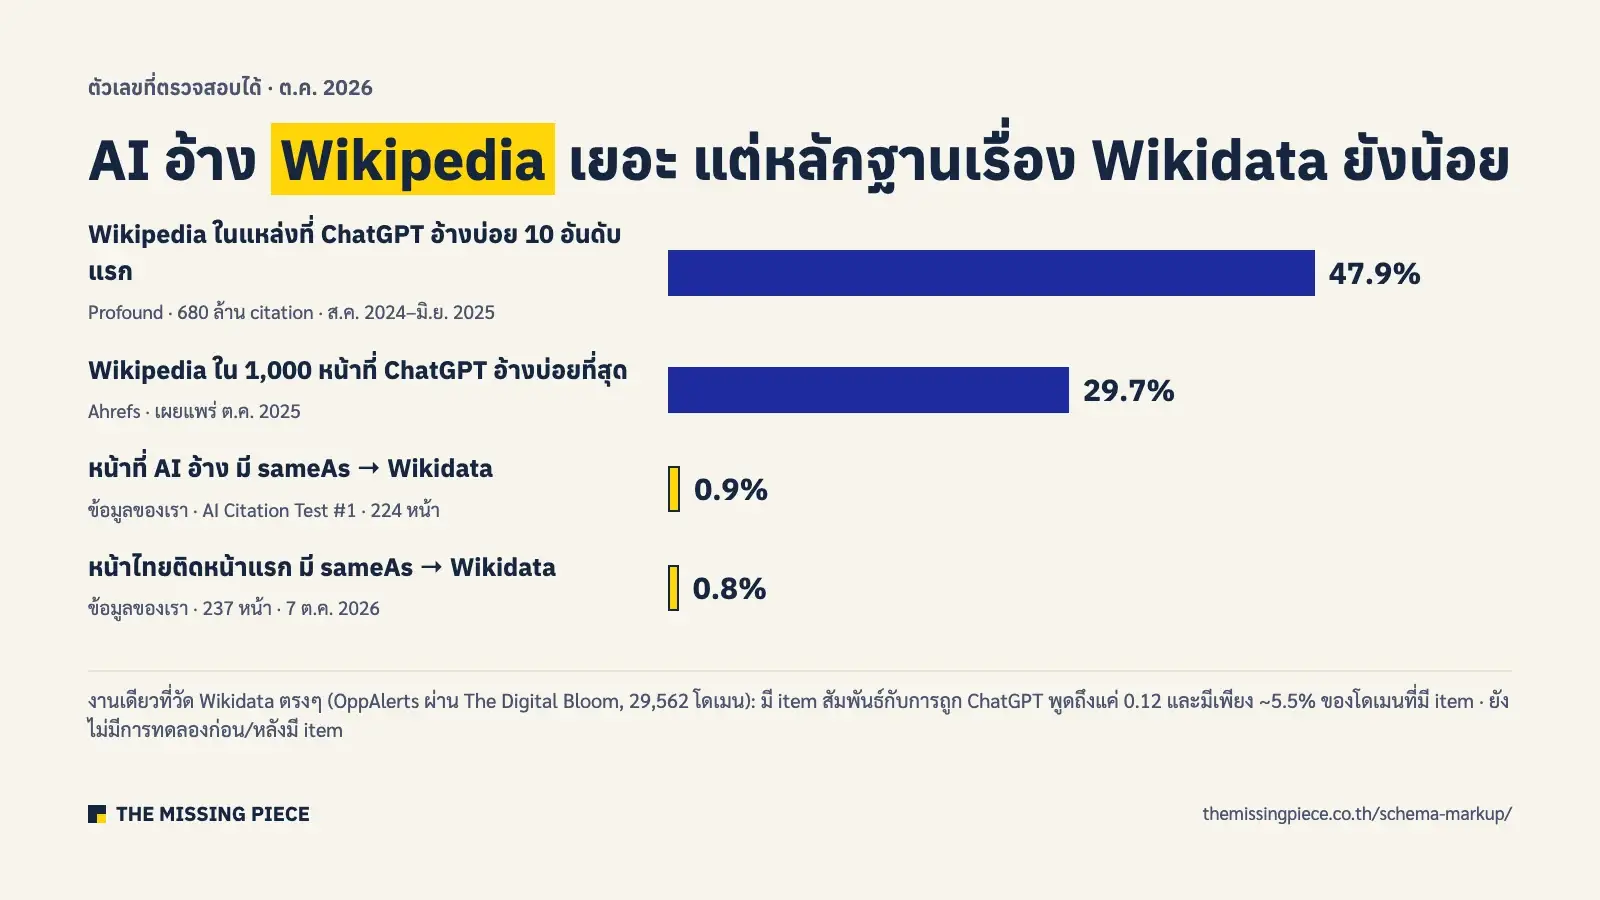
| งานวิจัยจากเครื่องมือ SEO | Profound (มิ.ย. 2025, 680 ล้าน citation ส.ค. 2024–มิ.ย. 2025): Wikipedia เป็น 47.9% ของแหล่งที่ ChatGPT อ้าง 10 อันดับแรก และ 7.8% ของ citation ทั้งหมดของ ChatGPT · Ahrefs (ต.ค. 2025): 29.7% ของหน้า 1,000 หน้าที่ ChatGPT อ้างบ่อยที่สุดเป็น Wikipedia | Wikipedia มีผลกับคำตอบ AI ชัด แต่ทั้งสองงานไม่ได้วัด Wikidata |
| ข้อมูลที่เผยแพร่โดยเอเจนซี | งานที่ The Digital Bloom นำเสนอ (ข้อมูลของ OppAlerts, 105,000+ prompt ใน ChatGPT, 29,562 โดเมน): การมี item ใน Wikidata สัมพันธ์กับการถูก ChatGPT พูดถึงแค่ 0.12 (อธิบายได้ 1.4%) และมีเพียงราว 5.5% ของโดเมนที่มี item | ความสัมพันธ์อ่อนมาก และแบรนด์ที่มี item มักดังอยู่แล้ว จึงบอกไม่ได้ว่า Wikidata เป็นสาเหตุ |
| คำอ้างไม่มีหลักฐาน | “LLM ดึงข้อมูลจาก Wikidata โดยตรง” · “สร้าง item แล้วได้ knowledge panel ใน 3–6 เดือน” | มาจากบริษัทที่ขายบริการนี้ ไม่มีข้อมูลรองรับ และยังไม่มีใครทดลองวัดก่อนกับหลังมี item |
| ข้อมูลของเรา | AI Citation Test #1 (ต.ค. 2026): หน้าที่ AI อ้าง 224 หน้า มี sameAs ใน JSON-LD 45% แต่ชี้ไป Wikidata แค่ 2 หน้า (0.9%) และไป Wikipedia 7 หน้า (3%) · หน้าไทยที่ติด 10 อันดับแรก 237 หน้าในการสำรวจของเรา (7 ต.ค. 2026) มี sameAs 24% แต่ชี้ไป Wikidata แค่ 2 หน้า (0.8%) และไป Wikipedia 1 หน้า (0.4%) | การใส่ sameAs ไป Wikidata ไม่ใช่สิ่งที่หน้าที่ถูก AI อ้างหรือติดหน้าแรกมีกัน |
ใครสร้าง item ได้: ตามเกณฑ์ notability ของ Wikidata item ต้องเข้าข้อใดข้อหนึ่ง คือมีหน้าในโครงการวิกิมีเดีย เช่น Wikipedia หรือเป็นสิ่งที่ระบุตัวได้ชัดและมีแหล่งข้อมูลสาธารณะที่น่าเชื่อถือพูดถึง หรือจำเป็นต่อโครงสร้างข้อมูลของ item อื่น แนวทางเรื่องการโปรโมตตัวเองขอให้ไม่สร้าง item ของตัวเองหรือบริษัทตัวเอง และข้อกำหนดการใช้งานของวิกิมีเดียบังคับให้คนที่รับเงินมาแก้ไขต้องเปิดเผยว่าใครจ้าง
ความเสี่ยงเกิดขึ้นจริง วันที่ 16 ก.ค. 2026 นักพัฒนาคนหนึ่งที่สร้าง item ให้ตัวเองและผลงานของตัวเอง 109 รายการ เพราะเชื่อว่าจะช่วยให้ AI อ้าง ถูกลบทั้งหมดภายในราว 2 นาทีครึ่ง และบัญชีถูกบล็อกด้วยเหตุผล “Promotion-only account” เราตรวจกับบันทึกการลบสาธารณะของ Wikidata แล้วตรงกับที่เจ้าตัวเล่าไว้ ส่วน Wikipedia ทั้งภาษาอังกฤษและภาษาไทยเข้มกว่า ข่าวประชาสัมพันธ์และบทความที่จ่ายเงินลงใช้เป็นแหล่งอ้างอิงไม่ได้
ควรทำอะไร แยกตามธุรกิจ:
| สถานการณ์ | Wikidata | ทำสิ่งนี้แทน หรือทำก่อน |
|---|---|---|
| ร้านค้า คลินิก SME ไทย | ไม่ต้องสร้าง | Google Business Profile ให้ครบ · ชื่อ ที่อยู่ เบอร์ ตรงกันทุกที่ · Organization หรือ LocalBusiness schema + sameAs ไป Facebook Page, LINE OA, Instagram, LinkedIn · หน้าเกี่ยวกับเราที่ข้อมูลครบ |
| บริษัท B2B เอเจนซี สตาร์ทอัป ที่สื่อยังพูดถึงน้อย | ยังไม่ถึงเวลา | LinkedIn บริษัท, Crunchbase, รายชื่อสมาคมวิชาชีพ, คำอธิบายบริษัทประโยคเดียวกันทุกที่ · หาพื้นที่ในสื่อที่เป็นเนื้อหาจริง ไม่ใช่ advertorial |
| บุคคล เช่น ที่ปรึกษา วิทยากร ผู้เขียน | เฉพาะเมื่อมีแหล่งอิสระพูดถึงจริง | Person schema บนหน้าโปรไฟล์ + sameAs ไป LinkedIn, YouTube, หน้าหนังสือ · ประวัติย่อเดียวกันทุกที่ |
| แบรนด์ใหญ่ หรือมีหน้า Wikipedia แล้ว | น่าจะมี item อยู่แล้ว | ตรวจว่าข้อมูลถูกต้อง แก้ข้อผิดพลาดพร้อมแหล่งอ้างอิงและเปิดเผยว่าเกี่ยวข้อง · ใส่ลิงก์ item ใน sameAs |
| ทุกเว็บ | ลิงก์ไป item ที่มีอยู่แล้วได้ | ใช้ about หรือ mentions ชี้ไป item ของหัวข้อหรือสถานที่ที่เนื้อหาพูดถึง เช่น กรุงเทพมหานคร (Q1861) โดยไม่ต้องสร้างอะไรใหม่ |
ถ้าแบรนด์มี knowledge panel ขึ้นแล้ว ให้ยืนยันความเป็นเจ้าของ (claim) ตามขั้นตอนของ Google ส่วนธุรกิจท้องถิ่นใช้ Google Business Profile แทน AI SEO For Dummies บทที่ 13, 16 และ 17 เน้นเรื่องเดียวกัน คือหน้าเว็บหลักที่บอกว่าแบรนด์คือใคร ข้อมูลหลักของแบรนด์ที่ตรงกันทุกที่ และโปรไฟล์ที่กำหนดตัวตนของแบรนด์บนแพลตฟอร์มต่างๆ
เว็บเราเองยังไม่มี item ใน Wikidata (ค้นทั้งชื่อไทยและอังกฤษ 7 ต.ค. 2026) และชื่อ “The Missing Piece” ซ้ำกับอัลบั้มเพลงและภาพยนตร์ใน Wikidata เราจึงเลือกไม่สร้างเอง แล้วใช้ Organization และ Person schema ที่มี sameAs ไปโปรไฟล์ทางการแทน
ตรวจ schema ยังไง และทำไมใส่แล้วไม่ขึ้น
ตรวจ schema ด้วยเครื่องมือฟรีของ Google และ schema.org 3 ตัวคู่กัน แต่ละตัวตอบคนละคำถาม Structured Data Testing Tool ตัวเก่าเลิกใช้แล้วและถูกแทนด้วย 2 ตัวแรก
| เครื่องมือ | ตอบคำถาม | ใช้ตอนไหน |
|---|---|---|
| Rich Results Test | หน้านี้มีสิทธิ์ได้ rich result แบบไหนของ Google และมี error อะไร (ตรวจเฉพาะ type ที่ Google รองรับ) | ก่อนเอาขึ้นเว็บ และหลังแก้ |
| Schema Markup Validator | โค้ดถูกตามคำศัพท์ schema.org ไหม (ตรวจได้ทุก type) | ตรวจ type ที่ Google ไม่มี rich result เช่น Organization แบบละเอียด |
| Google Search Console | Google เจอ schema บนหน้าจริงกี่หน้า ถูกหรือผิด | หลังขึ้นเว็บ ดูรายงานตาม type และตัวกรอง Search appearance ในรายงาน Performance |
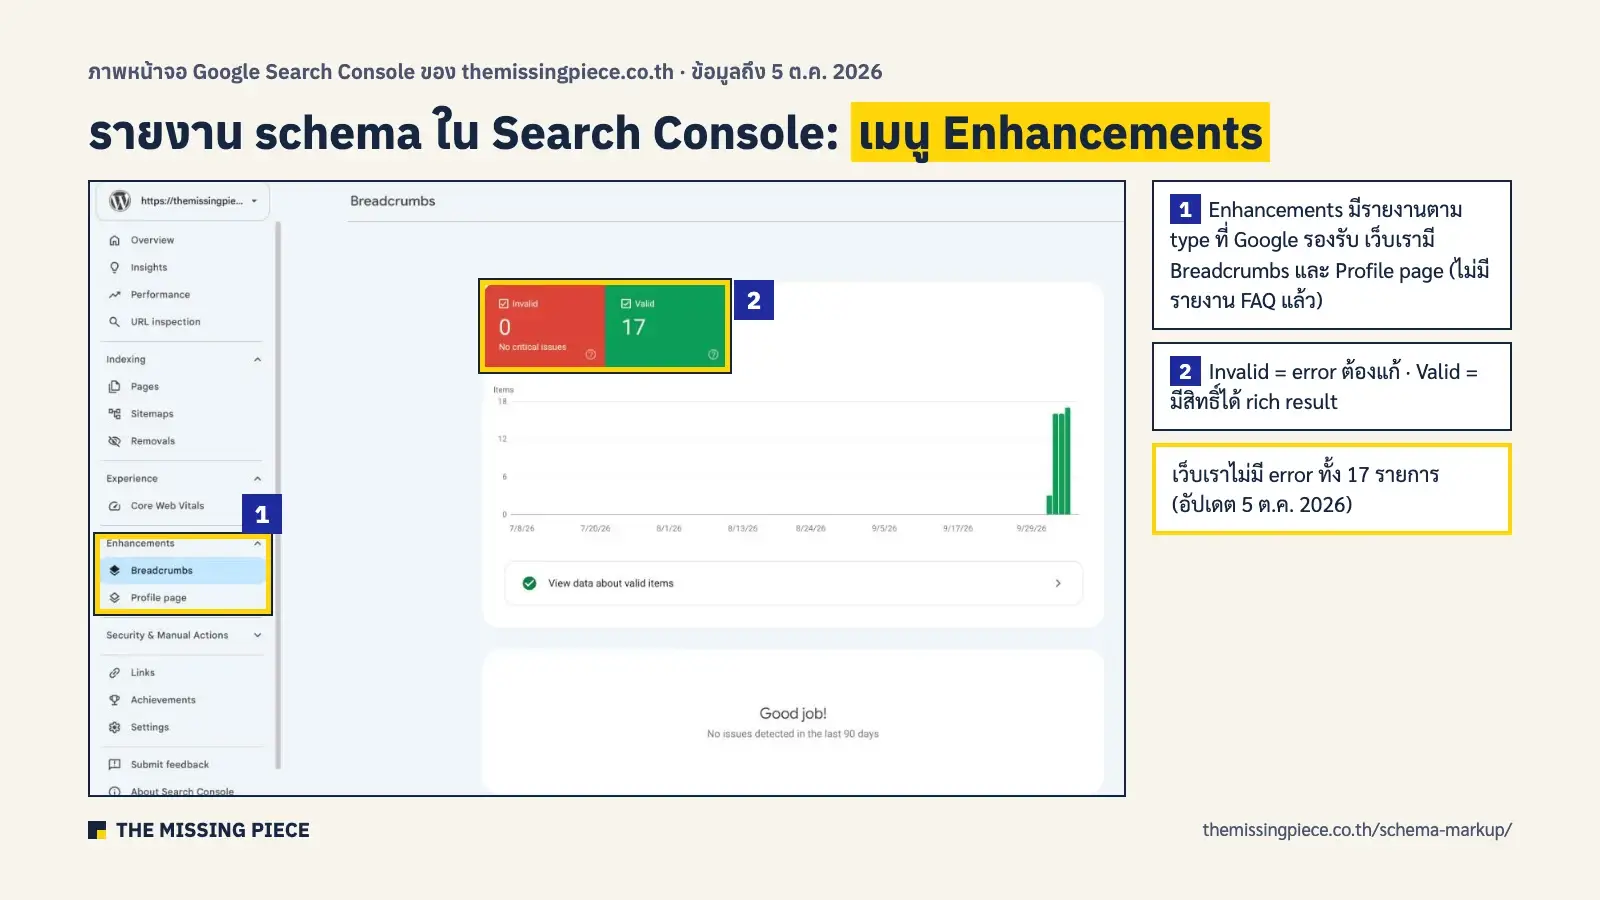
ถ้าใส่ schema แล้วไม่ขึ้น rich result สาเหตุที่พบบ่อยคือ:
- Google ไม่แสดง type นั้นแล้ว เช่น FAQ, HowTo หรือ sitelinks search box
- ยังขาดช่องที่จำเป็น (required) ดูได้จาก error ใน Rich Results Test
- Google ยังไม่ได้เก็บหน้าเวอร์ชันใหม่ ขอให้ index ใหม่ผ่าน URL Inspection แล้วรอ
- ข้อมูลใน schema ไม่ตรงกับบนหน้า หรือ markup ข้อมูลที่ผู้ใช้มองไม่เห็น
- Google เลือกไม่แสดง แม้ทุกอย่างถูก เพราะ rich result ขึ้นกับคำค้น อุปกรณ์ และตำแหน่งของผู้ค้น ตามแนวทางของ Google
- โดน manual action จากการ markup แบบสแปม เช่น รีวิวปลอม เช็กได้ในเมนู Manual actions ของ Search Console
AI SEO For Dummies บทที่ 3 แนะนำให้ตรวจ schema และข้อมูลตัวตนบนเว็บตั้งแต่วันแรกที่เริ่มงาน แล้วบันทึกไว้เป็นจุดตั้งต้นสำหรับเทียบผลภายหลัง
Schema กับ AI Search (สรุปสั้น)
Schema ไม่ใช่เงื่อนไขของการขึ้นคำตอบ AI Google ระบุในเอกสาร AI features and your website (ธ.ค. 2025) ว่าการขึ้น AI Overviews และ AI Mode ไม่ต้องมี schema.org แบบพิเศษ ขอแค่ structured data ตรงกับข้อความบนหน้า และยังไม่มีงานศึกษาที่แสดงว่าการเพิ่ม schema ทำให้ถูก AI อ้างมากขึ้น (รายละเอียดในหัวข้อ FAQ schema) AI SEO For Dummies บทที่ 11 ก็มอง schema เป็นชั้นเสริมบน HTML ที่ดี ไม่ใช่ตัวแทน หลักฐานแบบละเอียดและสิ่งที่ควรทำจะอยู่ในบทความ Schema สำหรับ AI Search ที่เรากำลังเขียน ระหว่างนี้ดูภาพรวมงานทั้งหมดได้ที่ วิธีทำ AI SEO ทีละขั้น
- On-Page SEO คืออะไร: เช็กลิสต์ 2026
- Sitemap คืออะไร สร้างและส่งยังไง
- คอร์สเรียน SEO & AI Search (สอนสด 2 วัน · 21–22 ธ.ค. 2026)
- Technical SEO คืออะไร
ความเห็นของผม (ไอซ์): ผมมองว่าบางครั้ง Google ก็พูดได้เฉพาะในสิ่งที่เขาพูดได้ ผมจึงไม่ได้ดูข้อมูลจากฝั่ง Google อย่างเดียว แต่ทดสอบจากผลจริงในตลาดก่อน ว่าแบรนด์ที่ติดอันดับดีและถูก AI พูดถึงทำ Schema ไหม ถ้าเขาทำ ผมก็ทำ ผมยังมองว่า Schema เป็นหนึ่งใน factor สำคัญที่ช่วยให้ AI ดึงข้อมูลไปตอบได้ง่ายขึ้น จึงยังแนะนำให้ทำ
คำถามที่พบบ่อย
Schema แปลว่าอะไร
ในทาง SEO schema หมายถึงชุดคำศัพท์จาก schema.org ที่ใช้บอก search engine ว่าข้อมูลบนหน้าคืออะไร คำนี้ในความหมายทั่วไปแปลว่าโครงสร้างหรือแบบแผน จึงมีความหมายอื่นในงานฐานข้อมูลและจิตวิทยาด้วย
ใส่ schema แล้วนานแค่ไหนกว่าจะเห็นผล
ต้องรอให้ Google เก็บหน้าเวอร์ชันใหม่ก่อน ปกติไม่กี่วันถึงไม่กี่สัปดาห์ ขอให้ index ใหม่ผ่าน URL Inspection ได้ แต่ Google ไม่รับประกันว่าจะแสดง rich result
ใส่ schema หลายแบบในหน้าเดียวได้ไหม
ได้ เช่น หน้าบทความมี Organization, BreadcrumbList, BlogPosting และ Person พร้อมกัน ควรเชื่อมกันด้วย @id ใน @graph และทุกแบบต้องตรงกับเนื้อหาบนหน้า
Microdata ยังใช้ได้ไหม
ใช้ได้ Google รองรับ JSON-LD, Microdata และ RDFa แต่แนะนำ JSON-LD เพราะดูแลง่ายกว่า ถ้าเว็บเดิมใช้ Microdata อยู่และไม่มี error ไม่จำเป็นต้องรีบเปลี่ยน
ใช้ schema generator หรือให้ AI เขียนได้ไหม
ได้ แต่ต้องตรวจผลด้วย Rich Results Test และ Schema Markup Validator ทุกครั้ง และเทียบกับข้อมูลบนหน้า เพราะเครื่องมือและ AI อาจใส่ช่องที่ไม่มีอยู่จริงหรือ type ที่ Google เลิกแสดงแล้ว
แหล่งอ้างอิง
- Google Search Central: Introduction to structured data (10 ธ.ค. 2025) · General structured data guidelines (10 ก.ค. 2026) · Search Gallery (15 มิ.ย. 2026) · Search Central updates (ตรวจ 6 ต.ค. 2026) · Simplifying the search results page (12 มิ.ย. 2025) · Sitelinks search box (ต.ค. 2024) · AI features and your website (10 ธ.ค. 2025) · Guide to optimizing for generative AI features (10 ก.ค. 2026)
- schema.org releases (v30.1, 16 ก.ย. 2026) · Schema Markup Validator · Rich Results Test
- John Mueller (Google) ผ่าน Search Engine Roundtable, structured data won’t make your site rank better (15 เม.ย. 2025) · Google drops FAQ rich results (11 พ.ค. 2026, คำพูดของ Mueller 9 พ.ค. 2026)
- Microsoft Advertising blog, Optimizing your content for inclusion in AI search answers (8 ต.ค. 2025) · SearchPilot, Adding price and review schema to product pages (ก.พ. 2021, ข้อมูลเก่า) · SearchPilot, Implementing Article schema (retest) (21 ก.ย. 2023) · Ahrefs, Schema and AI citations (11 พ.ค. 2026)
- Wikidata และวิกิมีเดีย: Notability · Self-promotion · Wikimedia Terms of Use · P2671 Google Knowledge Graph ID · Wikimedia Enterprise partners (15 ม.ค. 2026) · Google, A reintroduction to our Knowledge Graph and knowledge panels (20 พ.ค. 2020) · Claim your knowledge panel
- Profound, AI platform citation patterns (5 มิ.ย. 2025) · Ahrefs, ChatGPT’s most cited pages (28 ต.ค. 2025) · The Digital Bloom, LLM ranking factors (ข้อมูล OppAlerts) · DEV Community, Banned from Wikidata overnight (30 ก.ค. 2026; ตรวจกับบันทึกการลบของ Wikidata 16 ก.ค. 2026)
- ข้อมูลของ The Missing Piece: สำรวจ schema ของหน้าไทยที่ติด 10 อันดับแรก 236 หน้า (7 ต.ค. 2026, ไม่เปิดเผยชื่อเว็บ) · ฟีเจอร์ในผลค้นหา Google ไทย 46 คำค้น (6 ต.ค. 2026) · schema ของเว็บ themissingpiece.co.th (7 ต.ค. 2026) · AI Citation Test #1 (ต.ค. 2026, วิเคราะห์ sameAs เพิ่ม 7 ต.ค.) · sameAs ของหน้าไทยที่ติด 10 อันดับแรก 237 หน้า (7 ต.ค. 2026)
- Nathan Gotch, AI SEO For Dummies (Wiley, 2026), บทที่ 3 (ตรวจ schema และข้อมูลตัวตนตั้งแต่วันแรก), 11 (schema เป็นชั้นเสริมบน HTML ที่ดี และใช้ FAQPage เฉพาะเมื่อคำถามแสดงบนหน้า), 12 (แนะนำ FAQPage ซึ่งเขียนก่อน Google เลิกแสดง), 13 (ข้อมูลตัวตนตรงกันทุกที่), 15 (เลือก schema ตามหน้าที่ของสื่อ), 16 (ข้อมูลหลักของแบรนด์ตรงกันทุกที่), 17 (โปรไฟล์ที่กำหนดตัวตนของแบรนด์)
- Eric Enge, Stephan Spencer, Jessie Stricchiola, The Art of SEO, 4th ed. (O’Reilly, 2023), บทที่ 7 (structured data, JSON-LD และการทยอยใช้ทีละ type) · คำแนะนำเรื่อง FAQ และ HowTo ในเล่มเขียนก่อนที่ Google จะเลิกแสดง
ตรวจข้อมูลล่าสุด: 7 ต.ค. 2026 · Google เปลี่ยนรายการ rich results บ่อย เราจะตรวจ Search Gallery และอัปเดตไทม์ไลน์ทุกไตรมาส