สรุปสั้น (TL;DR)
Google Index คือฐานข้อมูลหน้าเว็บที่ Google crawl แล้วเลือกเก็บไว้ หน้าที่ไม่อยู่ใน index จะไม่ขึ้นในผลค้นหา และไม่ถูกใช้เป็นลิงก์อ้างอิงใน AI Overviews หรือ AI Mode เว็บไม่ติด Google มักเกิดจาก 3 เรื่อง คือ Google ยังไม่เจอหน้า หน้าถูกบล็อกหรือสั่งไม่ให้ index หรือ Google อ่านแล้วเลือกไม่เก็บ วิธีหาว่าเป็นเรื่องไหนคือเช็กหน้านั้นด้วย URL Inspection ดูชื่อสถานะในรายงาน Page indexing แล้วแก้ตามสาเหตุของสถานะนั้น ไม่ใช่กดขอ index ซ้ำไปเรื่อยๆ
- Google ไม่รับประกันว่าจะ index ทุกหน้า: เอกสาร How Google Search works (ปรับล่าสุด 18 ธ.ค. 2025) เขียนไว้ตรงๆ และรายงาน Page indexing บอกว่าอย่าคาดหวังให้ทุก URL ถูก index หน้าที่ต้องติดคือหน้าสำคัญ
- เวลาที่ Google ให้ไว้เอง: ขอ crawl ใหม่ใช้ตั้งแต่ไม่กี่วันถึงไม่กี่สัปดาห์ เว็บใหม่อาจใช้ไม่กี่สัปดาห์กว่า Google จะเจอ และ Validate fix มักใช้ไม่เกินราว 2 สัปดาห์ (เอกสาร Google ธ.ค. 2025 และ Search Console Help)
- กด Request indexing ซ้ำไม่ช่วยให้เร็วขึ้น: Google บอกว่าการขอซ้ำไม่ทำให้ crawl เร็วขึ้น และมีโควตาต่อวัน เราเองเคยกดจนเต็มโควตาเมื่อ 15 ต.ค. 2026 จึงวางแผนกดเฉพาะหน้าใหม่หรือหน้าที่แก้สำคัญ
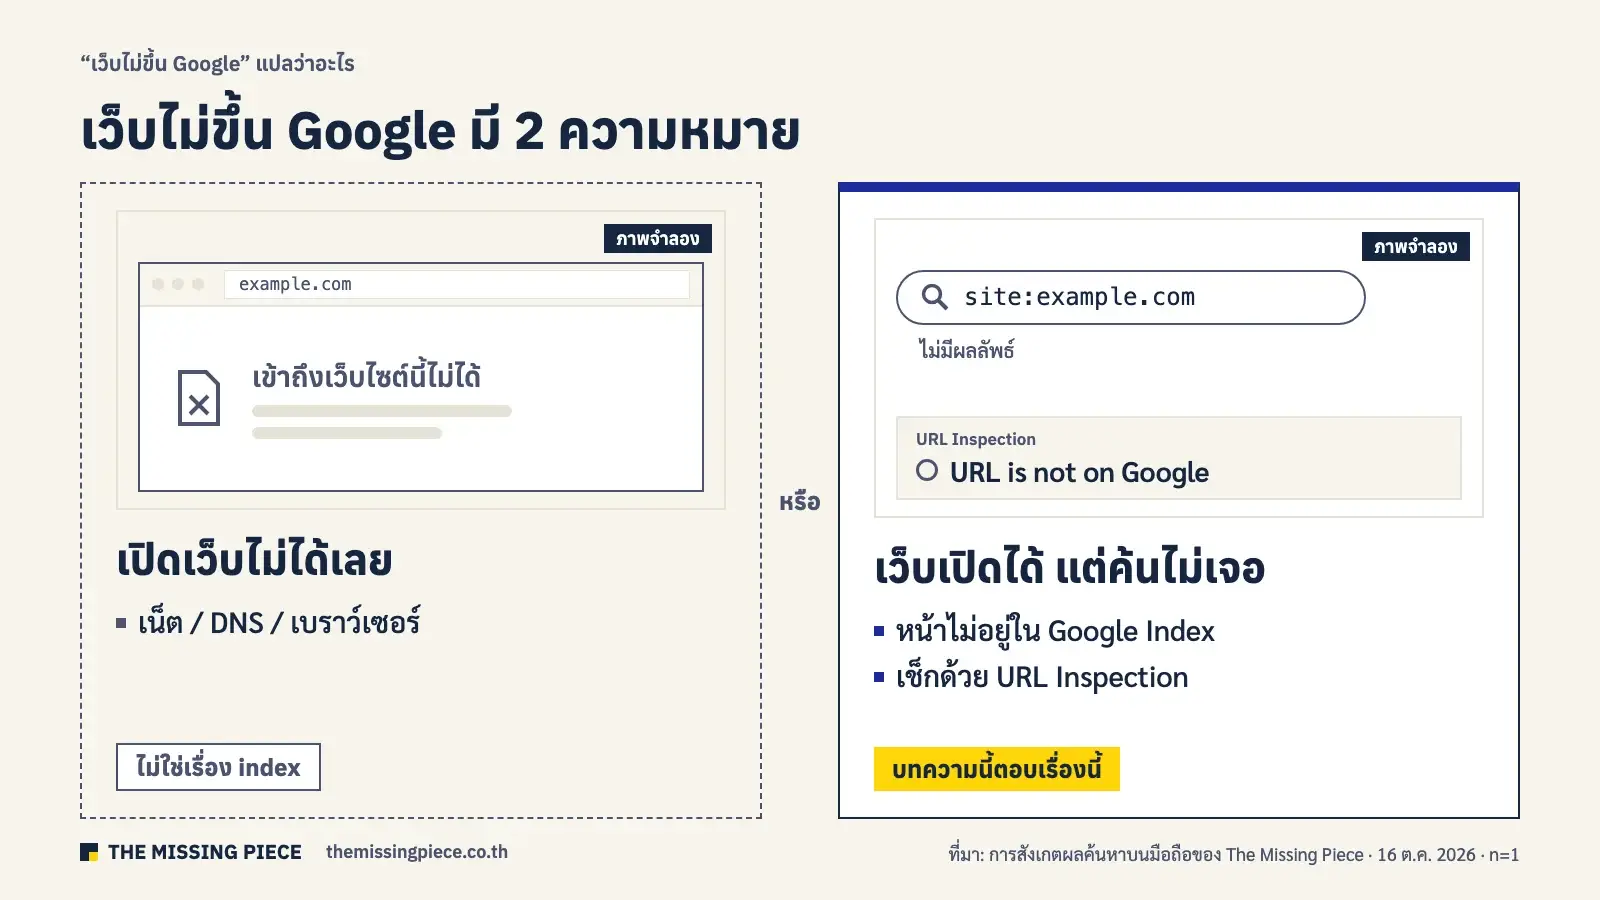
เช็กก่อนว่าปัญหาของคุณคือเรื่องไหน: ถ้าเปิดเว็บไหนไม่ได้เลย เช่น Chrome ขึ้นว่าเข้าถึงเว็บไซต์นี้ไม่ได้ นั่นคือปัญหาเน็ต DNS หรือเบราว์เซอร์ ไม่ใช่เรื่อง index บทความนี้เขียนสำหรับเจ้าของเว็บที่เว็บเปิดได้ปกติ แต่ค้นใน Google แล้วไม่เจอหน้าของตัวเอง เราแยกให้ชัดเพราะเมื่อค้นคำว่า “ทำไมเว็บไม่ขึ้น google แก้ยังไง” บนมือถือ (16 ต.ค. 2026 ครั้งเดียว) ผล 10 อันดับแรกเป็นเรื่องเปิดเว็บไม่ได้ทั้งหมด ไม่มีผลเรื่อง index เลย
สารบัญ
- Google Index คืออะไร
- เช็กยังไงว่าเว็บติด Google แล้ว
- ต้องรอนานแค่ไหน (ตารางเวลาที่ Google พูดเอง)
- ทำไมเว็บไม่ติด Google: 10 สาเหตุที่เจอบ่อย
- อ่านรายงาน Page indexing แล้วแก้ทีละสถานะ
- ขอ index (Request indexing) ยังไง และไม่ควรทำอะไร
- แก้แล้วกด Validate fix ต้องรอนานไหม
- ทุกหน้าต้องติด index ไหม
- ติด index แล้ว แต่ทำไมยังไม่มีใครเห็น
- ไม่ติด Google แล้วจะติด AI Search ไหม
- เช็กลิสต์ 10 นาทีเมื่อหน้าไม่ติด Google
- คำถามที่พบบ่อย
Google Index คืออะไร (index เว็บไซต์ต่างจาก crawl และอันดับยังไง)
Google Index คือฐานข้อมูลขนาดใหญ่ที่เก็บหน้าเว็บซึ่ง Google crawl (ส่งบอตไปอ่านหน้า) แล้วเลือกเก็บไว้ การ index เว็บไซต์ (google indexing) จึงเป็นขั้นที่หน้าของคุณ “มีสิทธิ์” ถูกแสดงในผลค้นหา ถ้าหน้าไม่อยู่ใน index ก็จะไม่ขึ้นใน Google ไม่ว่าเนื้อหาจะดีแค่ไหน
เอกสาร How Google Search works (ปรับล่าสุด 18 ธ.ค. 2025) แบ่งงานของ Google เป็น 3 ขั้น ได้แก่ crawl (ดาวน์โหลดหน้า) index (วิเคราะห์เนื้อหาแล้วเก็บ) และ serve (เลือกหน้าที่ตรงที่สุดมาแสดงตอนมีคนค้น) ในขั้น index Google ยังรวมหน้าที่เนื้อหาซ้ำกันเป็นกลุ่ม แล้วเลือกหน้าหลักหนึ่งหน้า (canonical) ไว้แสดง หน้าที่เหลือในกลุ่มจึงไม่ขึ้นแม้จะไม่มีอะไรผิด Google Index เป็นงานหนึ่งของ Technical SEO ดูภาพรวมทั้ง 3 ขั้นแบบละเอียดได้ที่ Search Engine คืออะไร ทำงานยังไง
ข้อที่ต้องรู้ก่อนเริ่มแก้คือ Google เขียนในเอกสารเดียวกันว่าไม่รับประกันว่าจะ crawl, index หรือแสดงหน้าใด แม้หน้านั้นทำตามแนวทางทุกข้อ The Art of SEO (4th ed., 2023) บทที่ 3 อธิบายเหตุผลไว้คล้ายกันว่าเว็บทั้งโลกใหญ่เกินกว่าจะ crawl ได้หมด บอตจึงข้าม URL บางแบบ เช่น URL ที่ไม่มีลิงก์ชี้มาและไม่อยู่ใน sitemap ลิงก์ที่มีแค่ใน JavaScript หน้าที่อยู่ลึกเกินไป หน้าที่บอตเคยอ่านแล้วตัดสินว่าไม่ต้องกลับมาอ่านอีก หรืองบ crawl ของเว็บไม่พอ
ถ้าเปรียบให้เห็นภาพ crawl คือ “อ่านแล้ว” index คือ “เก็บเข้าห้องสมุดแล้ว” และอันดับคือ “ถูกหยิบมาให้คนที่ถามเห็น” สามเรื่องนี้แยกกัน หน้าที่ถูก crawl อาจไม่ถูก index และหน้าที่ถูก index ก็อาจยังไม่มีอันดับที่คนเห็น AI SEO For Dummies บทที่ 2 เล่าลำดับเดียวกัน และเพิ่มขั้นจัดอันดับใหม่ของระบบ AI ไว้ต่อท้าย พร้อมเตือนว่าเนื้อหาสำคัญควรอยู่ใน HTML ที่เซิร์ฟเวอร์ส่งมาตั้งแต่แรก ไม่ใช่รอ JavaScript สร้างทีหลัง
เช็กยังไงว่าเว็บติด Google แล้ว (site: กับ URL Inspection ต่างกันยังไง)
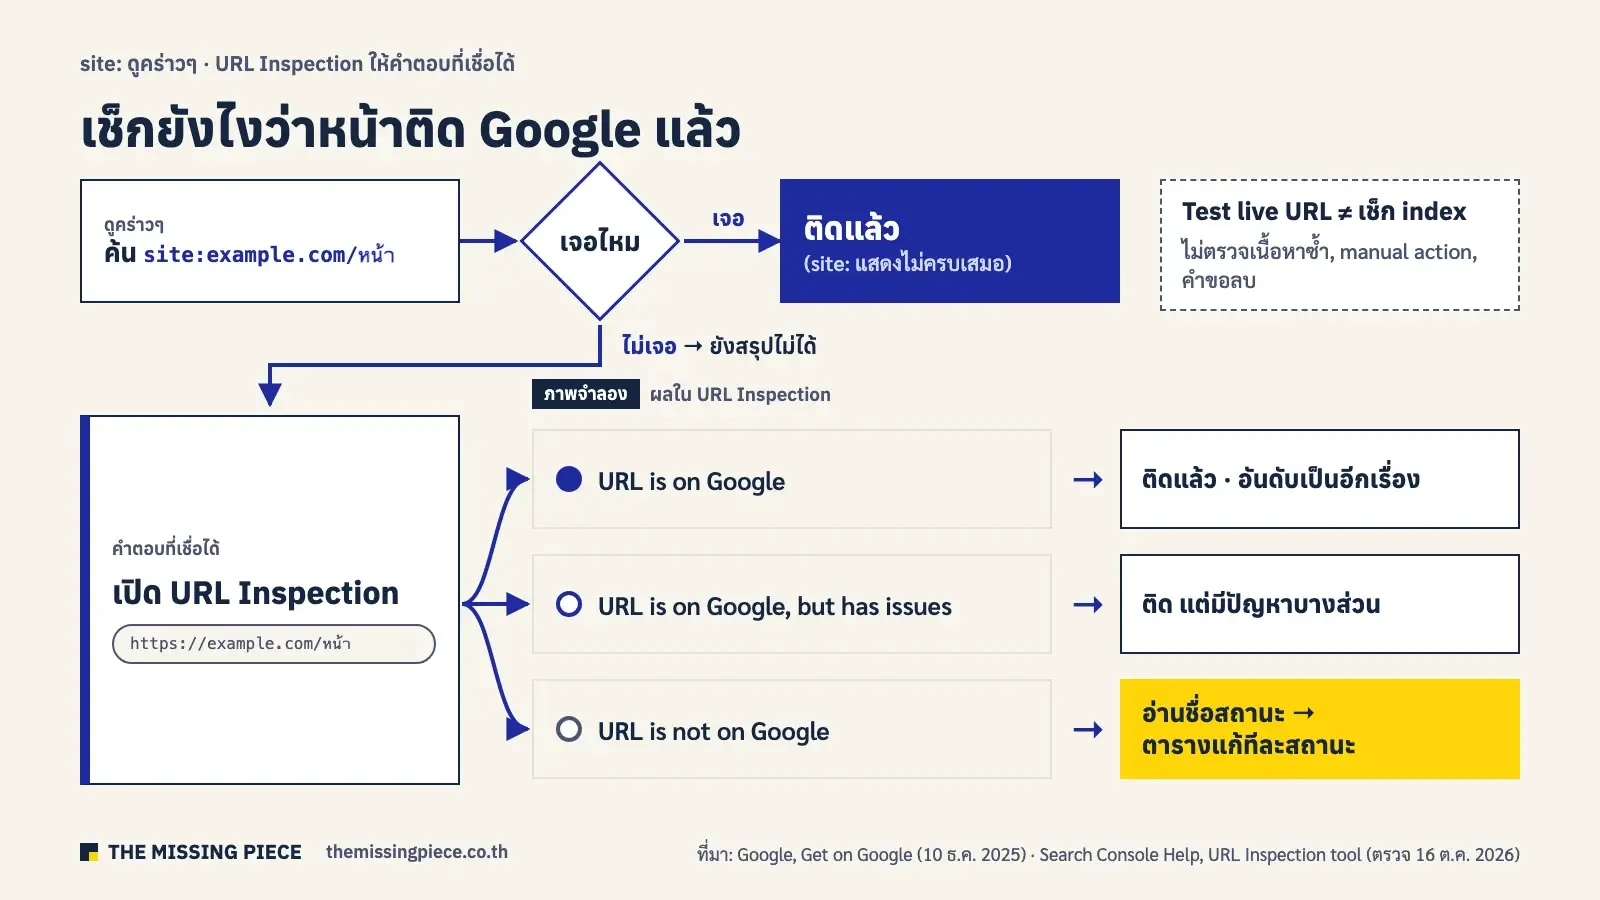
วิธีเช็กว่าเว็บติด Google ที่แม่นที่สุดคือ URL Inspection ใน Search Console ส่วนการค้นด้วย site: ใช้ดูคร่าวๆ ได้เร็วแต่ไม่ครบ คนที่ยังไม่มี Search Console เริ่มจาก site: ได้เลย แต่ถ้าจะตัดสินว่าหน้าไหนไม่ติดและเพราะอะไร ต้องใช้ URL Inspection กับรายงาน Page indexing ซึ่งต้องยืนยันเว็บก่อน ดูวิธีตั้งค่าได้ที่ Google Search Console คืออะไร ตั้งค่ายังไง
1. ค้นด้วย site: (ดูคร่าวๆ)
พิมพ์ site:example.com ใน Google เพื่อดูหน้าของโดเมนที่อยู่ใน index หรือพิมพ์ site:example.com/ชื่อหน้า เพื่อดูทีละหน้า เอกสาร Get on Google (ปรับล่าสุด 10 ธ.ค. 2025) บอกว่าวิธีนี้อาจไม่แสดงทุก URL และ The Art of SEO บทที่ 8 ก็เตือนว่าตัวเลขจาก site: เป็นแค่การประมาณ ถ้าไม่เจอหน้าใน site: จึงยังสรุปไม่ได้ว่าหน้านั้นไม่ติด ส่วนวิธีเช็กแบบเก่าอย่าง cache: ใช้ไม่ได้แล้ว เพราะ Google เลิกลิงก์ cache เมื่อ ก.พ. 2024 และคำสั่ง cache: หยุดทำงานราว ก.ย. 2024 (รายงานโดย Search Engine Land)
2. URL Inspection (คำตอบที่เชื่อได้)
วาง URL เต็มลงในช่องค้นด้านบนของ Search Console แล้วอ่านผล ตาม Search Console Help (หน้า URL Inspection tool ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026) ผลมี 3 แบบหลัก
- URL is on Google: หน้าอยู่ใน index แล้ว แต่ Google บอกว่าไม่ได้แปลว่าจะขึ้นในผลค้นหาทุกครั้ง
- URL is on Google, but has issues: อยู่ใน index แต่มีปัญหาบางส่วน เช่น structured data หรือการแสดงผลบางแบบ
- URL is not on Google: ไม่อยู่ใน index ให้ดูบรรทัดเหตุผลด้านล่าง ซึ่งเป็นชื่อสถานะเดียวกับในรายงาน Page indexing แล้วไปที่ตารางแก้ทีละสถานะ
ปุ่ม Test live URL ช่วยดูว่า Googlebot เข้าหน้าได้ไหมตอนนี้ แต่ Search Console Help ระบุว่าการทดสอบสดไม่ได้เช็กทุกอย่างที่ใช้ตัดสินการ index เช่น เนื้อหาซ้ำ การดำเนินการโดยเจ้าหน้าที่ (manual action) หรือคำขอลบ ผล “ผ่าน” จากการทดสอบสดจึงไม่ได้แปลว่าหน้าจะติด index
3. รายงาน Page indexing (ดูทั้งเว็บ)
เมนู Indexing › Pages แสดงจำนวนหน้าที่ Indexed กับ Not indexed และรายการเหตุผลที่ไม่ index พร้อมจำนวนหน้าในแต่ละเหตุผล รายงานนี้มาแทนรายงาน Coverage แบบเก่า (Valid / Excluded / Error) ที่หนังสือและบทความรุ่นก่อนยังพูดถึง ถ้าคุณอ่านคู่มือที่ยังใช้ชื่อเก่า ให้รู้ว่าเมนูย้ายแล้ว
เว็บใหม่ต้องรอนานแค่ไหนกว่าจะติด Google (ตารางเวลาที่ Google พูดเอง)
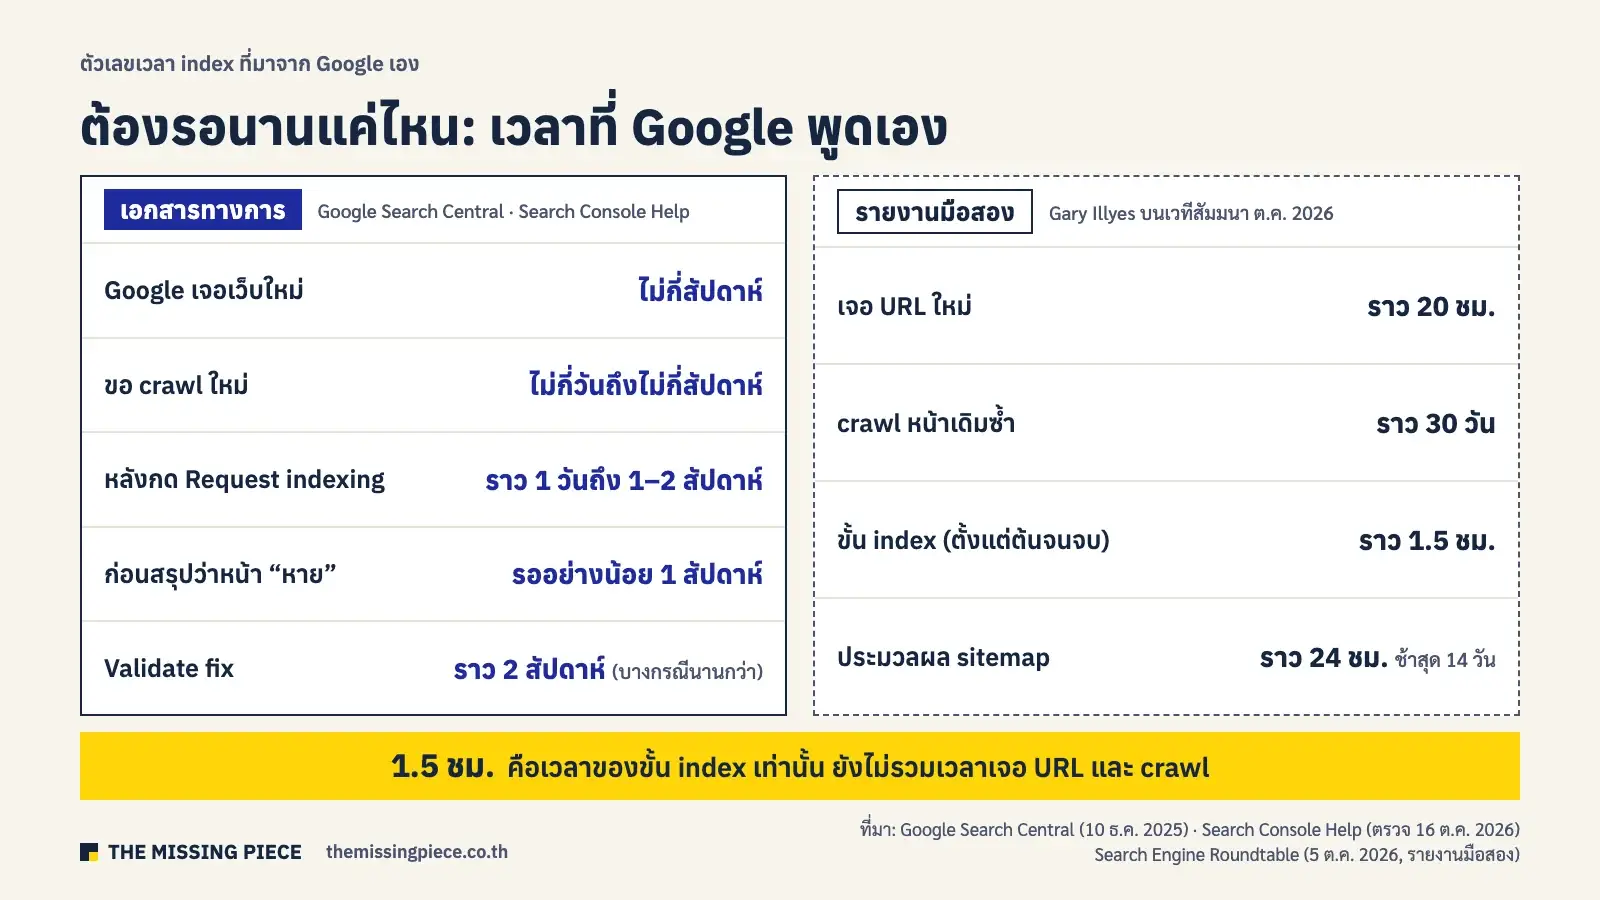
เวลาที่ Google ใช้ index หน้าใหม่ไม่มีตัวเลขตายตัว เอกสารทางการให้เป็นช่วง ตั้งแต่ราว 1 วันไปจนถึงไม่กี่สัปดาห์ ตารางนี้รวมตัวเลขที่ Google พูดเองไว้ที่เดียว พร้อมที่มาและวันที่ของแต่ละแถว คนที่เพิ่งเปิดเว็บใหม่หรือเพิ่งแก้หน้าใช้ตารางนี้ตัดสินได้ว่าควรรอต่อหรือควรเริ่มหาสาเหตุ
| เรื่อง | เวลาที่ระบุ | ที่มา (วันที่) | ประเภท |
|---|---|---|---|
| Google เจอเว็บใหม่ | อาจใช้ไม่กี่สัปดาห์ | Get on Google (ปรับล่าสุด 10 ธ.ค. 2025) | เอกสารทางการ |
| ขอให้ Google crawl ใหม่ (URL Inspection หรือ sitemap) | ไม่กี่วันถึงไม่กี่สัปดาห์ | Ask Google to recrawl your URLs (ปรับล่าสุด 10 ธ.ค. 2025) | เอกสารทางการ |
| หลังกด Request indexing | ราว 1 วัน ไปจนถึง 1–2 สัปดาห์ | Search Console Help, URL Inspection tool (ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026) | เอกสารทางการ |
| หลังส่ง sitemap หรือขอ index ก่อนสรุปว่า “หาย” | รออย่างน้อย 1 สัปดาห์ | Search Console Help ภาษาไทย, ทำไมหน้าเว็บของฉันจึงหายไปจาก Google Search (ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026) | เอกสารทางการ |
| Validate fix ในรายงาน Page indexing | มักไม่เกินราว 2 สัปดาห์ บางกรณีนานกว่ามาก | Search Console Help, Page indexing report (ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026) | เอกสารทางการ |
| Google เจอ URL ใหม่ | ราว 20 ชั่วโมง (กรณีช้า หลายสัปดาห์หรือไม่เจอเลย) | Gary Illyes, Search Central Live Deep Dive (2 ต.ค. 2026) รายงานโดย Search Engine Roundtable (5 ต.ค. 2026) | รายงานมือสอง |
| Google กลับมา crawl หน้าเดิม | ราว 30 วัน (กรณีช้า หลายสัปดาห์หรือไม่กลับมาเลย) | แหล่งเดียวกับแถวบน | รายงานมือสอง |
| ขั้น index (ตั้งแต่ต้นจนจบ แยกจากขั้นเจอ URL และ crawl) | ราว 1.5 ชั่วโมง (กรณีช้า หลายเดือนหรือไม่ index เลย ส่วนใหญ่เป็นเรื่องคุณภาพ) | แหล่งเดียวกับแถวบน | รายงานมือสอง |
| Google ประมวลผล sitemap | ราว 24 ชั่วโมง (กรณีช้า ถึง 14 วัน หรือไม่ประมวลผลเลย) | แหล่งเดียวกับแถวบน | รายงานมือสอง |
| Google เปลี่ยน canonical ตามที่คุณแก้ | 1–3 สัปดาห์ | แหล่งเดียวกับแถวบน | รายงานมือสอง |
ตัวเลข “1.5 ชั่วโมง” คือส่วนที่คนอ่านผิดบ่อยที่สุด ตามรายงานของ Search Engine Roundtable (5 ต.ค. 2026) ตัวเลขนี้คือเวลาของขั้น index (ตั้งแต่ต้นจนจบ) ซึ่งรายงานแยกจากขั้นที่ Google ต้องเจอ URL (ราว 20 ชั่วโมงในกรณีปกติ) และขั้น crawl Illyes บอกว่าหน้าจะ index ได้ก็ต่อเมื่อถูก crawl แล้ว เวลาจึงต่อกันเป็นทอด ไม่ได้นับจากตอนที่คุณกดเผยแพร่หรือกดขอ index ทั้งสองรายงานไม่ได้บอกวิธีวัดหรือจำนวนตัวอย่าง ดังนั้นถ้าหน้าใหม่ยังไม่ติดภายในไม่กี่ชั่วโมง ยังไม่ใช่สัญญาณว่ามีปัญหา
สิ่งที่เราเห็นกับเว็บของเราเองอยู่ฝั่งเร็วของช่วงนี้ บทความ 6 ชิ้นแรกที่เราเผยแพร่วันที่ 3 ต.ค. 2026 ถูก index ครบทั้ง 6 ชิ้น ถูก crawl ภายในราว 1 วันหลังเผยแพร่ และเริ่มมี impressions (จำนวนครั้งที่หน้าขึ้นในผลค้นหา) ใน Search Console ภายใน 0–4 วัน (ชิ้นที่เร็วที่สุดคือ เรียน SEO ที่ไหนดี มี impression วันเดียวกับที่เผยแพร่) ข้อจำกัดคือ URL Inspection ไม่บอก “วันที่ index” และไม่เก็บประวัติ เราจึงใช้วันแรกที่มี impression เป็นตัวแทนวันที่หน้าเข้า index นี่คือ 6 หน้าของเว็บเดียว ไม่ใช่ค่าเฉลี่ย เว็บอื่นอาจใช้เวลานานกว่านี้ได้ตามตารางด้านบน (ข้อมูลจาก Search Console ตรวจ 16 ต.ค. 2026)
ทำไมเว็บไม่ติด Google: 10 สาเหตุที่เจอบ่อย
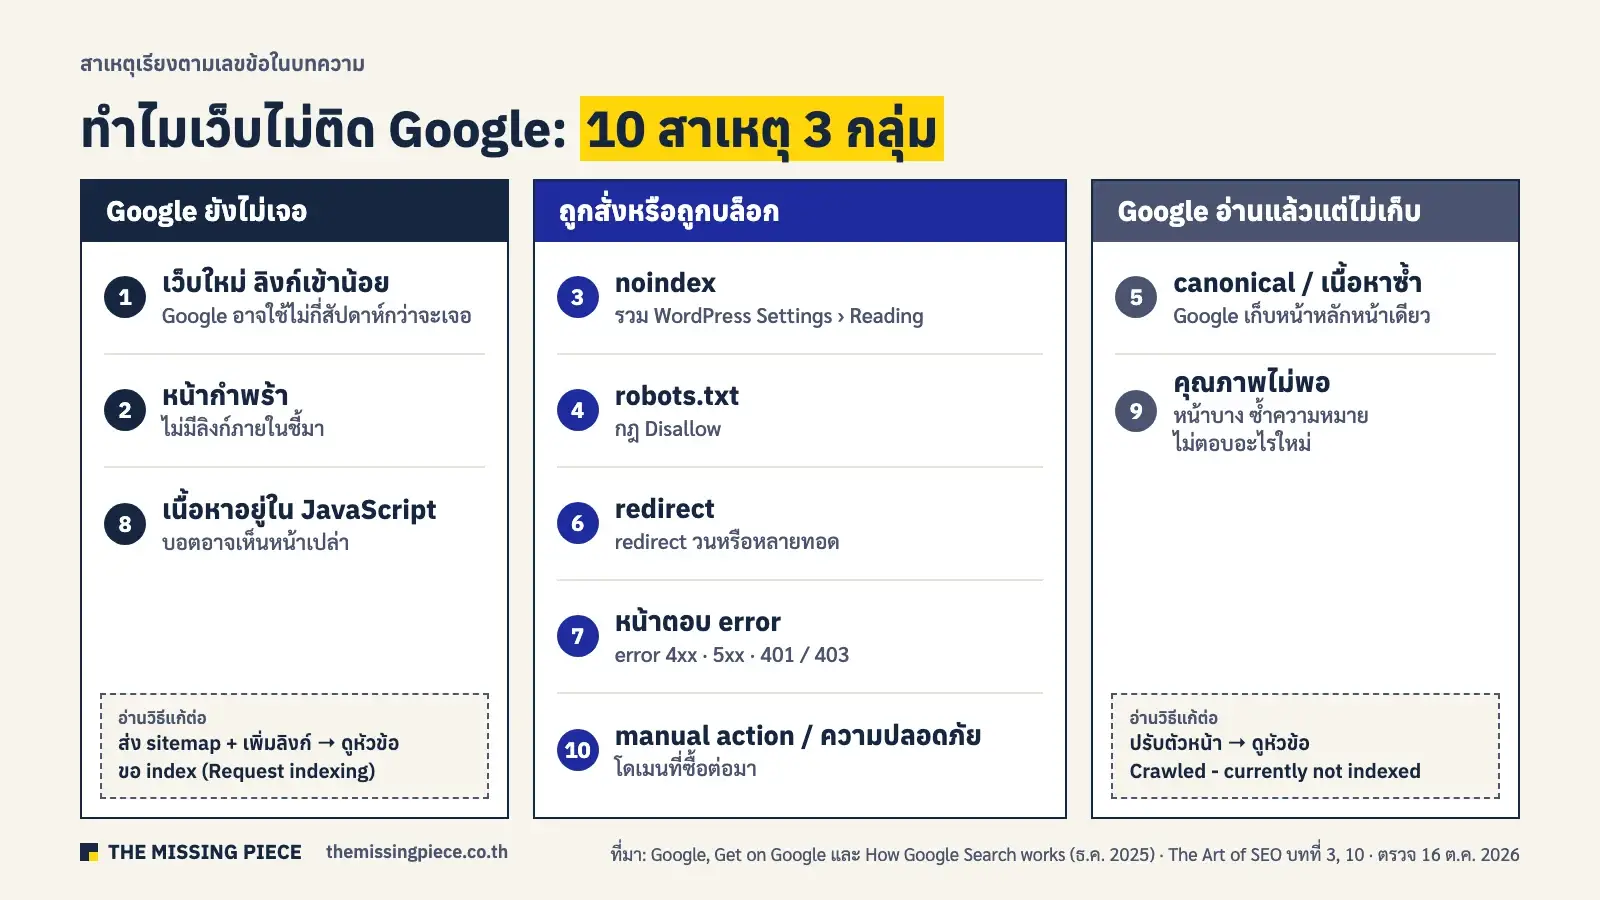
สาเหตุที่เว็บไม่ติด Google แบ่งได้เป็น 3 กลุ่ม คือ Google ยังไม่เจอหน้า Google เจอแต่ถูกสั่งหรือถูกบล็อกไม่ให้ index และ Google อ่านแล้วแต่เลือกไม่เก็บ สาเหตุ 10 ข้อด้านล่างเรียงจากที่เช็กง่ายไปยาก และแต่ละข้อมีลิงก์ไปบทความที่อธิบายวิธีแก้ละเอียด เอกสาร Get on Google (10 ธ.ค. 2025) และหน้าช่วยเหลือภาษาไทยของ Google เรื่องหน้าที่หายไปจากผลค้นหา ระบุสาเหตุส่วนใหญ่ชุดเดียวกันนี้
- เว็บใหม่และยังไม่มีลิงก์ชี้มา: Google บอกว่าเว็บใหม่อาจใช้ไม่กี่สัปดาห์กว่าจะถูกเจอ และเว็บที่มีลิงก์จากเว็บอื่นน้อยจะถูกเจอช้ากว่า ทางที่ทำได้คือเชื่อมเว็บกับ Search Console ส่ง sitemap และหาลิงก์จากหน้าที่ Google รู้จักอยู่แล้ว เช่น โปรไฟล์ธุรกิจหรือบทความของคุณบนเว็บอื่น
- หน้าไม่มีลิงก์ภายในชี้มา (orphan page): หน้าที่ไม่มีหน้าไหนในเว็บลิงก์ไปหา บอตหาเจอยาก The Art of SEO บทที่ 10 แนะนำให้เทียบรายการ URL ใน sitemap กับผลการ crawl เพื่อหาหน้ากำพร้า แล้วเพิ่มลิงก์จากหน้าที่เกี่ยวข้อง ดูวิธีวางลิงก์ที่ Internal Link คืออะไร
- ติด noindex โดยไม่รู้ตัว: meta robots หรือ header X-Robots-Tag ที่มีค่า noindex สั่งให้ Google ไม่เก็บหน้า ใน WordPress ให้เช็กเมนู Settings › Reading ว่าไม่ได้ติ๊ก “Discourage search engines from indexing this site” (มักเปิดค้างไว้ตั้งแต่ช่วงทำเว็บ) และเช็กค่าของปลั๊กอิน SEO รายหน้า อ่านต่อที่ Meta Tag คืออะไร
- robots.txt บล็อกไว้: กฎ Disallow ทำให้บอตเข้าอ่านหน้าไม่ได้ หน้าจึงไม่ถูก index หรือถ้ามีลิงก์จากที่อื่นมาก Google อาจ index แค่ URL โดยไม่มีคำอธิบาย ดูวิธีเขียนกฎที่ Robots.txt คืออะไร
- canonical ชี้ไปหน้าอื่น หรือเนื้อหาซ้ำ: Google เก็บแค่หน้าหลักของกลุ่มหน้าที่เหมือนกัน ถ้า canonical tag ชี้ผิด หรือหน้าคล้ายกันหลายหน้า (เช่น หน้าสินค้าที่ต่างแค่สี) Google จะเลือกเก็บหน้าเดียว อ่านต่อที่ Canonical Tag คืออะไร
- หน้า redirect ไปที่อื่น: URL ที่ redirect จะไม่ถูก index เอง Google จะ index ปลายทางแทน ถ้า redirect วนหรือยาวเป็นทอดๆ จะกลายเป็น Redirect error ดูวิธีทำ redirect ให้ถูกที่ 301 Redirect คืออะไร
- หน้าตอบ error หรือถูกบล็อกด้วยสิทธิ์: 404, soft 404 (หน้าว่างหรือหน้าแจ้งว่าไม่พบแต่ตอบ 200), 5xx และ 401/403 จาก firewall หรือระบบล็อกอิน ทำให้หน้าไม่ถูก index ดูเรื่อง 404 และ soft 404 ที่ Error 404 คืออะไร ส่วนเรื่อง 403 จะมีบทความแยกบนเว็บเรา
- เนื้อหาสำคัญมีแค่ใน JavaScript: ถ้าข้อความหลักหรือลิงก์ถูกสร้างหลังโหลดด้วย JavaScript บอตอาจเห็นหน้าเปล่า Google ระบุว่าเว็บที่ออกแบบให้ crawl ยากเป็นหนึ่งในเหตุผลที่ไม่ติด และ AI SEO For Dummies บทที่ 2 แนะนำให้เนื้อหาหลักอยู่ใน HTML ที่เซิร์ฟเวอร์ส่งมา
- คุณภาพหรือคุณค่าไม่พอ: เอกสาร How Google Search works ระบุว่าเนื้อหาคุณภาพต่ำเป็นปัญหา index ที่พบบ่อย หน้าบาง หน้าซ้ำความหมายกับหน้าอื่น หรือหน้าที่ไม่ตอบอะไรใหม่ มักค้างอยู่ที่สถานะ Crawled – currently not indexed ดูแนวทางที่ E-E-A-T คืออะไร และ วิธีเขียนบทความ SEO
- โดน manual action หรือปัญหาความปลอดภัย: หน้าช่วยเหลือภาษาไทยของ Google แนะนำให้เช็กรายงาน Manual actions และ Security issues ใน Search Console โดยเฉพาะเว็บหรือโดเมนที่เพิ่งซื้อต่อมา เพราะการลงโทษจากเจ้าของเดิมอาจยังอยู่
อ่านรายงาน Page indexing แล้วแก้ทีละสถานะ
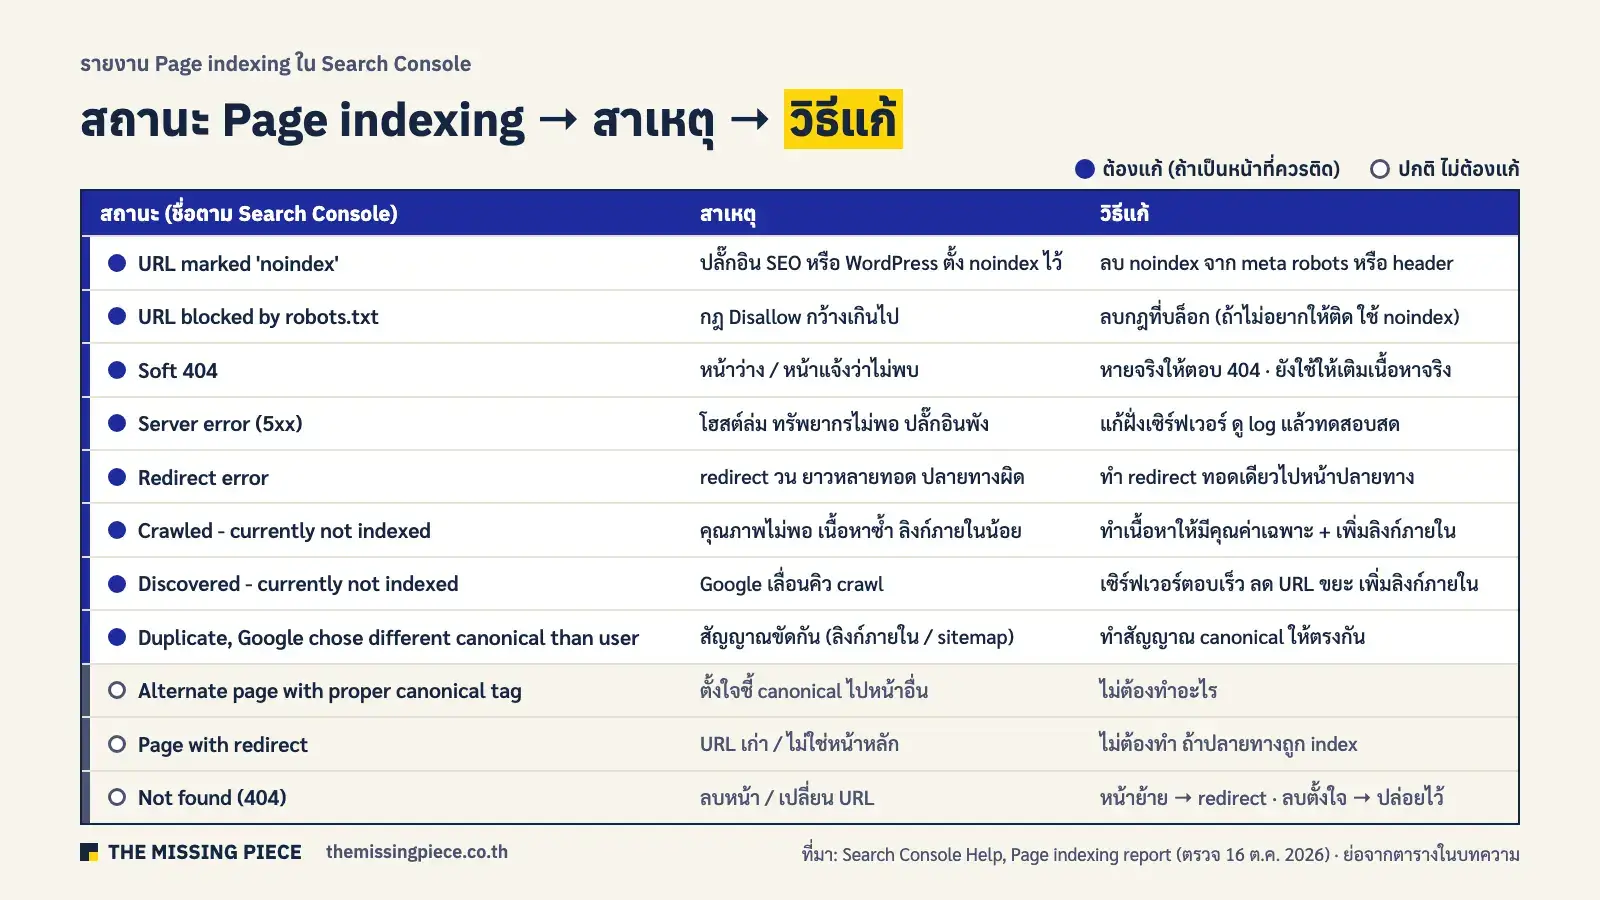
รายงาน Page indexing บอกเหตุผลที่หน้าไม่ถูก index เป็นชื่อสถานะภาษาอังกฤษที่ตายตัว แต่ละสถานะมีวิธีแก้ต่างกัน และบางสถานะเป็นเรื่องปกติที่ไม่ต้องทำอะไร ตารางนี้ใช้ชื่อสถานะตรงตามหน้า Page indexing report ของ Search Console Help (ตรวจ 16 ต.ค. 2026) คุณจึงก๊อปชื่อจากรายงานมาค้นในหน้านี้ได้ทันที
| สถานะในรายงาน | แปลว่า | สาเหตุที่พบบ่อย | วิธีแก้ | ต้องแก้ไหม |
|---|---|---|---|---|
| Server error (5xx) | เซิร์ฟเวอร์ตอบ error ตอน Googlebot มา | โฮสต์ล่ม ทรัพยากรไม่พอ ปลั๊กอินพัง | แก้ฝั่งเซิร์ฟเวอร์ ดู log ช่วงเวลาที่ล่ม แล้วทดสอบสดอีกครั้ง | แก้ ถ้าเป็นหน้าสำคัญ |
| Redirect error | redirect ใช้ไม่ได้ | redirect วน ยาวหลายทอด หรือปลายทางผิด | ทำ redirect ทอดเดียวไปหน้าที่ตอบ 200 (301 Redirect) | แก้ |
| URL blocked by robots.txt | robots.txt ห้ามบอตเข้า | กฎ Disallow กว้างเกินไป | ถ้าอยากให้ติด ลบกฎที่บล็อก ถ้าไม่อยากให้ติด ใช้ noindex แทน (Robots.txt) | แก้ ถ้าเป็นหน้าที่ต้องติด |
| URL marked ‘noindex’ | หน้าสั่งไม่ให้ index | ค่าปลั๊กอิน SEO หรือ WordPress ตั้ง noindex ไว้ | ลบ noindex จาก meta robots หรือ header (Meta Tag) | แก้ ถ้าตั้งผิด |
| Soft 404 | หน้าดูเหมือนไม่มีเนื้อหา แต่ตอบ 200 | หน้าว่าง หน้าค้นหาไม่พบสินค้า หน้าแจ้งว่าไม่พบ | หน้าที่หายจริงให้ตอบ 404 หรือ 410 หน้าที่ยังใช้ให้เติมเนื้อหาจริง (Error 404) | แก้ |
| Blocked due to unauthorized request (401) | ต้องล็อกอินก่อน | หน้าอยู่หลังระบบสมาชิกหรือรหัสผ่าน | หน้าที่ต้องการให้ติดต้องเปิดให้เข้าได้โดยไม่ล็อกอิน | แก้ ถ้าควรเป็นหน้าสาธารณะ |
| Not found (404) | ไม่พบหน้า | ลบหน้า เปลี่ยน URL หรือลิงก์สะกดผิด | ถ้าหน้าย้าย ทำ 301 ถ้าลบตั้งใจ ปล่อยไว้ได้ | ส่วนใหญ่ไม่ต้อง |
| Blocked due to access forbidden (403) | เซิร์ฟเวอร์ปฏิเสธ Googlebot | firewall, CDN หรือปลั๊กอินความปลอดภัยบล็อกบอต | เปิดให้ Googlebot ตัวจริงเข้าได้ (บทความ Error 403 กำลังจะขึ้นบนเว็บเรา) | แก้ |
| URL blocked due to other 4xx issue | error 4xx แบบอื่น | เช่น 410 หรือรหัส 4xx ที่ระบบตั้งเอง | เปิด URL Inspection ดูว่าเซิร์ฟเวอร์ตอบอะไร | แก้ ถ้าเป็นหน้าสำคัญ |
| Crawled – currently not indexed | Google อ่านแล้ว แต่ยังไม่เก็บ | คุณภาพหรือคุณค่าไม่พอ เนื้อหาซ้ำ ลิงก์ภายในน้อย | ปรับเนื้อหาให้มีคุณค่าเฉพาะ เพิ่มลิงก์ภายใน (ดู H3 ด้านล่าง) | แก้ ถ้าเป็นหน้าสำคัญ |
| Discovered – currently not indexed | Google รู้ว่ามี URL นี้ แต่ยังไม่ crawl | Google เลื่อนคิวเพราะคาดว่าเซิร์ฟเวอร์จะรับโหลดไม่ไหว URL คุณค่าต่ำมีมาก | ทำเซิร์ฟเวอร์ให้ตอบเร็ว ลด URL ขยะ เพิ่มลิงก์ภายใน (ดู H3 ด้านล่าง) | รอ หรือแก้ ถ้าค้างนาน |
| Alternate page with proper canonical tag | หน้านี้ชี้ canonical ไปหน้าอื่นที่ index แล้ว | ตั้งใจไว้ เช่น หน้าเวอร์ชัน AMP หรือ URL มีพารามิเตอร์ | ไม่ต้องทำอะไร | ไม่ต้อง |
| Duplicate without user-selected canonical | หน้าซ้ำกับหน้าอื่น และไม่ได้บอก canonical | หน้าหลายแบบมีเนื้อหาเดียวกัน | ถ้า Google เลือกหน้าหลักผิด ใส่ canonical ชี้หน้าที่ต้องการ หรือทำเนื้อหาให้ต่างกันจริง (Canonical Tag) | แก้ ถ้าเลือกผิด |
| Duplicate, Google chose different canonical than user | คุณบอก canonical แต่ Google เลือกหน้าอื่น | สัญญาณขัดกัน เช่น ลิงก์ภายในหรือ sitemap ชี้อีกหน้า | เทียบ canonical ที่ Google เลือกกับที่คุณตั้งใน URL Inspection แล้วทำสัญญาณให้ตรงกัน | แก้ ถ้าเลือกผิด |
| Page with redirect | URL นี้ redirect ไปที่อื่น | URL เก่าหรือ URL ไม่ใช่หน้าหลัก | ไม่ต้องทำ ถ้าปลายทางถูก index | ส่วนใหญ่ไม่ต้อง |
| Indexed, though blocked by robots.txt (คำเตือน) | index แล้ว ทั้งที่ robots.txt บล็อก | มีลิงก์ชี้มามาก Google จึงเก็บ URL ไว้โดยอ่านเนื้อหาไม่ได้ | ถ้าไม่อยากให้ติด ปลดบล็อกแล้วใส่ noindex ถ้าอยากให้ติด ปลดบล็อก | แก้ |
| Page indexed without content (คำเตือน) | index แล้ว แต่ Google อ่านเนื้อหาไม่ได้ | หน้าโหลดเนื้อหาไม่ขึ้น หรือถูกบล็อกบางส่วน | เปิด URL Inspection ดูส่วนที่ Google เห็น แล้วแก้ให้เนื้อหาโหลดได้ | แก้ |
Crawled – currently not indexed แก้ยังไง
Crawled – currently not indexed คือ Google อ่านหน้าแล้วแต่ยังเลือกไม่เก็บ Search Console Help บอกว่าหน้านี้อาจถูกหรือไม่ถูก index ในอนาคต และไม่ต้องส่ง URL ให้ crawl ซ้ำ สถานะนี้จึงไม่ได้แก้ด้วยการกด Request indexing แต่แก้ที่ตัวหน้า
- ถามตัวเองว่าหน้านี้ควรติดไหม: ถ้าเป็นหน้าแท็ก หน้าผลค้นหาภายใน หรือหน้าซ้ำ ปล่อยไว้ได้ ดูหัวข้อทุกหน้าต้องติด index ไหม
- เทียบกับหน้าที่ติดแล้วในเว็บเดียวกัน: ถ้าสองหน้าตอบคำถามเดียวกัน รวมเป็นหน้าเดียวแล้ว 301 อีกหน้า ดีกว่าปล่อยให้ Google เลือกเอง
- เติมสิ่งที่หน้าอื่นไม่มี: ข้อมูลจริง ตัวเลขที่มีที่มา ตาราง ตัวอย่าง หรือประสบการณ์ตรง แทนการเรียบเรียงซ้ำจากบทความอื่น
- เพิ่มลิงก์ภายในจากหน้าที่ติดแล้วและเกี่ยวข้อง: เป็นสัญญาณว่าหน้านี้สำคัญต่อเว็บ AI SEO For Dummies บทที่ 11 แนะนำโครงลิงก์แบบ hub-and-spoke คือหน้าหลักของหัวข้อลิงก์ไปหน้าย่อย และหน้าย่อยลิงก์กลับ
- เช็กว่าเนื้อหาหลักอยู่ใน HTML: เปิด URL Inspection › View crawled page ดูว่า Google เห็นข้อความหลักครบ
The Art of SEO บทที่ 7 แนะนำให้ดูหน้าในสถานะนี้เป็นประจำ และพูดถึงแนวคิด “งบการ index” ที่ Google ไม่ได้ยืนยัน หนังสือเองก็บอกไว้แบบนั้น เราจึงไม่ใช้แนวคิดนี้เป็นเหตุผลหลัก สิ่งที่ยืนยันได้จากเอกสาร Google คือเนื้อหาคุณภาพต่ำเป็นปัญหา index ที่พบบ่อย
Discovered – currently not indexed ต่างกันยังไง แก้ยังไง
Discovered – currently not indexed คือ Google รู้ว่ามี URL นี้แล้ว (เช่น จาก sitemap หรือลิงก์) แต่ยังไม่ได้ crawl ต่างจาก Crawled ตรงที่ Google ยังไม่ได้อ่านเนื้อหาเลย Search Console Help อธิบายว่าบ่อยครั้ง Google ตั้งใจ crawl แต่เลื่อนออกไปเพราะคาดว่าเว็บจะรับโหลดไม่ไหว
- เว็บใหม่หรือเพิ่งส่ง sitemap: สถานะนี้เป็นเรื่องปกติในช่วงแรก รอตามตารางเวลาด้านบนก่อน
- เซิร์ฟเวอร์ตอบช้าหรือ error บ่อย: ดูรายงาน Crawl stats ใน Search Console ว่ามีช่วงที่ตอบช้าหรือ 5xx ไหม แล้วแก้ที่โฮสต์ เรื่องความเร็วหน้าเว็บสำหรับผู้ใช้ (Core Web Vitals) เป็นอีกเรื่องหนึ่ง Google ไม่ได้ระบุว่าเป็นสาเหตุของสถานะนี้
- เว็บมี URL คุณค่าต่ำจำนวนมาก: เช่น URL ตัวกรองหรือพารามิเตอร์ที่สร้างหน้าไม่สิ้นสุด ให้ลดลิงก์ไปหา URL เหล่านี้และใช้ canonical ให้ถูก
- หน้าอยู่ลึกเกินไป: หน้าช่วยเหลือภาษาไทยของ Google แนะนำให้ทุกหน้าเข้าถึงได้ด้วยการคลิกลิงก์ต่อกันจากหน้าแรก จึงควรเพิ่มลิงก์ภายในให้หน้าสำคัญไม่อยู่ลึกเกินไป
ตัวอย่างจากเว็บของเรา หน้า เรียน AI Search ฟรี ซึ่งตอนนั้นมีลิงก์เข้าน้อย ขึ้นสถานะ Discovered – currently not indexed เมื่อเช้าวันที่ 6 ต.ค. 2026 วันเดียวกันหน้านี้อยู่ในรายการที่เรากด Request indexing Google crawl หน้าในวันที่ 6 ต.ค. (เวลา UTC) และวันที่ 7 ต.ค. สถานะเป็น Submitted and indexed ผลนี้สอดคล้องกับการกดขอ index แต่พิสูจน์ไม่ได้ว่าเป็นเพราะการกด เพราะเราไม่ได้บันทึกเวลาที่กดจริง หลังจากนั้นหน้านี้ถูกอ้างใน Google AI Overview ครั้งแรกวันที่ 12 ต.ค. 2026 (เป็นคำตอบตัวอย่างจากการติดตามคำถามรายวันของเรา ไม่ใช่อัตรา)
อยากให้การเช็กสถานะ index ของหน้าสำคัญทำงานเองทุกสัปดาห์: คอร์สเรียน SEO & AI Search สอนสด 2 วันด้วย Claude Code (จ. 21 – อ. 22 ธ.ค. 2026) สร้าง agent ที่วัดว่า ChatGPT กับ Gemini พูดถึงแบรนด์คุณไหม แล้วทำงานกับเว็บของคุณต่อทุกสัปดาห์
ขอ index (Request indexing) ยังไง และไม่ควรทำอะไร
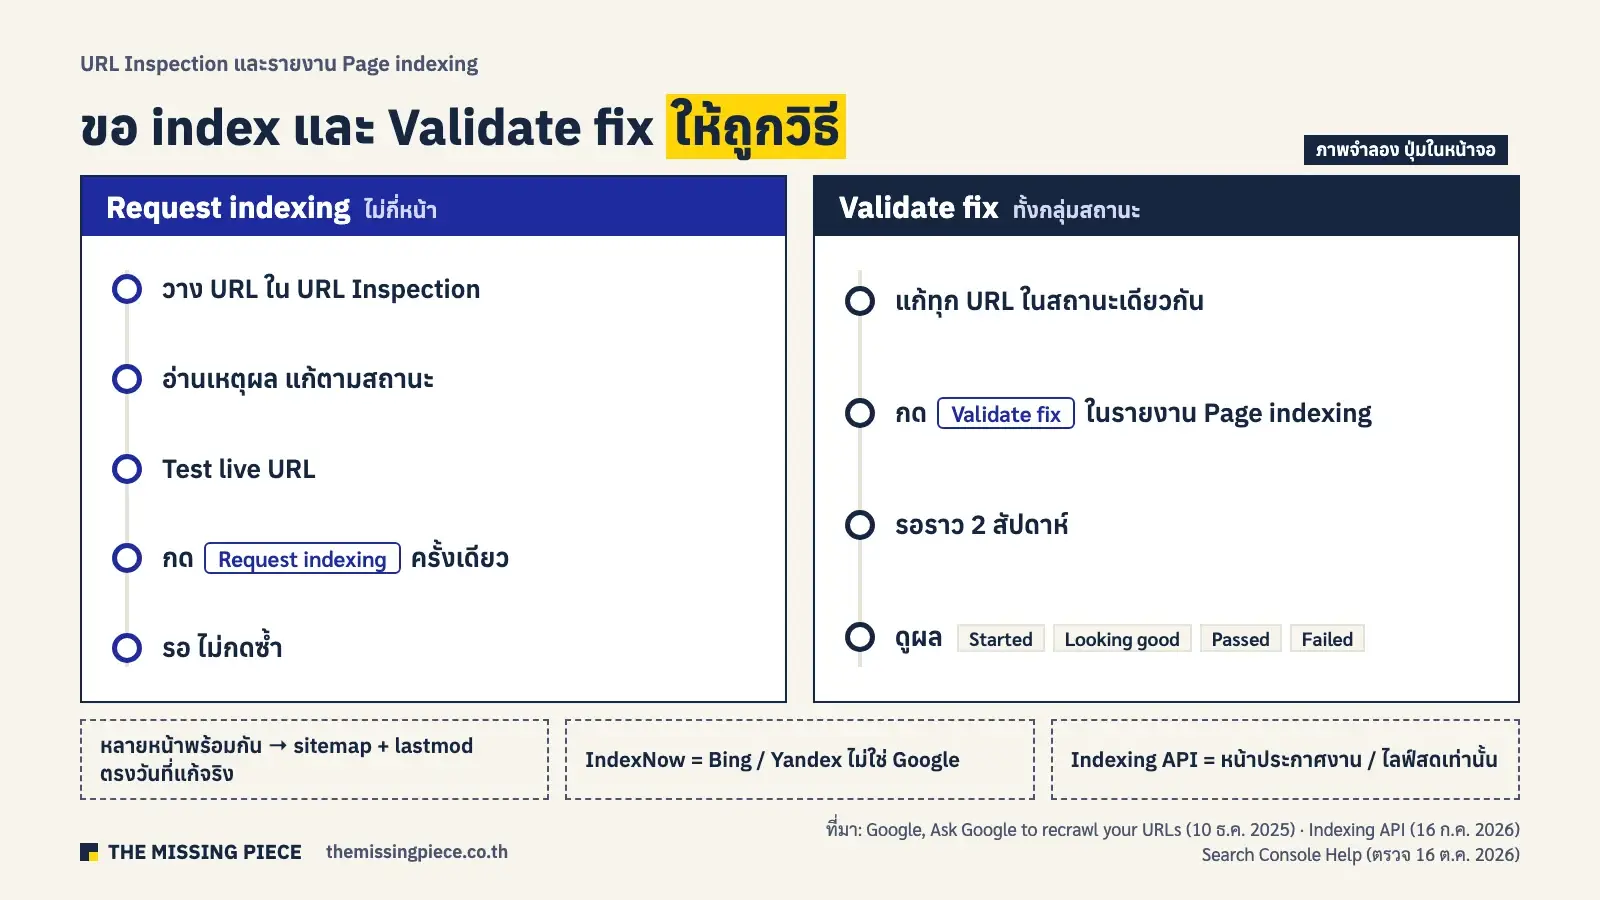
Request indexing คือปุ่มใน URL Inspection ที่ขอให้ Google crawl หน้านั้นใหม่ เหมาะกับหน้าใหม่หรือหน้าที่เพิ่งแก้ครั้งใหญ่ไม่กี่หน้า เอกสาร Ask Google to recrawl your URLs (ปรับล่าสุด 10 ธ.ค. 2025) บอกให้ใช้ URL Inspection เมื่อมีไม่กี่ URL และใช้ sitemap เมื่อมีหลาย URL โดยการขอไม่ได้รับประกันว่าจะ index
- เปิด Search Console วาง URL เต็มในช่องค้นด้านบน
- รอผล ถ้าขึ้น URL is not on Google ให้อ่านเหตุผลก่อน และแก้ตามตารางสถานะ ถ้ายังไม่ได้แก้ กดขอไปก็ได้ผลเดิม
- กด Test live URL เพื่อดูว่า Googlebot เข้าหน้าได้และเห็นเนื้อหาครบ
- กด Request indexing แล้วรอ ระบบจะแจ้งว่ารับคำขอแล้ว
- กลับมาเช็กด้วย URL Inspection หลังผ่านไปอย่างน้อย 1 วัน (Google บอกว่าปกติราว 1 วัน และอาจนานถึง 1–2 สัปดาห์) ไม่ต้องกดซ้ำระหว่างรอ
กด Request indexing ได้วันละกี่ครั้ง
Google บอกว่ามีโควตาการส่ง URL ต่อวัน แต่ไม่บอกตัวเลข Search Console Help เขียนว่ามีขีดจำกัดรายวัน และเอกสาร recrawl บอกว่าการขอซ้ำหลายครั้งไม่ทำให้ crawl เร็วขึ้น เราเองกดจนเต็มโควตาเมื่อ 15 ต.ค. 2026 ในวันที่มีบทความใหม่และบทความที่แก้หลายหน้าพร้อมกัน หลังจากนั้นเราวางแผนไว้ราว 10 URL ต่อวัน (ตัวเลขนี้เป็นแผนของเรา ไม่ใช่ตัวเลขจาก Google) และเรียงลำดับดังนี้
- หน้าใหม่ที่สำคัญต่อธุรกิจก่อน แล้วค่อยเป็นหน้าที่แก้เนื้อหาครั้งใหญ่
- หน้าที่แก้แค่คำผิดหรือรูป ไม่ต้องกด ปล่อยให้ Google มา crawl ตามรอบ
- หน้าจำนวนมากพร้อมกัน (เช่น ย้ายเว็บ) ใช้ sitemap ที่อัปเดตค่า lastmod (วันที่แก้ล่าสุดในไฟล์ sitemap) ให้ตรงกับวันที่แก้จริง แทนการกดทีละหน้า
sitemap, IndexNow และ Indexing API ช่วยได้แค่ไหน
- XML sitemap: ช่วยให้ Google เจอ URL แต่เอกสาร Sitemaps overview (ปรับล่าสุด 10 ธ.ค. 2025) บอกว่าไม่รับประกันว่าทุก URL ใน sitemap จะถูก crawl และ index และเว็บที่มีหน้าสำคัญไม่เกินราว 500 หน้าที่ลิงก์ภายในดีอาจไม่ต้องใช้ sitemap ด้วยซ้ำ ส่ง sitemap ผ่าน Search Console หรือใส่บรรทัด Sitemap: ใน robots.txt ดูวิธีทำที่ Sitemap คืออะไร
- “ping” sitemap: วิธีส่ง sitemap ผ่าน URL ping ที่บทความเก่ายังแนะนำ Google ประกาศเลิกใช้ในบล็อก Search Central เมื่อ 26 มิ.ย. 2023 และปลายทางหยุดทำงานภายใน 6 เดือนหลังประกาศ ปัจจุบันเหลือการส่งผ่าน Search Console และ robots.txt
- IndexNow: โปรโตคอลแจ้ง URL ใหม่ที่ Bing และ Yandex เริ่มใช้ในปี 2021 The Art of SEO บทที่ 7 บอกว่าตอนนั้น Google กำลังทดสอบ แต่รายชื่อ search engine ที่รับ IndexNow บน indexnow.org (เช็ก 16 ต.ค. 2026) ยังไม่มี Google ใช้ได้ถ้าคุณอยากให้ Bing เห็นเร็ว แต่ไม่ช่วยเรื่อง Google Index
- Google Indexing API: เอกสาร Indexing API (ปรับล่าสุด 16 ก.ค. 2026) ระบุว่าใช้ได้กับหน้าที่มี JobPosting หรือ BroadcastEvent ใน VideoObject เท่านั้น คือหน้าประกาศงานและหน้าไลฟ์สด ไม่ใช่เครื่องมือเร่ง index บทความหรือหน้าสินค้า
อีกคำแนะนำที่เห็นบ่อยในบทความไทยคือ “แชร์ลิงก์ลงโซเชียลหรือเว็บบอร์ดเพื่อให้ติดเร็ว” วิธีนี้ไม่มีเอกสาร Google รองรับ ทางที่ Google เขียนไว้คือลิงก์จากหน้าที่ index แล้ว sitemap และ URL Inspection
แก้แล้วกด Validate fix ต้องรอนานไหม
Validate fix คือปุ่มในรายงาน Page indexing ที่บอก Google ว่าคุณแก้ปัญหาของสถานะนั้นแล้ว ให้ตรวจทุก URL ในกลุ่มอีกครั้ง ใช้หลังแก้ต้นเหตุที่กระทบหลายหน้า เช่น ลบ noindex ที่ตั้งผิดทั้งหมวด Search Console Help บอกว่าการตรวจมักใช้เวลาไม่เกินราว 2 สัปดาห์ แต่บางกรณีนานกว่ามาก
- แก้ให้ครบทุกหน้าก่อนกด: Search Console Help บอกว่าถ้าแก้ไม่ครบ การตรวจจะหยุดทันทีที่ Google เจอ URL ที่ยังมีปัญหา
- ดูสถานะระหว่างรอ: Started, Looking good, Passed หรือ Failed ถ้า Failed ให้เปิดรายการ URL ที่ยังไม่ผ่าน
- สถานะที่ไม่ต้องแก้ ไม่ต้องกด: เช่น Alternate page with proper canonical tag หรือ Page with redirect
- ติดตามผลต่อ: หลัง Passed ดูรายงาน Performance ว่าหน้าที่แก้เริ่มมี impressions ไหม
ทุกหน้าต้องติด index ไหม
ไม่ใช่ทุกหน้าต้องติด Google Index หน้าที่ควรติดคือหน้าที่คนค้นหาแล้วได้ประโยชน์ เช่น หน้าบริการ หน้าสินค้า และบทความ รายงาน Page indexing ของ Google เขียนชัดว่าอย่าคาดหวังให้ทุก URL ในเว็บถูก index เพราะควรถูก index แค่หน้า canonical (หน้าหลักของแต่ละกลุ่ม)
หน้าที่ไม่ติดได้โดยไม่เสียอะไร เช่น หน้าแท็ก หน้าผลค้นหาภายในเว็บ URL ตัวกรองสินค้า หน้าขอบคุณหลังส่งฟอร์ม และหน้าตะกร้าสินค้า ถ้าต้องการกันหน้าออกจาก index ให้ใช้ noindex ไม่ใช่ robots.txt The Art of SEO บทที่ 7 อธิบายว่า Disallow ใน robots.txt ไม่ได้ลบหน้าออกจาก index ส่วน noindex ลบได้ และ Google ต้อง crawl หน้าได้จึงจะเห็น noindex ดังนั้นห้ามใช้ทั้งสองอย่างกับหน้าเดียวกัน
ติด index แล้ว แต่ทำไมยังไม่มีใครเห็น
หน้าที่ติด Google Index แล้วยังไม่มีคนเห็นได้ เพราะการ index แค่ทำให้หน้ามีสิทธิ์แสดง ส่วนการถูกแสดงขึ้นกับว่าหน้าตอบคำค้นได้ดีกว่าหน้าอื่นไหม ถ้า URL Inspection ขึ้น URL is on Google แต่รายงาน Performance ยังมี impressions เป็น 0 ปัญหาไม่ใช่เรื่อง index แล้ว
- ลองค้นด้วยชื่อหน้าหรือประโยคเฉพาะในหน้า: ถ้าเจอ แปลว่าติดแล้ว แค่ยังไม่มีอันดับในคำที่คุณต้องการ
- เช็กว่าหน้าตรงกับเจตนาการค้นหา: คนที่ค้นคำนั้นต้องการคำตอบแบบไหน อ่านต่อที่ Search Intent คืออะไร
- เช็กภาพรวมทั้งเว็บ: ถ้าหลายหน้ามีอาการเดียวกัน ให้ตรวจทั้งเว็บตาม SEO Audit คืออะไร
ไม่ติด Google แล้วจะติด AI Search ไหม
หน้าที่ไม่ติด Google Index จะไม่ถูกใช้เป็นลิงก์อ้างอิงใน AI Overviews และ AI Mode ของ Google เอกสาร AI features and your website (ปรับล่าสุด 10 ธ.ค. 2025) ระบุว่าหน้าที่จะเป็นลิงก์อ้างอิงต้อง “ถูก index และแสดงในผลค้นหาพร้อม snippet ได้” (snippet คือข้อความตัวอย่างใต้ลิงก์) และไม่มีข้อกำหนดทางเทคนิคเพิ่ม ไม่ต้องมีไฟล์หรือ schema พิเศษ คำสั่ง noindex, nosnippet และ robots.txt จึงมีผลกับ AI ของ Google ด้วย ดูวิธีทำให้ถูกเลือกต่อที่ AI Overviews คืออะไร และ Google AI Mode คืออะไร
AI แชตบอตอย่าง ChatGPT และ Perplexity มีบอตค้นหาของตัวเอง การติด Google Index จึงไม่ใช่เงื่อนไขเดียวที่ทำให้ถูกอ้าง เช่น OAI-SearchBot และ PerplexityBot หน้าหนึ่งจึงอาจติดใน AI ตัวหนึ่งแต่ไม่ติดอีกตัวได้ ถ้าคุณบล็อกบอตเหล่านี้ใน robots.txt หรือ firewall หน้าก็จะไม่ถูกอ้างแม้ติด Google แล้ว เช็กว่าบอตไหนควรเปิดที่ Robots.txt สำหรับบอต AI และดูวิธีทำให้ AI แชตบอตอ้างถึงที่ ChatGPT SEO กับ Perplexity คืออะไร
AI SEO For Dummies บทที่ 10 วางการตรวจความพร้อมสำหรับ AI โดยเริ่มจากเรื่องเดียวกับบทความนี้ คือบอตเข้าได้ไหม ติด robots หรือ noindex ไหม canonical ถูกไหม มีหน้า soft 404 ไหม และหน้าทำเงินต้องตอบ 200 สม่ำเสมอ ส่วนบทที่ 22 เตือนว่าการบล็อกบอต AI แบบเหมารวมไม่ใช่ทางเลือกที่ฉลาดเสมอไป ถ้าเว็บยังไม่ติด Google ให้แก้ตรงนี้ก่อน เพราะเป็นประตูแรกของ “เปิดบ้านรับบอต” ใน AI-Ready Website ด้วย และเป็นฐานของ AI Search คืออะไร
AI ตอบเรื่อง Google Index ยังไง (และผิดตรงไหน)
เราถามคำถามเรื่อง index 4 ข้อกับ 3 แพลตฟอร์มเมื่อ 16 ต.ค. 2026 (ครั้งเดียวต่อคำถามต่อแพลตฟอร์ม ผลเบื้องต้น) ได้แก่ Google AI Overviews บนมือถือ (ขึ้น 3 จาก 4 คำถาม) ChatGPT (ค้นเว็บ) และ Perplexity ผ่าน API ผลที่เห็นมีดังนี้
- ChatGPT (ค้นเว็บ) อ้างเฉพาะเอกสารของ Google ใน 4 จาก 4 คำตอบ ไม่มีแหล่งอื่นเลย
- Perplexity ผ่าน API ส่วนใหญ่อ้างบทความภาษาอังกฤษ แม้ถามเป็นภาษาไทย และอ้างหน้าช่วยเหลือภาษาไทยของ Google 2 หน้า
- AI Overview ของคำว่า “crawled – currently not indexed แก้ยังไง” ไม่มีบทความภาษาไทยเลย มีแค่เอกสาร Google ฉบับภาษาไทย 1 หน้า ที่เหลือเป็นแหล่งภาษาอังกฤษ เวียดนาม ฮีบรู และจีน
AI ตอบผิดตรงไหน (16 ต.ค. 2026, n=1):
- AI Overview บอกว่าขอ index ใช้เวลา “ไม่กี่ชั่วโมงจนถึง 1.5 ชั่วโมง” ซึ่งอ่านตัวเลขของ Gary Illyes ผิด ตัวเลข 1.5 ชั่วโมงเป็นเวลาของขั้น index เท่านั้น ยังไม่รวมเวลาที่ Google ต้องเจอ URL และ crawl ก่อน จึงไม่ใช่เวลานับจากตอนกดขอ ดูตารางเวลา
- คำตอบเดียวกันยกโดเมนหลักเป็นที่อยู่ของ sitemap ที่จริงต้องเป็น URL ของไฟล์ sitemap
- AI Overview แนะนำให้แก้ Core Web Vitals และใส่ noindex ให้หน้าแท็กเพื่อ “ประหยัดโควตา crawl” สำหรับสถานะ Crawled – currently not indexed เอกสาร Google ไม่ได้ระบุความเร็วหน้าเป็นสาเหตุของสถานะนี้ และ noindex ไม่ได้ลด crawl เพราะ Google ต้อง crawl จึงจะเห็น noindex
- บางคำตอบอ้างบทความเก่าที่ยังแนะนำ ping sitemap และคำสั่ง cache: ซึ่ง Google เลิกใช้ไปแล้วทั้งคู่
เช็กลิสต์ 10 นาทีเมื่อหน้าไม่ติด Google
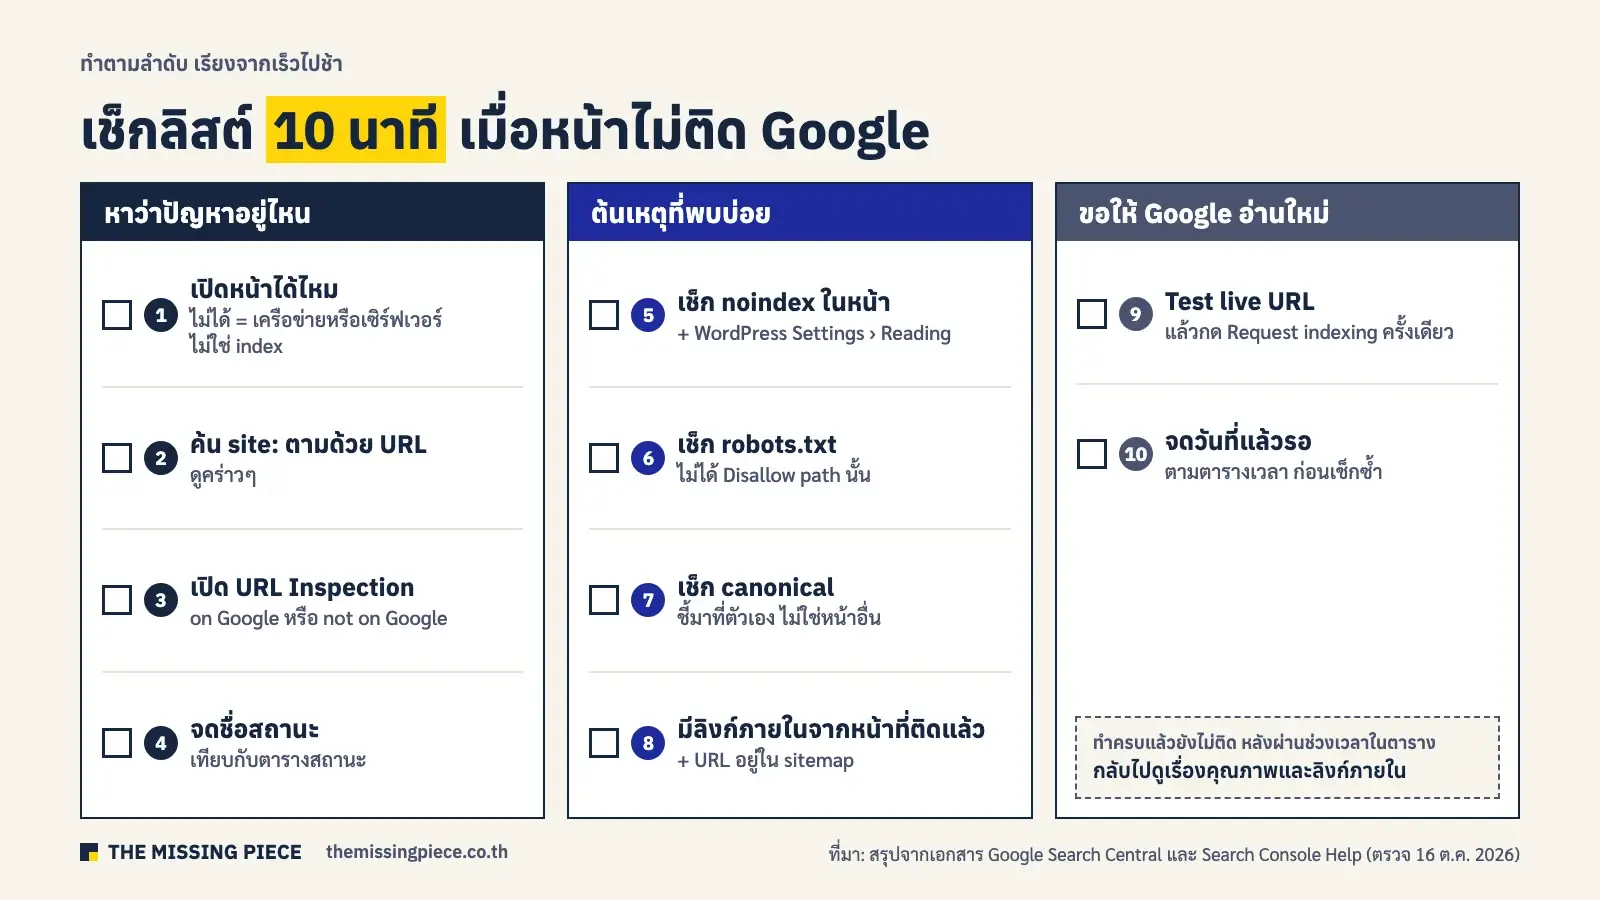
เช็กลิสต์นี้คือลำดับที่ใช้ได้ทุกครั้งที่หน้าไม่ติด Google เรียงจากเร็วไปช้า ใช้ได้ทั้งเจ้าของเว็บและคนทำ SEO & AI Search ถ้าทำครบแล้วยังไม่ติดหลังผ่านช่วงเวลาในตาราง ให้กลับไปดูสาเหตุเรื่องคุณภาพและลิงก์ภายใน
- เปิดหน้าในเบราว์เซอร์ได้ปกติไหม (ถ้าไม่ได้ เป็นปัญหาเครือข่ายหรือเซิร์ฟเวอร์ ไม่ใช่ index)
- ค้น
site:ตามด้วย URL ดูคร่าวๆ - เปิด URL Inspection อ่านว่า on Google หรือ not on Google
- ถ้า not on Google จดชื่อสถานะ แล้วเทียบกับตารางสถานะ
- เช็ก noindex ในหน้าและในค่า WordPress (Settings › Reading)
- เช็ก robots.txt ว่าไม่ได้ Disallow path นั้น
- เช็ก canonical ว่าชี้มาที่ตัวเอง ไม่ใช่หน้าอื่น
- เช็กว่ามีลิงก์ภายในจากหน้าที่ติดแล้วอย่างน้อย 1–2 ลิงก์ และ URL อยู่ใน sitemap
- Test live URL ดูว่า Googlebot เห็นเนื้อหาครบ แล้วกด Request indexing ครั้งเดียว
- จดวันที่ แล้วรอตามตารางเวลา ก่อนเช็กซ้ำ
Google Index เป็นงานหนึ่งของ Technical SEO ร่วมกับ sitemap, robots.txt, canonical, redirect, error 404 และเรื่องที่ยังไม่มีบทความแยกบนเว็บเรา เช่น Core Web Vitals และ HTTPS ดูภาพรวมทั้งหมดได้ที่ Technical SEO คืออะไร
บทความนี้เขียนโดยทีม The Missing Piece จากเอกสารทางการของ Google ข้อมูลที่เราสังเกตจากผลค้นหาและคำตอบ AI และประสบการณ์ดูแลเว็บของเราเอง
คำถามที่พบบ่อย
index กับ crawl ต่างกันยังไง
crawl คือการที่บอตของ Google เข้ามาอ่านหน้า ส่วน index คือการที่ Google วิเคราะห์แล้วเลือกเก็บหน้านั้นไว้ในฐานข้อมูล หน้าที่ถูก crawl แล้วอาจไม่ถูก index เช่น สถานะ Crawled – currently not indexed
เว็บใหม่ไม่ขึ้น Google ต้องรอกี่วัน
Google บอกว่าเว็บใหม่อาจใช้ไม่กี่สัปดาห์กว่าจะถูกเจอ (เอกสาร Get on Google, 10 ธ.ค. 2025) และหน้าช่วยเหลือภาษาไทยแนะนำให้รออย่างน้อย 1 สัปดาห์หลังส่ง sitemap หรือขอ index ก่อนสรุปว่าหน้าหาย ระหว่างรอ ให้เชื่อม Search Console ส่ง sitemap และลิงก์หน้าใหม่จากหน้าที่ติดแล้ว
กด Request indexing ได้วันละกี่ครั้ง
Google บอกว่ามีขีดจำกัดรายวันแต่ไม่บอกตัวเลข และการกดซ้ำไม่ทำให้ crawl เร็วขึ้น ให้กดเฉพาะหน้าใหม่หรือหน้าที่แก้ครั้งใหญ่ ถ้ามีหลายหน้าให้ใช้ sitemap แทน
Crawled กับ Discovered – currently not indexed ต่างกันยังไง
Crawled คือ Google อ่านหน้าแล้วแต่ยังไม่เก็บ มักเป็นเรื่องคุณภาพหรือเนื้อหาซ้ำ Discovered คือ Google รู้ว่ามี URL แต่ยังไม่ได้อ่าน มักเป็นเพราะเลื่อนคิว crawl สองสถานะนี้จึงแก้คนละที่
ส่ง sitemap แล้วทำไมหน้ายังไม่ติด Google
เพราะ sitemap แค่ช่วยให้ Google เจอ URL ไม่ได้รับประกันการ index (เอกสาร Sitemaps overview, 10 ธ.ค. 2025) ให้เปิด URL Inspection ดูชื่อสถานะของหน้านั้น แล้วแก้ตามสาเหตุ
หน้าไม่ถูก index จะขึ้นใน ChatGPT ได้ไหม
อาจได้ เพราะ ChatGPT ค้นเว็บด้วยบอตของตัวเอง (OAI-SearchBot) และ OpenAI ระบุว่าหน้าที่บล็อกบอตนี้จะไม่ถูกแสดงในคำตอบค้นเว็บของ ChatGPT แต่ AI Overviews และ AI Mode ของ Google ใช้ได้เฉพาะหน้าที่ index แล้วและแสดง snippet ได้
แหล่งอ้างอิง
- Google Search Central, In-depth guide to how Google Search works (last updated 2025-12-18: crawl, index, serve · ไม่รับประกันการ crawl, index หรือแสดง · ปัญหา index ที่พบบ่อย · การเลือก canonical)
- Google Search Central, Get on Google (last updated 2025-12-10: เช็กด้วย site:, เว็บใหม่อาจใช้ไม่กี่สัปดาห์, เหตุผลที่ไม่ถูกเจอ)
- Google Search Central, Ask Google to recrawl your URLs (last updated 2025-12-10: มีโควตาการส่ง URL, ไม่กี่วันถึงไม่กี่สัปดาห์, ขอซ้ำไม่เร็วขึ้น)
- Search Console Help, URL Inspection tool (ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026: ผล URL is on Google / not on Google, การทดสอบสดไม่ได้เช็กทุกอย่าง, ขีดจำกัดรายวันของคำขอ index)
- Search Console Help, Page indexing report (ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026: ชื่อสถานะทั้งหมดในตาราง, อย่าคาดหวังให้ทุก URL ถูก index, Validate fix ราว 2 สัปดาห์)
- Search Console Help ภาษาไทย, ทำไมหน้าเว็บของฉันจึงหายไปจาก Google Search (ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026: รออย่างน้อย 1 สัปดาห์, เช็ก manual action และความปลอดภัย, ทุกหน้าต้องเข้าถึงได้ด้วยลิงก์จากหน้าแรก)
- Search Console Help ภาษาไทย, ไม่มีข้อมูลหน้าเว็บในผลการค้นหา (ไม่มีวันที่บนหน้า ตรวจ 16 ต.ค. 2026: หน้าที่ robots.txt บล็อกอาจขึ้นแค่ URL, ต้องปลดบล็อกให้ Google เห็น noindex)
- Google Search Central, Learn about sitemaps (last updated 2025-12-10: ไม่รับประกันการ crawl และ index, เว็บราว 500 หน้าที่ลิงก์ดีอาจไม่ต้องใช้)
- Google Search Central Blog, Sitemaps ping endpoint is going away (มิ.ย. 2023)
- Search Engine Land, Google Search officially retires cache link (ก.พ. 2024, Danny Sullivan ยืนยัน) · Google Search completely kills the cache feature (ก.ย. 2024)
- OpenAI, Overview of OpenAI Crawlers (ตรวจ 16 ต.ค. 2026: OAI-SearchBot ใช้แสดงเว็บในการค้นของ ChatGPT, หน้าที่บล็อกจะไม่ถูกแสดง)
- Google Search Central, Indexing API Quickstart (last updated 2026-07-16: ใช้ได้กับหน้า JobPosting หรือ BroadcastEvent ใน VideoObject เท่านั้น)
- Google Search Central, AI features and your website (last updated 2025-12-10: ลิงก์อ้างอิงใน AI Overviews/AI Mode ต้องถูก index และแสดงพร้อม snippet ได้, ไม่มีข้อกำหนดเพิ่ม)
- IndexNow, รายชื่อ search engine ที่รับ IndexNow (เช็ก 16 ต.ค. 2026: ไม่มี Google)
- Search Engine Roundtable, ตัวเลขเวลา crawl, index และ serve จาก Gary Illyes (5 ต.ค. 2026, รายงานมือสองจากงาน Search Central Live Deep Dive 2 ต.ค. 2026) · รายงานเดียวกันโดย Search Engine Journal (4 ต.ค. 2026 · ระบุว่าไม่มีนิยาม “ปกติ” จำนวนตัวอย่าง หรือช่วงเวลาที่วัด) · วันงาน 30 ก.ย.–2 ต.ค. 2026 ที่บาร์เซโลนา ตัวเลขนำเสนอวันที่ 2 ต.ค.: PPC Land (3 ต.ค. 2026)
- ข้อมูลของ The Missing Piece: ผลค้นหาบนมือถือของคำ “ทำไมเว็บไม่ขึ้น google แก้ยังไง” และคำตอบของ Google AI Overviews, ChatGPT (ค้นเว็บ) และ Perplexity ผ่าน API สำหรับ 4 คำถาม (16 ต.ค. 2026 ครั้งเดียวต่อคำถามต่อแพลตฟอร์ม ผลเบื้องต้น) · สถานะ index ของบทความ 6 ชิ้นที่เผยแพร่ 3 ต.ค. 2026 และหน้า /learn/ai-search/ จาก URL Inspection API และรายงาน Performance ของ Search Console (ตรวจ 16 ต.ค. 2026 · ใช้วันแรกที่มี impression แทนวันที่ index เพราะ API ไม่มีวันที่ index และไม่เก็บประวัติ) · การติดตามคำตอบ Google AI Overview รายวัน (คำตอบตัวอย่าง ไม่ใช่อัตรา)
- Nathan Gotch, AI SEO For Dummies (Wiley, 2026), บทที่ 2 (crawl, index, จัดอันดับ, จัดอันดับใหม่ · เนื้อหาหลักควรอยู่ใน HTML) · บทที่ 10 (ตรวจความพร้อม: การเข้าถึง, robots, noindex, canonical, soft 404, หน้าทำเงินตอบ 200) · บทที่ 11 (แก้ 3 เรื่องสำคัญก่อน, ลิงก์แบบ hub-and-spoke) · บทที่ 22 (การบล็อกบอต AI ไม่ใช่ทางเลือกที่ฉลาดเสมอ)
- Eric Enge, Stephan Spencer, Jessie Stricchiola, The Art of SEO, 4th ed. (O’Reilly, 2023), บทที่ 3 (crawl ได้ไม่หมด, เหตุผลที่บอตข้าม URL) · บทที่ 7 (XML sitemap, IndexNow, ดูหน้า crawled not indexed เป็นประจำ, Disallow ไม่ลบหน้าจาก index แต่ noindex ลบได้) · บทที่ 8 (site: เป็นแค่ค่าประมาณ, crawl ไม่เท่ากับ index) · บทที่ 10 (แก้ปัญหาหน้าไม่ถูก crawl และไม่ถูก index, หาหน้ากำพร้า) · หมายเหตุ: หนังสือปี 2023 ยังใช้ชื่อรายงาน Coverage ซึ่งปัจจุบันเป็น Page indexing