สรุปสั้น (TL;DR)
Robots.txt คือไฟล์ข้อความที่วางไว้ที่รากของเว็บ (เช่น example.com/robots.txt) เพื่อบอก crawler อย่าง Googlebot ว่า URL ไหนเข้าได้ URL ไหนไม่ควรเข้า robots.txt คุมการ crawl ไม่ได้คุมการ index ถ้าอยากให้หน้าไม่ขึ้นใน Google ต้องใช้ noindex หรือรหัสผ่าน ไม่ใช่ Disallow
- Google อ่านกลุ่มเดียว: ถ้ามีกลุ่ม
User-agent: Googlebotแยก Googlebot จะใช้แค่กลุ่มนั้นและไม่สนกฎของUser-agent: *เลย ส่วนกฎที่ชนกันในกลุ่มเดียว path ที่ยาวกว่าชนะ ถ้ายาวเท่ากัน Allow ชนะ (สเปกของ Google อัปเดต 31 ส.ค. 2026) - ข้อมูลของเรา (ผลสังเกตเบื้องต้น 15 ต.ค. 2026): robots.txt ของเว็บธุรกิจไทยที่ติดหน้า 1 Google 56 ไฟล์ ไม่มีไฟล์ไหนบล็อก Googlebot ทั้งเว็บ แต่ราว 1 ใน 5 ไม่มีบรรทัด
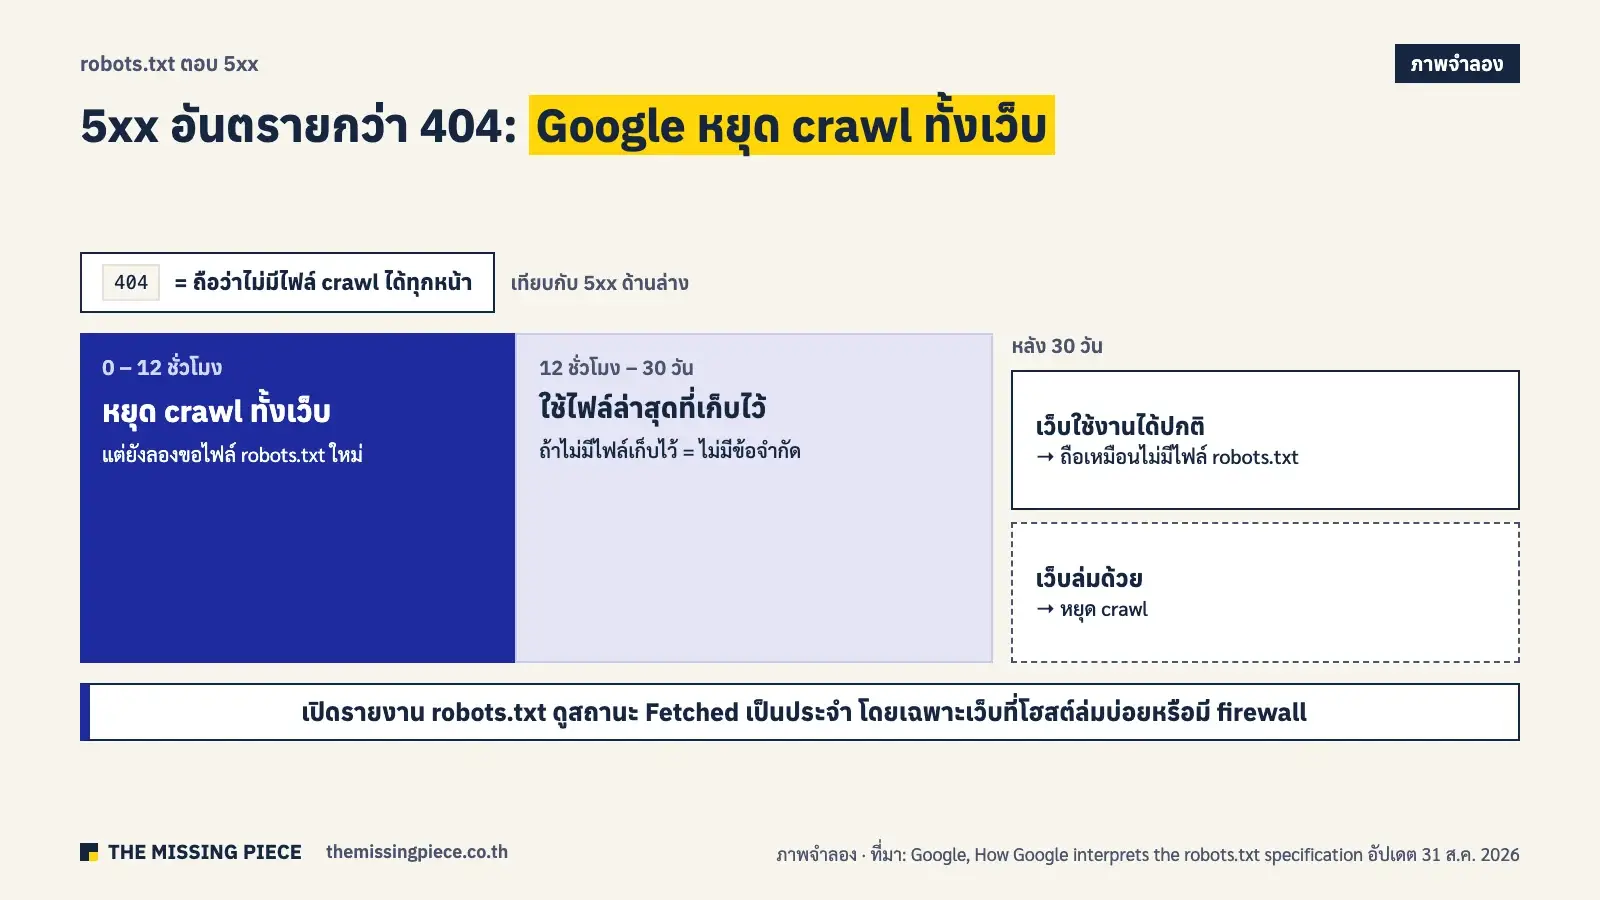
Sitemap:(19.6%) และใน 5 ไฟล์ที่ตั้งกลุ่ม Googlebot แยก มี 4 ไฟล์ที่ทำให้กฎของกลุ่ม*หลุด (ฐานเล็ก อ่านเป็นตัวอย่าง ไม่ใช่สัดส่วน) - ไฟล์ตอบ 500 อันตรายกว่าไม่มีไฟล์: ถ้า robots.txt ตอบ 404 Google ถือว่า crawl ได้ทุกหน้า แต่ถ้าตอบ 5xx Google จะหยุด crawl ทั้งเว็บ 12 ชั่วโมงแรก แล้วใช้ไฟล์เก่าที่เก็บไว้ต่ออีกได้ถึง 30 วัน
สารบัญ
- Robots.txt คืออะไร
- คำสั่งใน robots.txt
- Google เลือกกฎไหนเมื่อกฎชนกัน
- ตัวอย่าง robots.txt 6 แบบ
- robots.txt vs noindex vs X-Robots-Tag
- “Blocked by robots.txt” แก้ยังไง
- ตรวจ robots.txt ยังไง
- robots.txt ตอบ 404 หรือ 500
- ข้อมูลไทย: 56 ไฟล์ผิดตรงไหน
- แก้ robots.txt บน WordPress
- ความเชื่อที่ล้าสมัยแล้ว
- แล้ว AI bot ล่ะ
- ใครต้องแก้ และข้อควรระวัง
- คำถามที่พบบ่อย
Robots.txt คืออะไร ทำหน้าที่อะไร
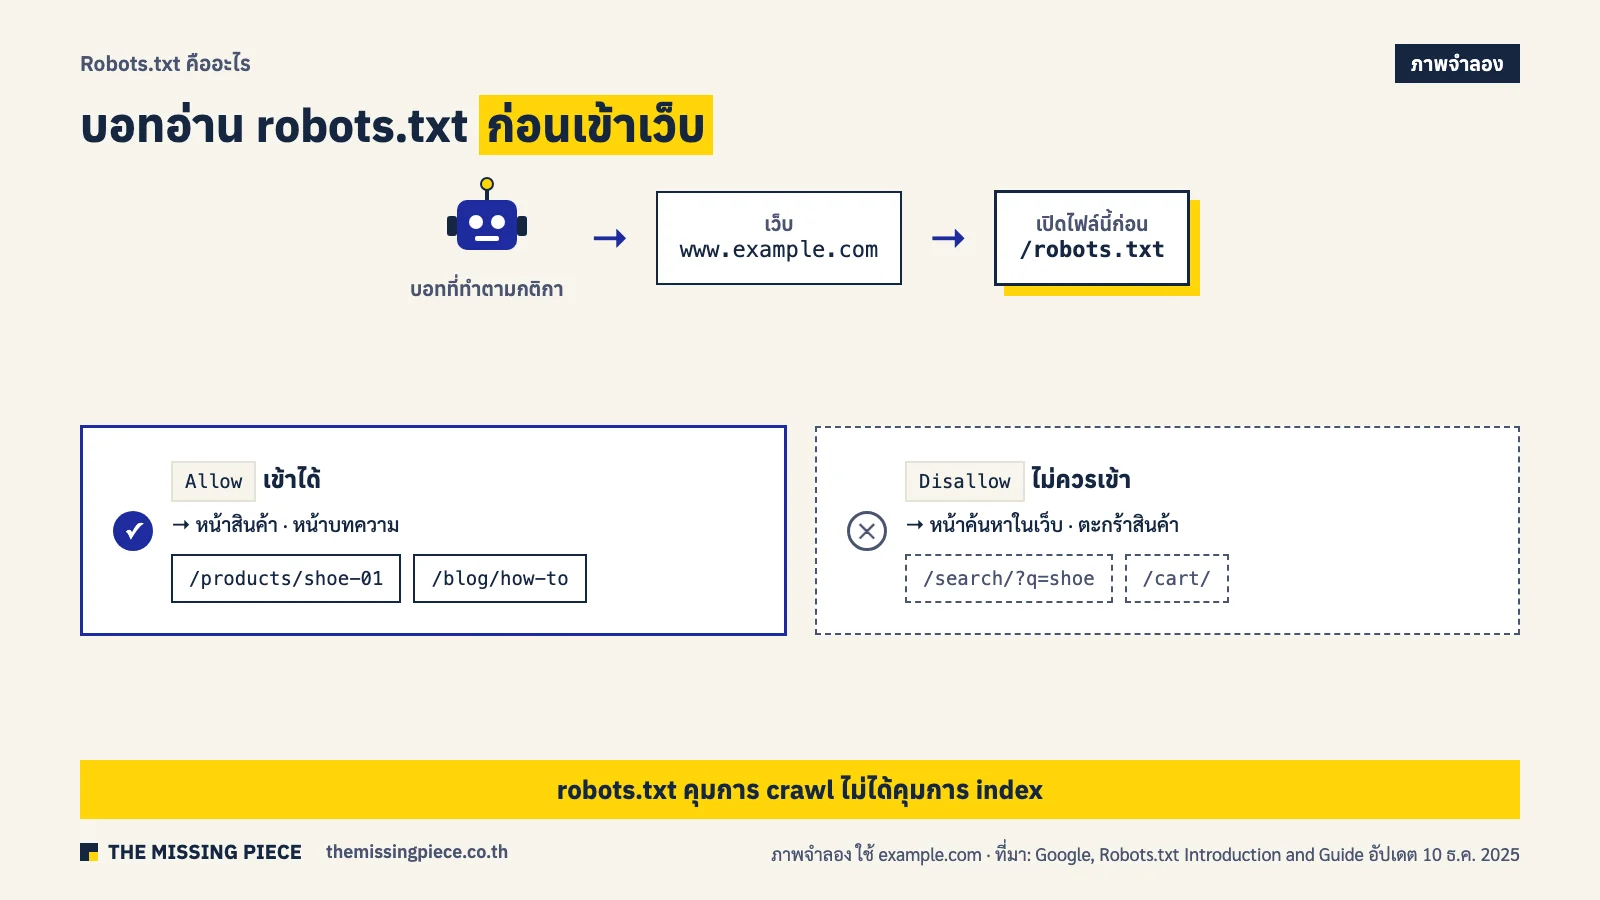
Robots.txt (หลายคนพิมพ์ว่า robot.txt) คือไฟล์ข้อความธรรมดาที่วางไว้ที่รากของเว็บ เพื่อบอก crawler (บอทที่ตามลิงก์ไปเก็บหน้าเว็บ เช่น Googlebot) ว่า URL ไหนเข้าได้ และ URL ไหนไม่ควรเข้า ไฟล์นี้เหมาะกับเจ้าของเว็บและคนดูแลเว็บที่อยากกันบอทไม่ให้เสียแรงกับส่วนที่ไม่จำเป็น เช่น หน้าค้นหาในเว็บหรือหน้าตะกร้าสินค้า กติกาของไฟล์มาจาก Robots Exclusion Protocol ซึ่งเป็นมาตรฐาน RFC 9309 (ก.ย. 2022) และ Google อธิบายวิธีอ่านไฟล์ของตัวเองไว้ในเอกสาร crawling ที่อัปเดตล่าสุด 31 ส.ค. 2026
robots.txt คุมการ crawl ไม่ได้คุมการ index ประโยคนี้คือเรื่องที่สำคัญที่สุดของทั้งบทความ เอกสาร Robots.txt Introduction and Guide ของ Google (อัปเดต 10 ธ.ค. 2025, มีฉบับภาษาไทย) เขียนตรงๆ ว่า robots.txt “not a mechanism for keeping a web page out of Google” คือไม่ใช่วิธีกันหน้าออกจาก Google เพราะ URL ที่ถูกบล็อกยังขึ้นผลค้นหาได้ถ้ามีลิงก์จากที่อื่นชี้มา เพียงแต่จะไม่มีคำอธิบายใต้ลิงก์
Google แยกผลของ robots.txt เป็น 3 แบบตามชนิดไฟล์:
- หน้าเว็บ: ใช้จัดการภาระการ crawl
- ไฟล์รูป วิดีโอ และเสียง: ใช้กันไม่ให้ขึ้นในผลค้นหาของ Google ได้
- ไฟล์ประกอบหน้า (resource) อย่าง CSS หรือ JavaScript: บล็อกได้เฉพาะเมื่อหน้ายังแสดงผลถูกโดยไม่ต้องใช้ไฟล์นั้น
The Art of SEO บทที่ 7 วางกรอบเดียวกัน คือแยกเครื่องมือ “คุมการ crawl” (robots.txt) ออกจากเครื่องมือ “คุมการ index” (meta robots, canonical) และ AI SEO For Dummies บทที่ 2 ย้ำว่าไม่ใช่ทุกบอทที่ทำตาม robots.txt
ถ้ายังไม่แน่ใจว่า crawl กับ index ต่างกันยังไง อ่านภาพรวม 4 ขั้นของ Google ได้ที่ Technical SEO คืออะไร และ Search Engine คืออะไร ทำงานยังไง
เว็บต้องมี robots.txt ไหม ถ้าไม่มีจะเป็นอะไร
เว็บไม่จำเป็นต้องมี robots.txt ถ้าไม่มีอะไรที่อยากกันบอท เพราะเมื่อ Google ขอไฟล์แล้วได้ 404 จะถือว่าไม่มีข้อห้าม และ crawl ได้ทุกหน้า แต่เว็บส่วนใหญ่ควรมี เพื่อใส่บรรทัด Sitemap: และกันส่วนที่สร้าง URL ไม่รู้จบ เช่น หน้าค้นหาภายใน ในข้อมูลของเรา เว็บธุรกิจไทยที่ติดหน้า 1 Google มีไฟล์ robots.txt ที่ตอบ 200 อยู่ 59 จาก 62 เว็บ (95.2%, ช่วงความเชื่อมั่น 95% อยู่ที่ 86.7–98.3%) อีก 3 เว็บตอบ 404 ซึ่งไม่ผิดกติกา
ถ้าใช้ WordPress, Wix หรือ Shopify ส่วนใหญ่มีไฟล์ให้อัตโนมัติแล้ว โดยบางแพลตฟอร์มอย่าง Wix และ Blogger อาจไม่ให้แก้ไฟล์ตรง เอกสาร Google แนะนำให้ไปใช้ช่องตั้งค่าการค้นหาของแพลตฟอร์มแทน
ไฟล์ robots.txt อยู่ที่ไหน และดูของเว็บตัวเองยังไง
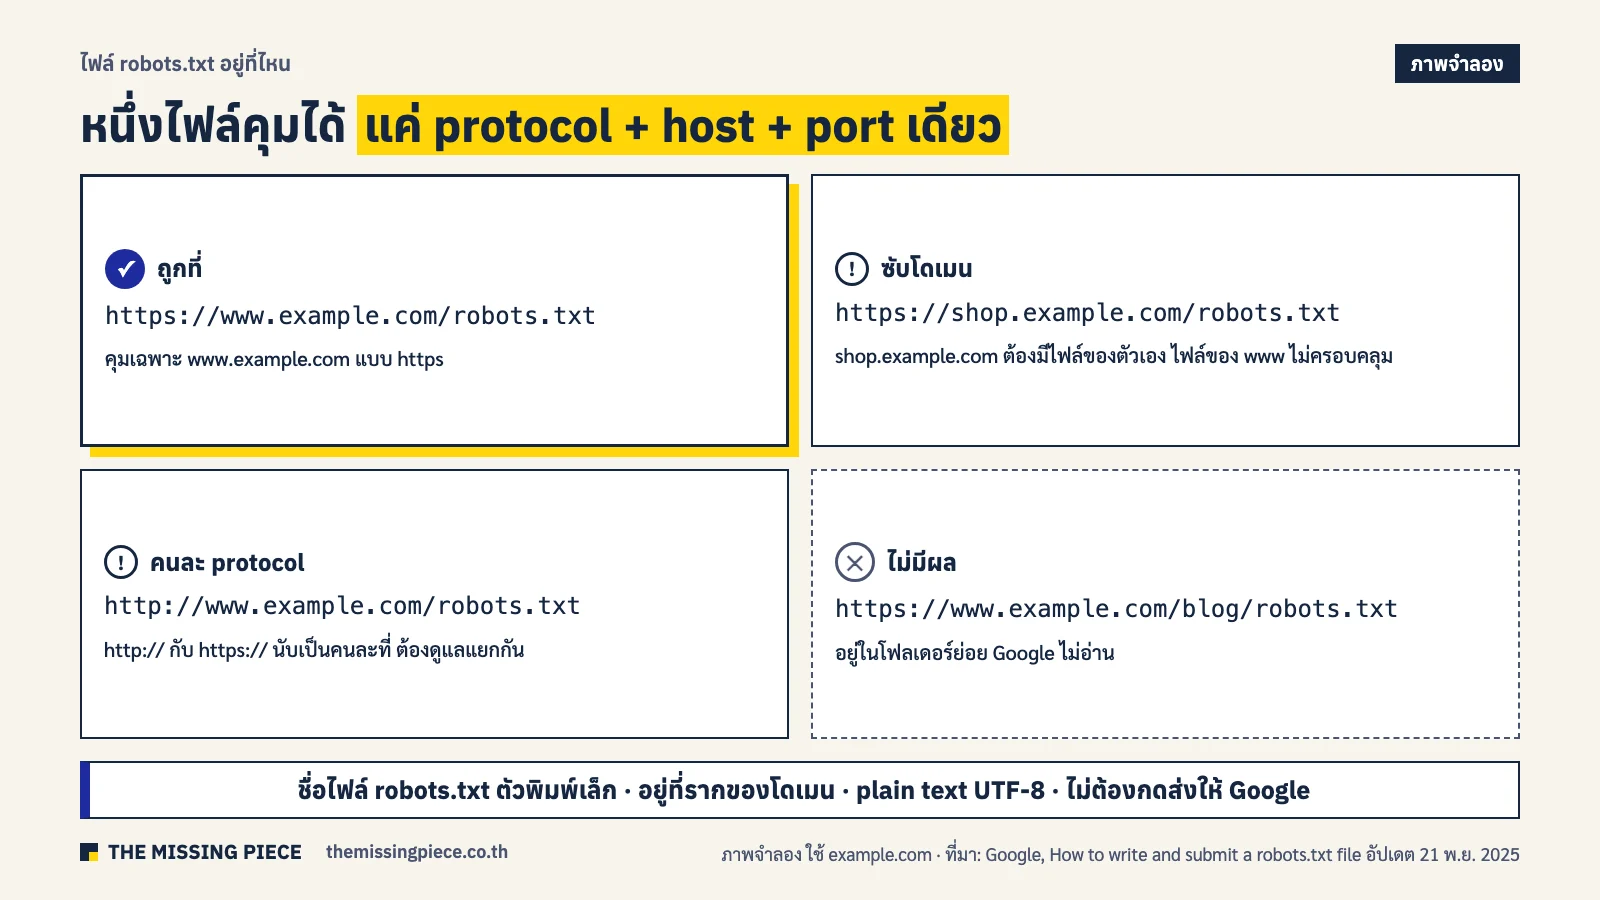
ไฟล์ robots.txt ต้องชื่อ robots.txt ตัวพิมพ์เล็ก และอยู่ที่รากของโดเมนเท่านั้น เช่น https://www.example.com/robots.txt ดูของเว็บตัวเองได้ด้วยการพิมพ์ /robots.txt ต่อท้ายโดเมนในเบราว์เซอร์ ถ้าเห็นข้อความหลายบรรทัดขึ้นต้นด้วย User-agent แปลว่ามีไฟล์แล้ว
เอกสาร How to write and submit a robots.txt file (อัปเดต 21 พ.ย. 2025) กำหนดว่าไฟล์หนึ่งใช้ได้กับ protocol, host และ port เดียวที่มันอยู่ ไฟล์ใน www.example.com จึงไม่ครอบคลุม shop.example.com, http:// หรือ port อื่น ไฟล์ต้องเป็น plain text แบบ UTF-8 ห้ามวางในโฟลเดอร์ย่อย และไม่ต้องกดส่งให้ Google เพราะ Google หาเจอเองเมื่อไฟล์อยู่ถูกที่
คำสั่งใน robots.txt: User-agent, Disallow, Allow และ Sitemap
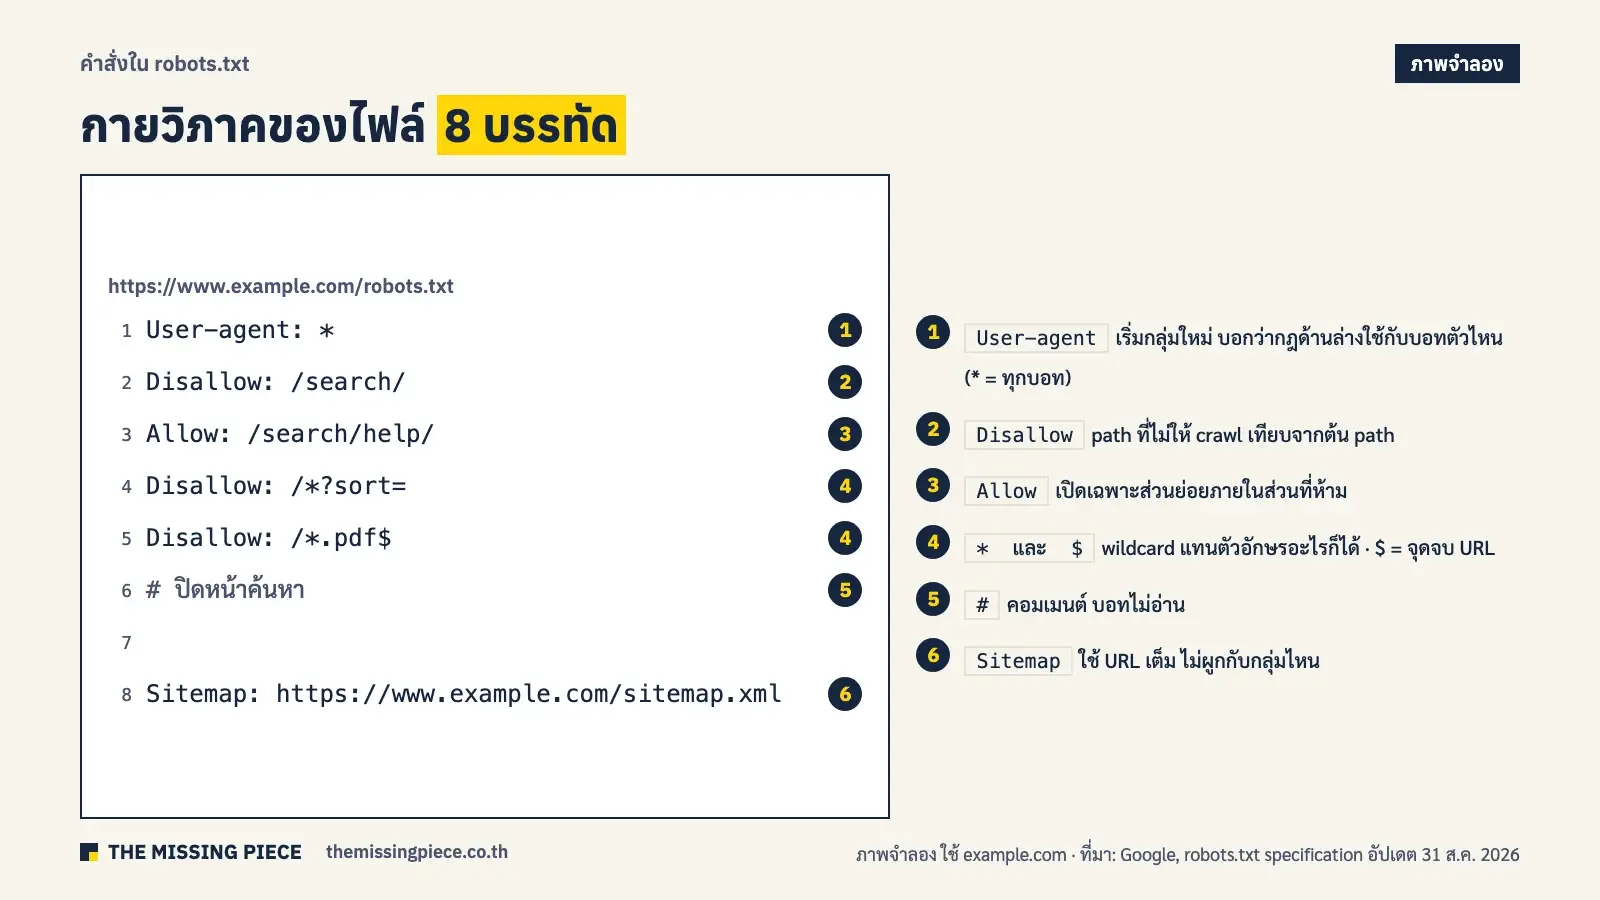
คำสั่งใน robots.txt ที่ Google รองรับมีแค่ 4 ตัว คือ User-agent, Disallow, Allow และ Sitemap ตามสเปก robots.txt ของ Google (อัปเดต 31 ส.ค. 2026) บรรทัดอื่นอย่าง Crawl-delay หรือ Host จะถูกข้าม ไฟล์แบ่งเป็น “กลุ่ม” แต่ละกลุ่มขึ้นต้นด้วย User-agent แล้วตามด้วยกฎ Allow และ Disallow ของบอทกลุ่มนั้น
| คำสั่ง / สัญลักษณ์ | ความหมาย | ตัวอย่าง | ข้อควรรู้ |
|---|---|---|---|
| User-agent | ชื่อบอทที่กลุ่มนี้ใช้ด้วย * = ทุกบอท | User-agent: Googlebot | ชื่อบอทไม่สนตัวพิมพ์เล็กใหญ่ · * ไม่รวมบอท AdsBot ของ Google ที่ต้องระบุชื่อเอง |
| Disallow | path ที่ไม่ให้ crawl | Disallow: /search/ | เทียบจากต้น path · Disallow: ว่างๆ = ไม่ห้ามอะไร · Disallow: / = ห้ามทั้งเว็บ |
| Allow | เปิดให้ crawl path ย่อยภายในส่วนที่ห้าม | Allow: /search/help/ | ใช้คู่กับ Disallow เมื่ออยากเปิดบางส่วน |
| Sitemap | บอกที่อยู่ไฟล์ sitemap | Sitemap: https://www.example.com/sitemap.xml | ต้องเป็น URL เต็ม · ไม่ผูกกับกลุ่มไหน · ใส่ได้หลายบรรทัด |
* ใน path | แทนตัวอักษรอะไรก็ได้ กี่ตัวก็ได้ | Disallow: /*?sort= | * ท้ายสุดไม่มีผล /fish* เท่ากับ /fish |
$ | จบ URL ตรงนี้ | Disallow: /*.pdf$ | /file.pdf?v=2 ไม่โดนกฎนี้ เพราะไม่ได้จบที่ .pdf |
# | คอมเมนต์ บอทไม่อ่าน | # ปิดหน้าค้นหา | ใช้ # เท่านั้น ไม่ใช่ // |
เรื่องตัวพิมพ์เล็กใหญ่ หน้าไทยหลายหน้าเขียนว่า “คำสั่งทุกตัว case-sensitive” ซึ่งไม่ถูกทั้งหมด สเปกของ Google ระบุว่าชื่อคำสั่งและชื่อบอทไม่สนตัวพิมพ์ (disallow กับ Disallow เหมือนกัน) แต่ path สนตัวพิมพ์ กฎ Disallow: /Private/ จึงไม่กัน /private/
อีกเรื่องที่พลาดบ่อยคือการเทียบจากต้น path กฎ Disallow: /blog (ไม่มี / ท้าย) จะกันทั้ง /blog/, /blog-news และ /blogger.html เอกสาร Google จึงแนะนำให้ปิดท้ายด้วย / เมื่อหมายถึงโฟลเดอร์ ส่วนบรรทัด Sitemap ใช้บอกที่อยู่ของ sitemap ที่สร้างไว้แล้ว วิธีหา URL sitemap ของเว็บอยู่ที่ Sitemap คืออะไร สร้างและส่งยังไง
Google เลือกกฎไหน เมื่อกฎใน robots.txt ชนกัน
การเลือกกฎของ Google มี 2 ชั้น ชั้นแรกเลือก “กลุ่ม” ที่ตรงกับชื่อบอทมากที่สุดเพียงกลุ่มเดียว ชั้นที่สองเลือก “กฎ” ภายในกลุ่มนั้นด้วย path ที่ยาวที่สุด สองข้อนี้คือที่มาของความผิดพลาดแบบเงียบที่เราเจอในข้อมูลเว็บไทย และใน 8 หน้าภาษาไทยที่ติดอันดับซึ่งเราเปิดอ่าน (15 ต.ค. 2026) ยังไม่มีหน้าไหนอธิบายไว้ ทั้งสองข้อมาจากสเปก robots.txt ของ Google อัปเดต 31 ส.ค. 2026
กลุ่ม User-agent: Google ใช้กลุ่มที่เจาะจงที่สุดกลุ่มเดียว
กลุ่ม User-agent ที่ Google ใช้กับบอทตัวหนึ่งคือกลุ่มที่ระบุชื่อบอทนั้นเจาะจงที่สุด กลุ่มอื่นทั้งหมดถูกข้าม และ กลุ่มเฉพาะชื่อจะไม่ถูกรวมกับกลุ่ม * บอทจะใช้กลุ่ม * ก็ต่อเมื่อไม่มีกลุ่มไหนเรียกชื่อมันเลย ข้อยกเว้นเดียวคือถ้าเขียนกลุ่มชื่อเดียวกันซ้ำหลายที่ในไฟล์ Google จะรวมเป็นกลุ่มเดียว
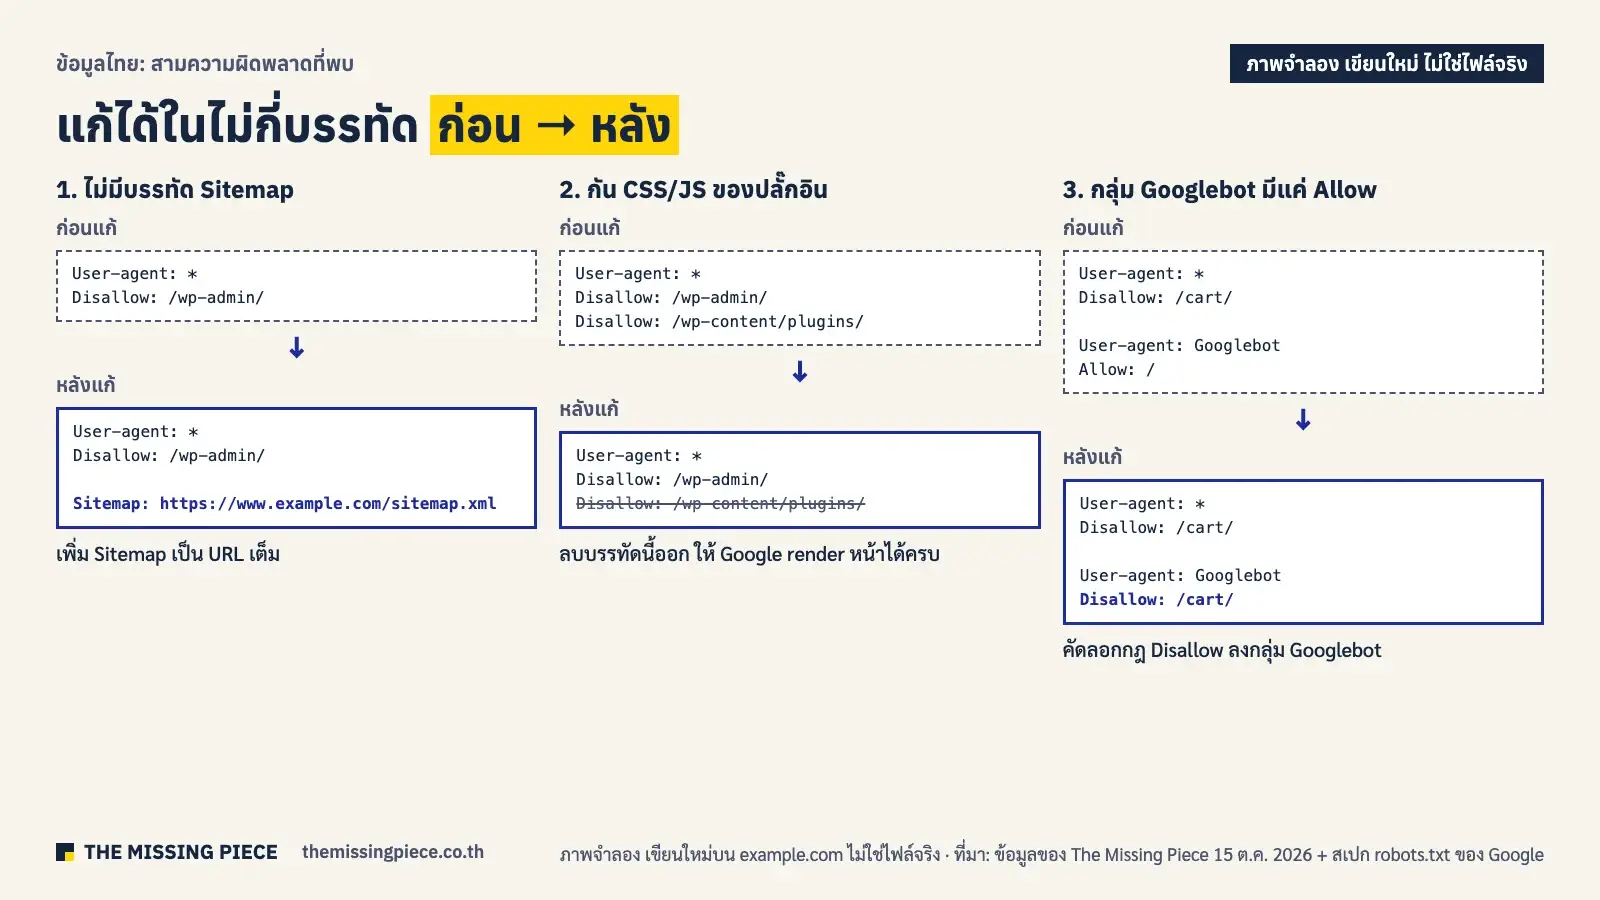
ตัวอย่างด้านล่างคือรูปแบบที่เจอจริงในเว็บไทย (เขียนใหม่บน example.com) เจ้าของเว็บตั้งใจปิดตะกร้าและหน้าค้นหาจากทุกบอท แล้วเพิ่มกลุ่ม Googlebot เพื่อ “เปิดให้ Google เต็มที่” ผลคือ Googlebot อ่านแค่กลุ่มของตัวเอง และกลับไป crawl ตะกร้ากับหน้าค้นหาได้ทั้งหมด
# ก่อนแก้ (ภาพจำลอง): Googlebot ไม่สนกฎ 2 บรรทัดแรก
User-agent: *
Disallow: /cart/
Disallow: /search/

User-agent: Googlebot
Allow: /

# หลังแก้: ลบกลุ่ม Googlebot ทิ้ง หรือคัดลอกกฎที่ต้องการลงในกลุ่มนั้นด้วย
User-agent: *
Disallow: /cart/
Disallow: /search/

User-agent: Googlebot
Disallow: /cart/
Disallow: /search/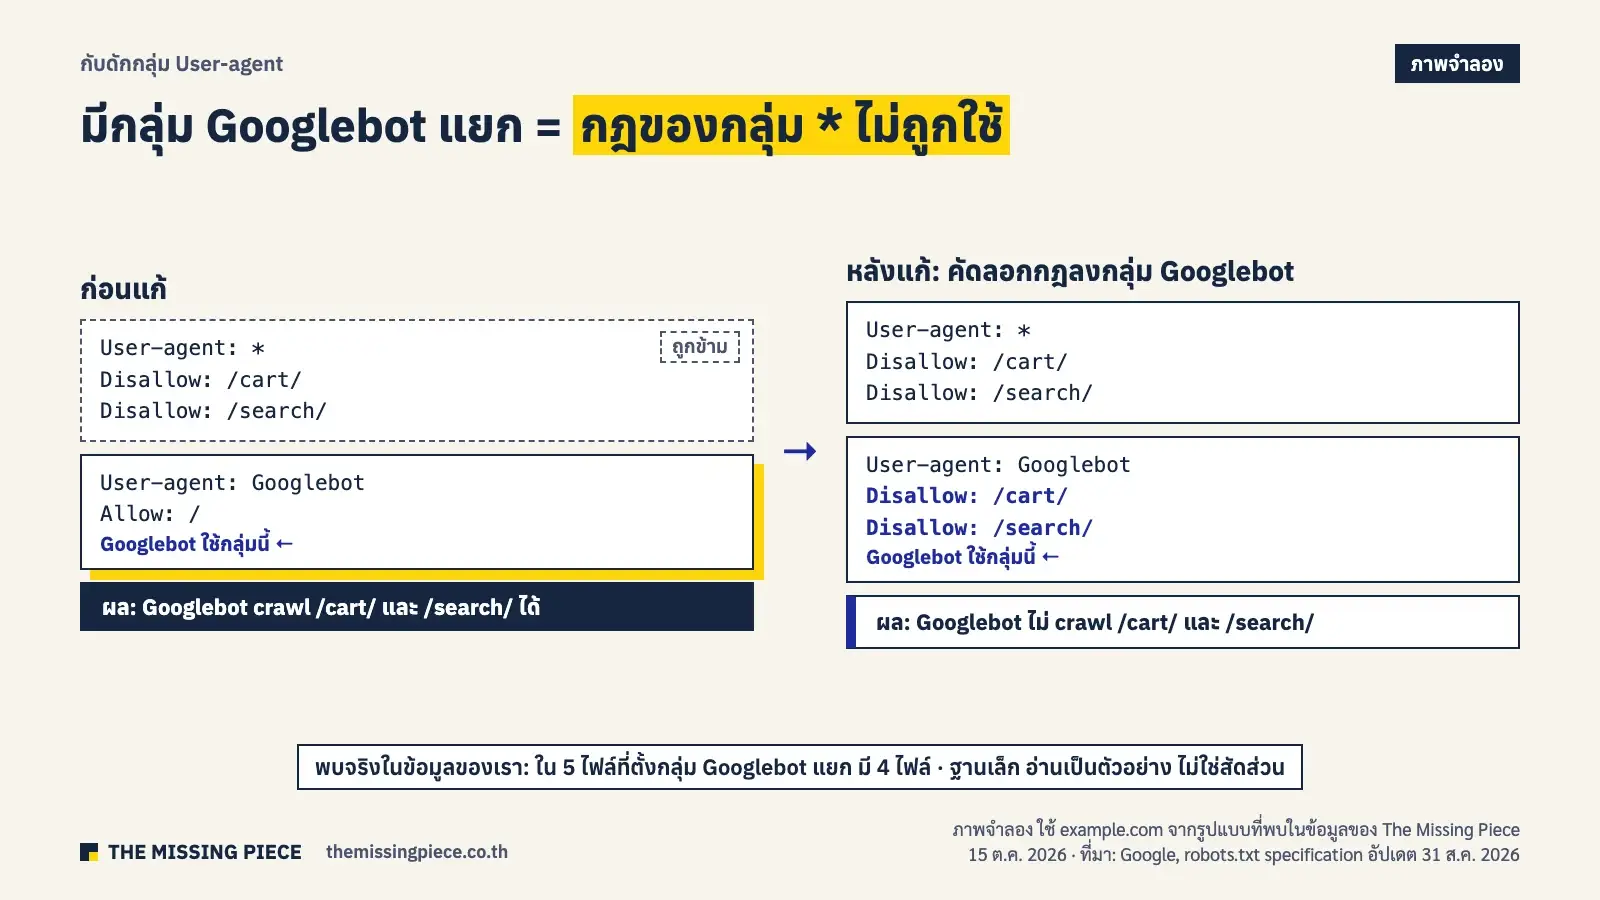
Allow กับ Disallow ชนกัน: path ที่ยาวกว่าชนะ
กฎ Allow กับ Disallow ที่ชนกันในกลุ่มเดียว Google ตัดสินด้วยความยาวของ path ไม่ใช่ลำดับบรรทัด กฎที่ path ยาวกว่า (เจาะจงกว่า) ชนะ โดยนับ wildcard รวมด้วย ถ้ายาวเท่ากันพอดี Google เลือกกฎที่จำกัดน้อยกว่า คือ Allow ชนะ ตารางนี้ใช้กฎของสเปก Google ล้วน
| กฎในกลุ่ม | URL ที่บอทจะเข้า | ผล | เหตุผล |
|---|---|---|---|
Disallow: /shop/Allow: /shop/sale/ | /shop/sale/shoes | crawl ได้ | /shop/sale/ ยาวกว่า |
Allow: /pageDisallow: /*.html | /page.html | ห้าม crawl | /*.html ยาว 7 ตัว มากกว่า /page 5 ตัว |
Allow: /folderDisallow: /folder | /folder/page | crawl ได้ | ยาวเท่ากัน Google เลือกกฎที่จำกัดน้อยกว่า |
Disallow: /fish | /Fish.html | crawl ได้ | path สนตัวพิมพ์ /Fish ไม่ตรงกับ /fish |
Disallow: /*.pdf$ | /guide.pdf?v=2 | crawl ได้ | $ แปลว่าต้องจบที่ .pdf พอดี |
บอทของเจ้าอื่นอาจตีความไม่เหมือน Google ทุกข้อ เอกสาร Google เองเตือนว่า crawler แต่ละตัวอ่านไวยากรณ์ต่างกันได้ ไฟล์ที่ปลอดภัยที่สุดจึงเป็นไฟล์สั้น ไม่มีกฎซ้อนกันเกินจำเป็น ข้อมูลของเราพบว่าไฟล์ของเว็บไทยหน้า 1 ครึ่งหนึ่งยาวไม่เกิน 179 ไบต์ (ค่ามัธยฐาน)
ตัวอย่าง robots.txt 6 แบบ (คัดลอกไปปรับได้)
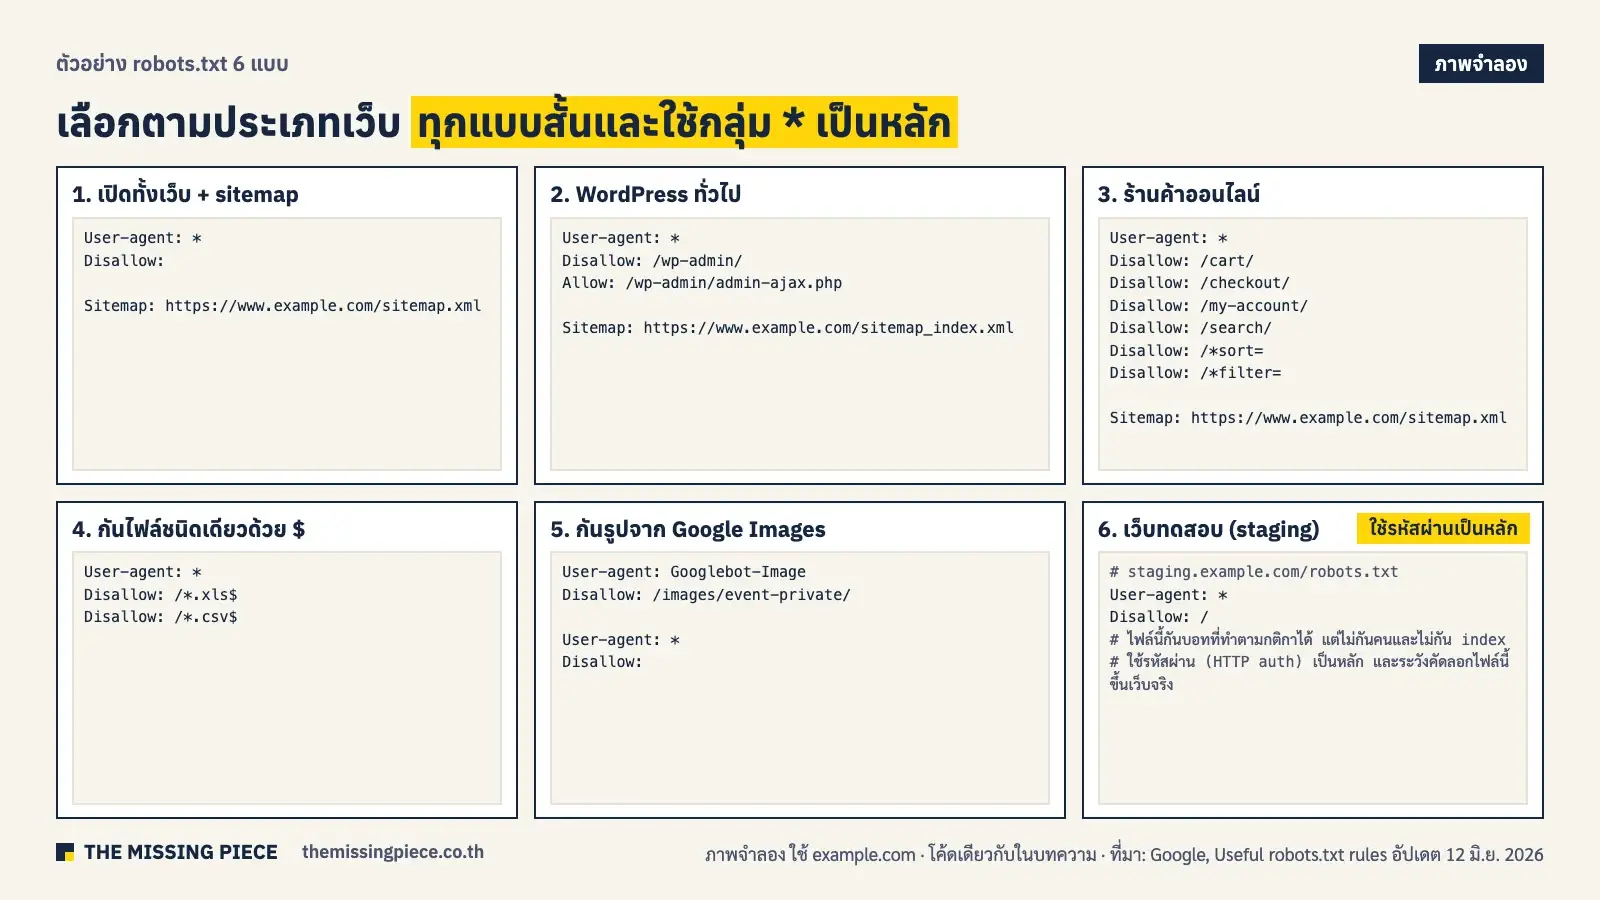
ตัวอย่าง robots.txt ด้านล่างเขียนบน example.com ให้เปลี่ยนโดเมนและ path เป็นของเว็บคุณก่อนใช้ ทุกแบบใช้กลุ่ม User-agent: * กลุ่มเดียว เพื่อเลี่ยงกับดักกลุ่มที่อธิบายด้านบน ถ้าไม่แน่ใจว่าควรปิดอะไร แบบที่ 1 คือจุดเริ่มต้นที่ปลอดภัยที่สุด รูปแบบอ้างอิงจากหน้า Useful robots.txt rules ของ Google (อัปเดต 12 มิ.ย. 2026)
1. เปิดให้ทุกบอท crawl ทั้งเว็บ + บอกที่อยู่ sitemap
User-agent: *
Disallow:

Sitemap: https://www.example.com/sitemap.xml
2. WordPress ทั่วไป
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://www.example.com/sitemap_index.xml
แบบนี้คือรูปแบบที่ WordPress และปลั๊กอิน SEO ส่วนใหญ่ใช้ admin-ajax.php ถูกเปิดไว้เพราะธีมบางตัวใช้ไฟล์นี้โหลดเนื้อหา ห้ามเพิ่ม Disallow: /wp-content/ หรือ /wp-includes/ เพราะจะกัน CSS และ JavaScript ที่ Google ต้องใช้ render หน้า (ประกอบหน้าให้เห็นแบบที่คนเห็น)
3. ร้านค้าออนไลน์: ปิดตะกร้า หน้าค้นหา และ URL กรองสินค้า
User-agent: *
Disallow: /cart/
Disallow: /checkout/
Disallow: /my-account/
Disallow: /search/
Disallow: /*sort=
Disallow: /*filter=

Sitemap: https://www.example.com/sitemap.xml
กฎ /*sort= และ /*filter= ไม่ใส่ ? ไว้หน้า เพื่อให้จับพารามิเตอร์ที่ตามหลัง & ด้วย เช่น ?page=2&sort=price แต่จะจับทุก URL ที่มีคำนี้ จึงต้องเช็กว่าไม่มีหน้าสำคัญที่มีคำนี้ใน path ปิด URL กรองและเรียงสินค้าเมื่อหน้าเหล่านั้นสร้าง URL ได้ไม่รู้จบ และคุณไม่ต้องการให้หน้าไหนติด Google ถ้าบาง URL ที่มีพารามิเตอร์ควรรวมสัญญาณกับหน้าหลัก ให้ใช้ canonical แทน (ดู Canonical vs 301 vs noindex ใช้อันไหนเมื่อไร) เพราะ Google มองไม่เห็น canonical ใน URL ที่ถูกบล็อก
4. กันไฟล์ชนิดเดียวด้วย $
User-agent: *
Disallow: /*.xls$
Disallow: /*.csv$
5. กันรูปในโฟลเดอร์หนึ่งไม่ให้ขึ้น Google Images
User-agent: Googlebot-Image
Disallow: /images/event-private/

User-agent: *
Disallow:
แบบที่ 5 เป็นกรณีเดียวในบทความที่ตั้งกลุ่มเฉพาะชื่อบอท และตั้งใจให้ Googlebot-Image ใช้แค่กฎของกลุ่มตัวเอง ถ้าเว็บมีกฎอื่นในกลุ่ม * ที่อยากให้ Googlebot-Image ทำตามด้วย ต้องคัดลอกลงไปในกลุ่มนี้
6. เว็บทดสอบ (staging): อย่าพึ่ง robots.txt
# staging.example.com/robots.txt
User-agent: *
Disallow: /
# ไฟล์นี้กันบอทที่ทำตามกติกาได้ แต่ไม่กันคนและไม่กัน index
# ใช้รหัสผ่าน (HTTP auth) เป็นหลัก และระวังคัดลอกไฟล์นี้ขึ้นเว็บจริง
เว็บทดสอบควรปิดด้วยรหัสผ่าน เพราะ Google แนะนำรหัสผ่านเป็นวิธีกันหน้าออกจากผลค้นหา ส่วน Disallow: / เป็นแค่ชั้นเสริม ความเสี่ยงที่เจอบ่อยกว่าคือการย้ายไฟล์ staging ขึ้นเว็บจริงพร้อมบรรทัดนี้ ทำให้ Google หยุด crawl ทั้งเว็บ เครื่องมือ robots.txt generator ช่วยพิมพ์ไฟล์ได้ แต่เครื่องมือไม่รู้ว่าเว็บคุณมีส่วนไหนที่ควรปิด จึงต้องตรวจทุกบรรทัดเองก่อนใช้
robots.txt vs noindex vs X-Robots-Tag: ใช้อันไหนเมื่อไร
robots.txt, noindex และ X-Robots-Tag เป็นเครื่องมือคนละขั้น robots.txt บอกว่า “อย่าเข้ามาอ่าน” ส่วน noindex กับ X-Robots-Tag บอกว่า “อ่านได้ แต่อย่าเก็บไปแสดงผลค้นหา” การเลือกผิดตัวคือสาเหตุหลักของสถานะแปลกๆ ใน Search Console และเป็นข้อผิดที่หน้าไทย 6 ใน 8 หน้าที่เราเปิดอ่าน (15 ต.ค. 2026) ยังเขียนว่า robots.txt “กันการ index” ได้
- noindex (meta robots): แท็ก
<meta name="robots" content="noindex">ในส่วน head ของหน้า HTML บอกว่าไม่ให้แสดงหน้านี้ในผลค้นหา - X-Robots-Tag: คำสั่งเดียวกับ meta robots แต่ส่งเป็น HTTP header เช่น
X-Robots-Tag: noindexใช้กับไฟล์ที่ไม่ใช่ HTML อย่าง PDF และรูป ที่ใส่ meta tag ไม่ได้ - robots.txt: คุมว่าบอทเข้า URL ไหนได้ ไม่ได้คุมว่าอะไรขึ้นผลค้นหา
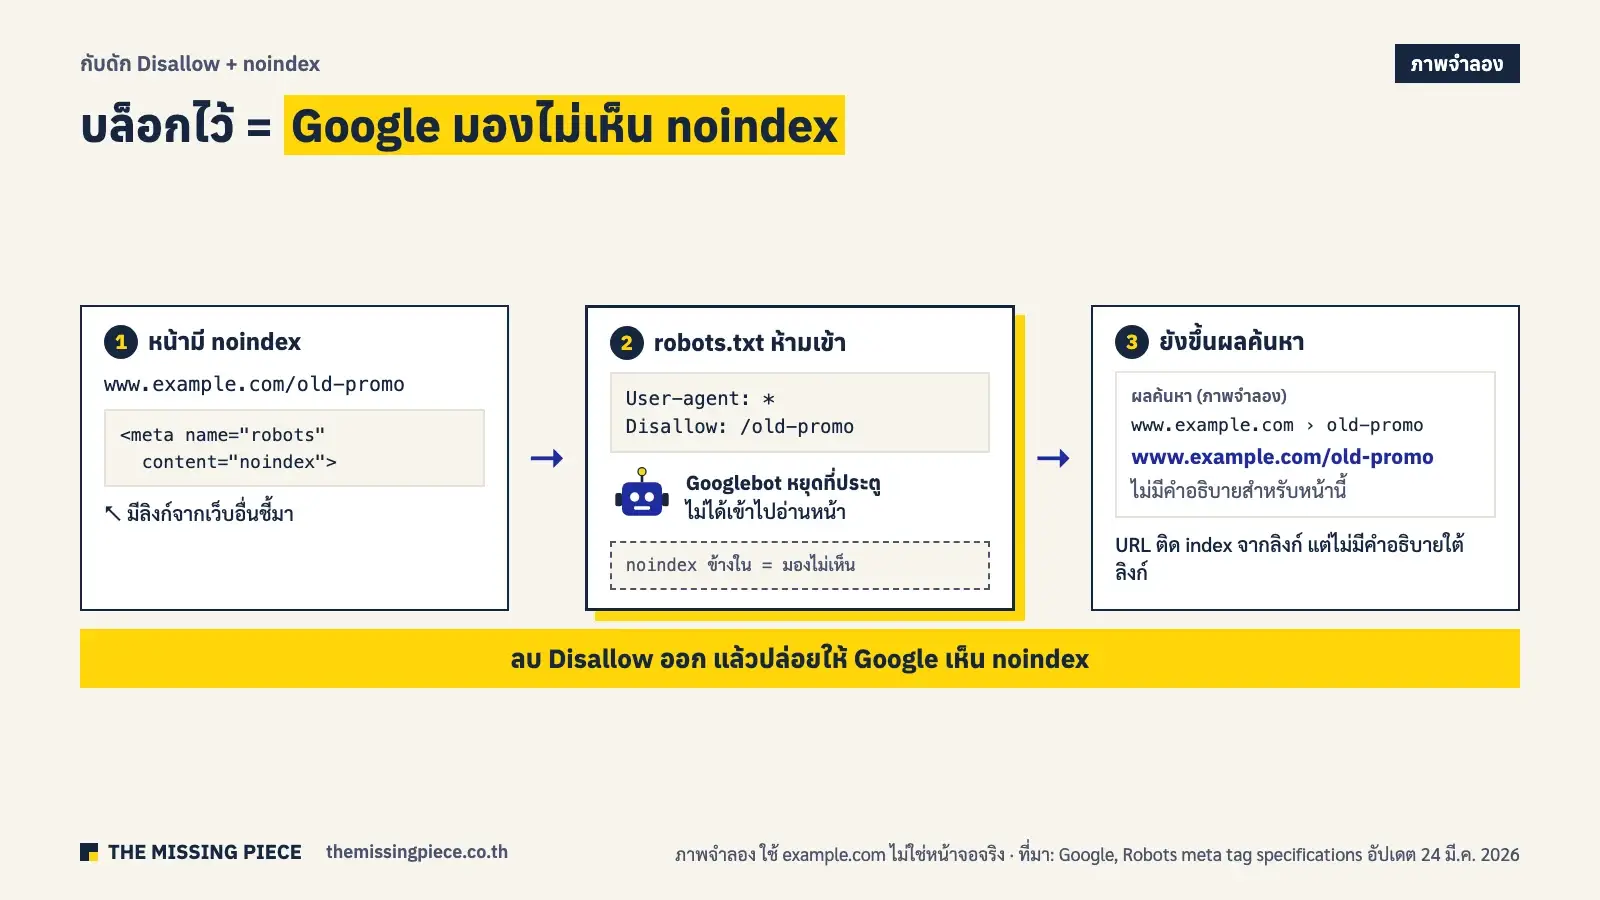
กฎข้อเดียวที่ต้องจำ: อย่า Disallow หน้าที่อยากให้ noindex เอกสาร Robots meta tag, data-nosnippet และ X-Robots-Tag ของ Google (อัปเดต 24 มี.ค. 2026) บอกว่าคำสั่งเหล่านี้จะถูกอ่านก็ต่อเมื่อ Google crawl URL นั้น ถ้า URL ถูกบล็อกใน robots.txt คำสั่ง noindex จะ “not be found and will therefore be ignored” คือไม่ถูกเห็นและถูกเพิกเฉย หน้าที่มีลิงก์จากที่อื่นจึงยังติด index ได้
| อยากได้ผลแบบนี้ | ใช้อะไร | ไม่ควรใช้ | เหตุผล |
|---|---|---|---|
| ลดการ crawl ส่วนที่ไม่มีค่า เช่น หน้าค้นหาภายใน ตะกร้า | robots.txt Disallow | noindex อย่างเดียว | noindex ยังต้องให้บอทเข้ามาอ่านทุกครั้ง |
| ไม่ให้หน้า HTML ขึ้นผลค้นหา | noindex (meta robots) | robots.txt | URL ที่ถูกบล็อกยังติด index ได้จากลิงก์ของหน้าอื่น |
| ไม่ให้ PDF หรือรูปขึ้นผลค้นหา | X-Robots-Tag: noindex | meta tag (ใส่ไม่ได้) | ไฟล์ไม่ใช่ HTML ต้องส่งผ่าน HTTP header |
| ข้อมูลลับ หน้า admin เว็บ staging | รหัสผ่าน / ระบบล็อกอิน | robots.txt | ไฟล์ robots.txt เปิดให้ทุกคนอ่าน และ RFC 9309 ระบุว่าไม่ใช่มาตรการความปลอดภัย |
| หลาย URL เนื้อหาเดียวกัน | canonical | robots.txt | Google ต้อง crawl ถึงจะเห็น canonical และรวมสัญญาณได้ |
| ย้ายหน้าไป URL ใหม่ถาวร | 301 redirect | robots.txt | บล็อก URL เก่าทำให้ Google ไม่เห็น redirect |
| เอาหน้าออกจากผลค้นหาด่วน | Removals ใน Search Console + noindex หรือลบหน้า | robots.txt | Removals ซ่อนชั่วคราว ต้องแก้ที่หน้าจริงด้วย |
เครื่องมือเหล่านี้ยังมีผลต่อ AI Search ของ Google ด้วย เอกสาร robots meta tag ฉบับเดียวกันระบุว่า nosnippet และ max-snippet จำกัดการใช้เนื้อหาเป็นข้อมูลให้ AI Overviews และ AI Mode ด้วย ภาพรวมการใช้ robots.txt, noindex, canonical, redirect และ sitemap ร่วมกันอยู่ที่ robots.txt, noindex, canonical, redirect และ sitemap ใช้อันไหนเมื่อไร และการย้ายหน้าอยู่ที่ 301 Redirect ใช้เมื่อไร
“Blocked by robots.txt” และ “Indexed, though blocked by robots.txt” แก้ยังไง
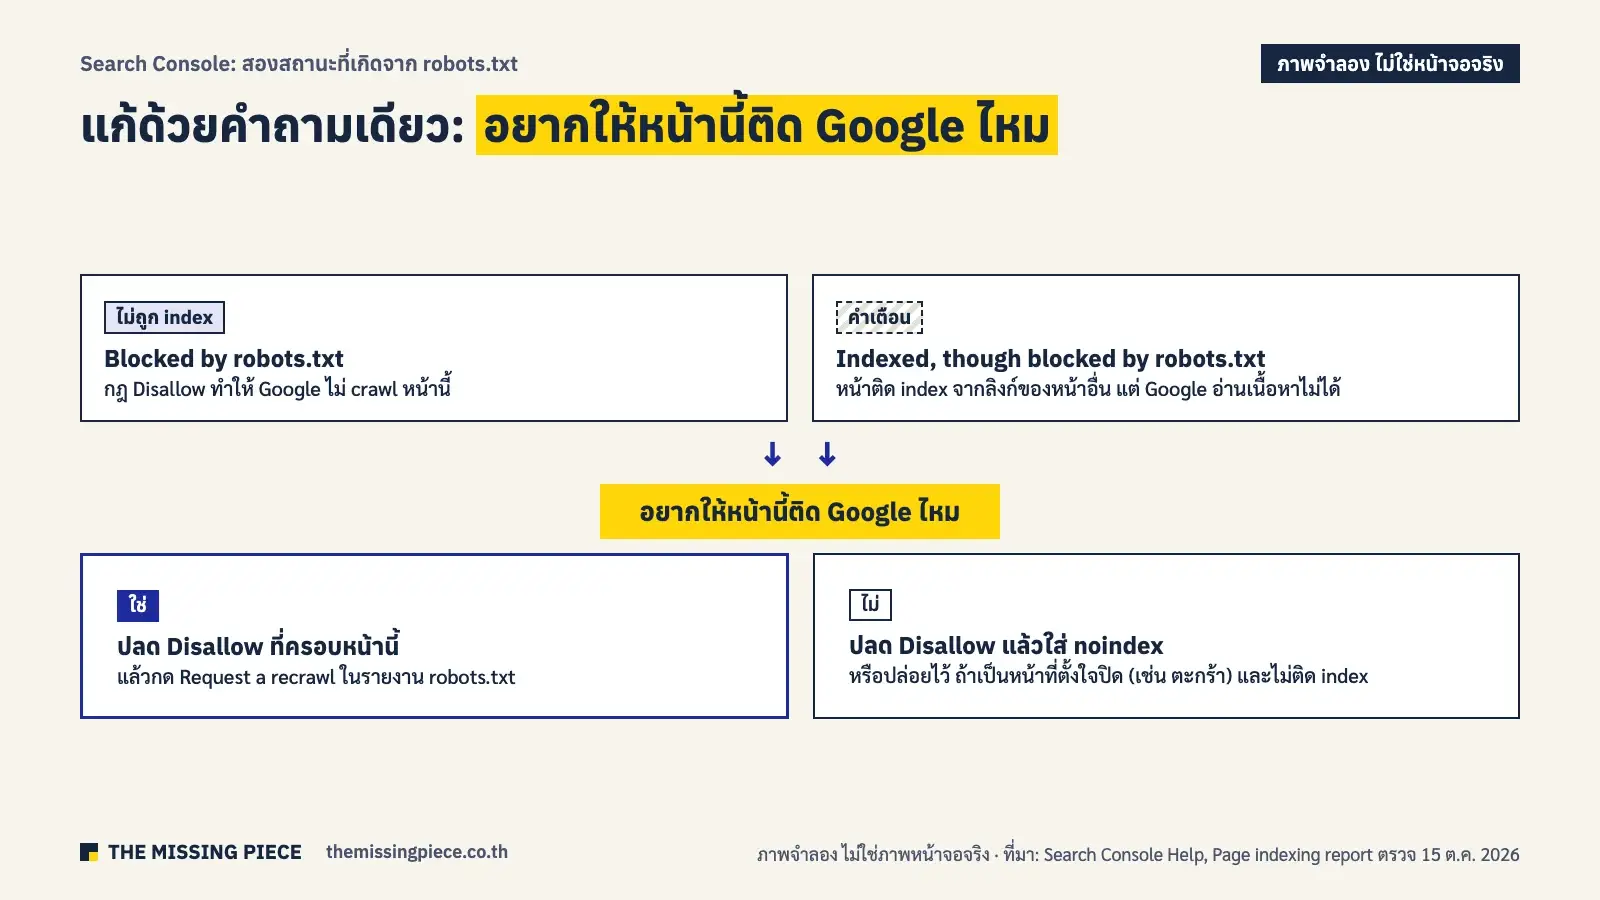
“Blocked by robots.txt” และ “Indexed, though blocked by robots.txt” คือ 2 สถานะในรายงาน Page indexing ของ Search Console ที่เกิดจาก robots.txt โดยตรง สถานะแรกแปลว่า Google ไม่ได้ crawl หน้านั้นเพราะติดกฎ Disallow สถานะที่สองแปลว่าหน้าถูก index ไปแล้วทั้งที่ถูกบล็อก เพราะ Google รู้จัก URL จากลิงก์ของหน้าอื่น วิธีแก้ขึ้นกับคำถามเดียว คือคุณอยากให้หน้านั้นติด Google หรือไม่
| สถานะใน Page indexing | แปลว่า | ถ้าอยากให้หน้าติด Google | ถ้าไม่อยากให้ติด |
|---|---|---|---|
| Blocked by robots.txt (ไม่ถูก index) | กฎ Disallow ทำให้ Google ไม่ crawl หน้านี้ | ลบหรือแก้กฎ Disallow ที่ครอบหน้านี้ แล้วกด Request a recrawl ในรายงาน robots.txt | ถ้าเป็นหน้าที่ตั้งใจปิด เช่น ตะกร้า ปล่อยไว้ได้ ถ้าต้องการแน่ใจว่าไม่ติด index Google แนะนำให้เอา block ออกแล้วใส่ noindex |
| Indexed, though blocked by robots.txt (คำเตือน) | หน้าติด index จากลิงก์ของหน้าอื่น แต่ Google อ่านเนื้อหาไม่ได้ snippet (คำอธิบายใต้ลิงก์) จึงมักไม่สมบูรณ์ | ปลด block ใน robots.txt เพื่อให้ Google อ่านเนื้อหาจริง | ปลด block แล้วใส่ noindex (Google เขียนว่า robots.txt ไม่ใช่วิธีกันการ index) |
ลำดับการไล่หน้าไม่ติด index ใน The Art of SEO บทที่ 10 เริ่มจากเช็กว่าหน้าถูกบล็อกหรือติด noindex ก่อนไปดูเรื่องคุณภาพ ใช้ลำดับเดียวกันได้กับสองสถานะนี้ หลังแก้ ให้กด Validate fix ในรายงาน Page indexing ซึ่ง Google บอกว่าการตรวจโดยทั่วไปใช้เวลาราว 2 สัปดาห์ วิธีอ่านรายงานทั้งหมดอยู่ที่ หน้าไม่ถูก index: อ่านรายงาน Page indexing และลำดับตรวจทั้งเว็บอยู่ที่ SEO Audit ขั้น 1: Google เห็นเว็บเราไหม
ตรวจ robots.txt ยังไง: robots.txt report, URL Inspection และ validator
การตรวจ robots.txt ที่เชื่อถือได้ที่สุดคือรายงาน robots.txt ใน Google Search Console เพราะแสดงไฟล์ที่ Google ดึงไปจริง ไม่ใช่ไฟล์ที่เราคิดว่าอยู่บนเว็บ รายงานนี้ใช้ได้กับ property แบบ Domain หรือ URL-prefix ระดับโดเมนเท่านั้น และมาแทนเครื่องมือ robots.txt Tester ที่ถูกปลดไปเมื่อปลายปี 2023 (ตามรายงานของ Search Engine Land) (ถ้ายังไม่ได้ตั้ง Search Console ดู วิธีเลือก Domain หรือ URL-prefix)
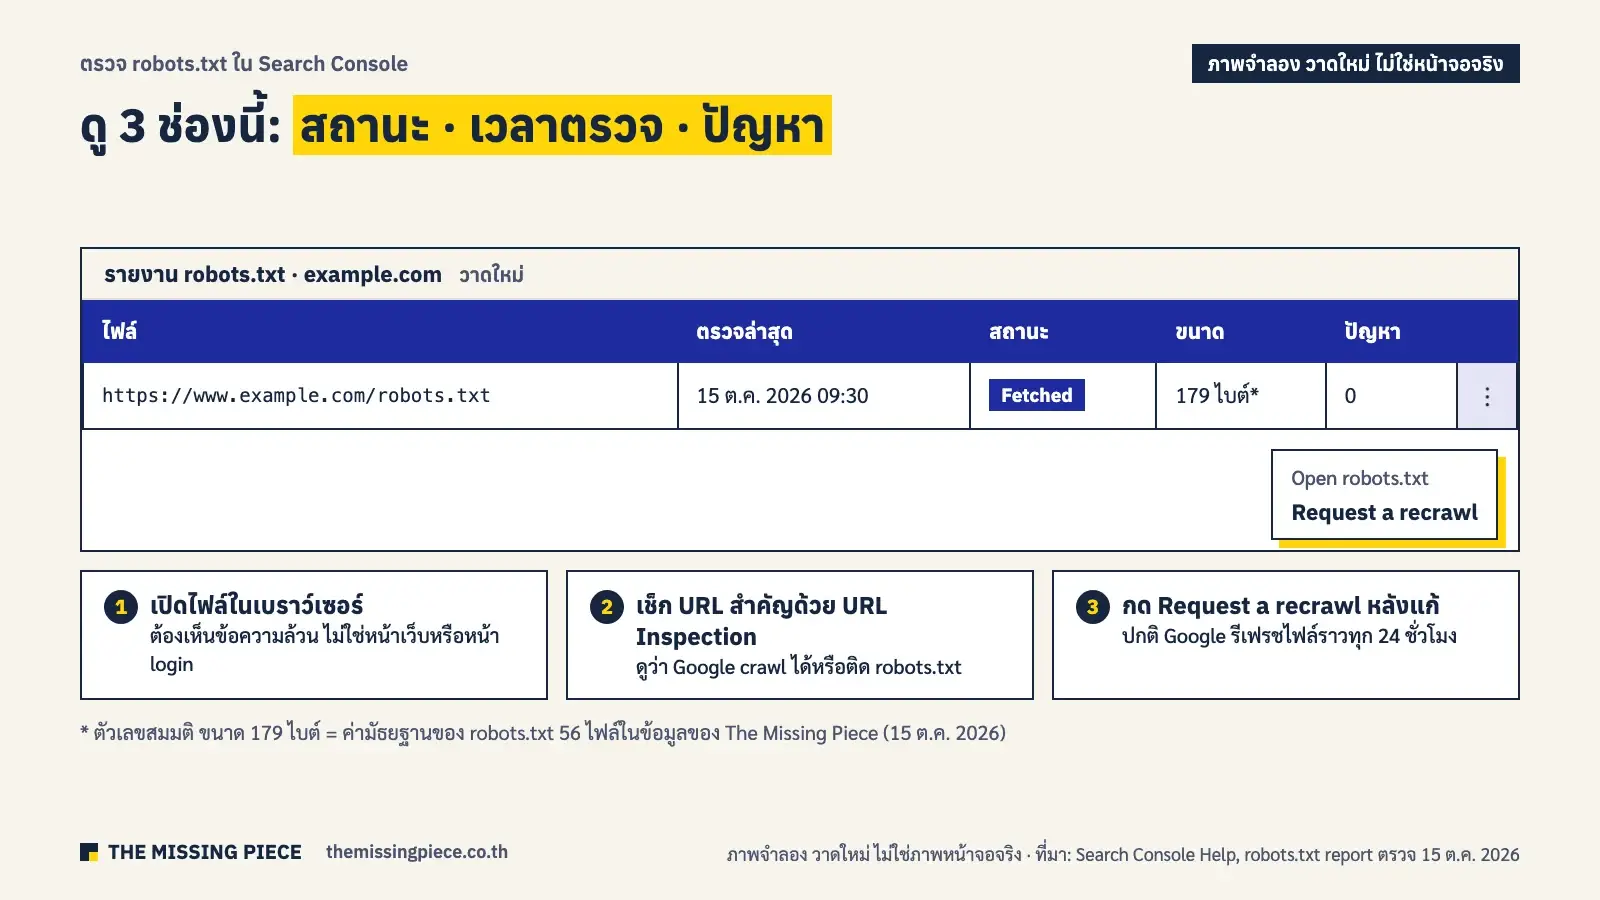
- เปิดไฟล์ในเบราว์เซอร์แบบไม่ระบุตัวตน: พิมพ์ /robots.txt ต่อท้ายโดเมน ต้องเห็นข้อความล้วน ไม่ใช่หน้าเว็บ หน้า login หรือหน้า firewall
- เปิดรายงาน robots.txt ใน Search Console (Settings หรือการตั้งค่า → robots.txt): ดูว่าสถานะเป็น Fetched, เวลาที่ Google ตรวจล่าสุด, ขนาดไฟล์ และจำนวนปัญหา คลิกเปิดไฟล์จะเห็นบรรทัดที่เป็น error (กฎถูกข้าม) หรือ warning ไล่ดูประวัติ 30 วันย้อนหลังได้
- เช็ก URL สำคัญด้วย URL Inspection: ใส่ URL หน้าทำเงินทีละหน้า ดูว่า Google crawl ได้หรือติด robots.txt
- หลังแก้ไฟล์ กด Request a recrawl: ปกติ Google เก็บไฟล์ไว้และรีเฟรชราวทุก 24 ชั่วโมง ปุ่มนี้ใช้เร่งเมื่อปลดบล็อกหน้าสำคัญ แต่ Google บอกว่าไม่รับประกันว่าจะ crawl URL ที่ปลดแล้วทันที
- ทดสอบก่อนขึ้นจริง (สำหรับ dev): ใช้ robots.txt library แบบ open source ของ Google หรือเครื่องมือ robots.txt validator ภายนอก โดยจำไว้ว่า validator แต่ละตัวอาจตีความต่างจาก Google
AI SEO For Dummies บทที่ 10 แนะนำให้ crawl เว็บด้วย 2 มุม คือเป็น Googlebot และเป็นบอททั่วไป แล้วเทียบผล ปัญหาที่หนังสือจัดเป็นหมวดเดียวกันคือ robots, noindex และ resource ที่ถูกบล็อก วิธีนี้จับกับดักกลุ่ม User-agent ได้ เพราะบอทสองตัวจะได้ผลต่างกันทันที
robots.txt ตอบ 404 หรือ 500 แล้ว Google ทำอะไร
HTTP status code ที่ไฟล์ robots.txt ตอบกลับ สำคัญไม่แพ้เนื้อหาในไฟล์ เพราะ Google ตัดสินจาก status ก่อนว่าจะ crawl ทั้งเว็บได้แค่ไหน เรื่องนี้กระทบทุกเว็บที่โฮสต์ล่มบ่อยหรือมี firewall คอยกันบอท และใน 8 หน้าภาษาไทยที่ติดอันดับซึ่งเราเปิดอ่าน ยังไม่มีหน้าไหนอธิบายไว้ (15 ต.ค. 2026) ตารางนี้สรุปจากสเปก Google อัปเดต 31 ส.ค. 2026
| robots.txt ตอบ | Google ทำอะไร | ความเสี่ยง |
|---|---|---|
| 2xx (เช่น 200) | อ่านกฎตามไฟล์ | ปกติ |
| 3xx (redirect) | ตาม redirect อย่างน้อย 5 ทอด ถ้าเกินจะถือเหมือน 404 · redirect ด้วย JavaScript หรือ meta refresh ไม่นับ | ต่ำ ถ้า redirect สั้น |
| 4xx (เช่น 404, 403) | ถือว่าไม่มีไฟล์ crawl ได้ทุกหน้า ยกเว้น 429 ที่ไม่นับรวมในกลุ่มนี้ | ต่ำ แต่กฎที่ตั้งใจไว้จะไม่มีผล |
| 5xx (เช่น 500, 503) หรือ DNS/เครือข่ายล้มเหลว | 12 ชั่วโมงแรก หยุด crawl ทั้งเว็บ แต่ยังลองขอไฟล์ใหม่ · ต่อจากนั้นถึง 30 วัน ใช้ไฟล์ล่าสุดที่เก็บไว้ (ถ้าไม่มี = ไม่มีข้อจำกัด) · เกิน 30 วัน ถ้าเว็บใช้งานได้ปกติ ถือเหมือนไม่มีไฟล์ ถ้าเว็บล่มด้วย หยุด crawl | สูง Google อาจไม่ crawl หน้าใหม่ทั้งเว็บ |
สเปกเดียวกันกำหนดขนาดไฟล์สูงสุด 500 KiB เนื้อหาที่เกินจะถูกข้าม ซึ่งไกลจากไฟล์จริงของเว็บไทยมาก ไฟล์ใหญ่สุดในข้อมูลของเรามีขนาด 1,626 ไบต์ ในการเก็บข้อมูล 15 ต.ค. 2026 มี 1 เว็บที่ robots.txt ตอบ 500 กลับมา ถ้าเป็นแบบนี้กับ Googlebot ด้วย ตามกติกาข้างบน Google จะหยุด crawl เว็บนั้นในช่วงแรก เราเห็นแค่ครั้งเดียวจากเครื่องมือของเรา จึงบอกไม่ได้ว่าเว็บนั้นเสียหายจริงไหม แต่เป็นเหตุผลที่ควรเปิดรายงาน robots.txt ดูสถานะ Fetched เป็นประจำ ส่วนรหัส 403 ที่เกิดจาก firewall มีรายละเอียดในบริบทของ AI bot ที่ robots.txt สำหรับ AI bots
ข้อมูลไทย: robots.txt ของเว็บหน้า 1 Google 56 ไฟล์ ผิดตรงไหน
robots.txt ของเว็บไทยหน้า 1 ไม่มีไฟล์ไหนปิดทั้งเว็บ แต่ความผิดพลาดแบบเงียบยังมีอยู่จริง ข้อมูลชุดนี้คือ robots.txt ของเว็บธุรกิจไทยที่ติดผล organic หน้า 1 ของ Google ประเทศไทยใน 13 คำค้นธุรกิจ เราตรวจการมีไฟล์และบรรทัด Sitemap ของ 62 เว็บเมื่อ 5 ต.ค. 2026 แล้วขอไฟล์ซ้ำเว็บละ 1 ครั้งเมื่อ 15 ต.ค. 2026 ได้ไฟล์ที่อ่านได้ 56 ไฟล์ จากนั้นอ่านด้วยตัวอ่านที่เราเขียนตามกติกาของ Google (กลุ่มเจาะจงที่สุด, path ยาวสุดชนะ, * และ $)
| สิ่งที่ตรวจ | ผล | ช่วงความเชื่อมั่น 95% |
|---|---|---|
| robots.txt ตอบ 200 (5 ต.ค., n = 62) | 59 จาก 62 = 95.2% | 86.7–98.3% |
บล็อก Googlebot ทั้งเว็บ (Disallow: /) | 0 จาก 56 | 0–6.4% |
ไม่มีบรรทัด Sitemap: | 11 จาก 56 = 19.6% | 11.3–31.8% |
มีกลุ่ม User-agent: Googlebot แยก | 5 จาก 56 = 8.9% | 3.9–19.3% |
…ในนั้น กลุ่ม Googlebot ทำให้กฎ Disallow ของ * หลุด | 4 จาก 5 | ฐานเล็กเกินคิดเป็นอัตรา |
| Googlebot ถูกกันจาก CSS/JS ของธีมหรือปลั๊กอิน | 2 จาก 56 = 3.6% | 1.0–12.1% |
| ปิดหน้าค้นหาภายในหรือ URL พารามิเตอร์ | 12 จาก 56 = 21.4% | 12.7–33.8% |
ใช้ wildcard * หรือ $ | 14 จาก 56 = 25.0% | 15.5–37.7% |
รูปแบบ WordPress Disallow: /wp-admin/ | 13 จาก 56 = 23.2% | 14.1–35.8% |
ไฟล์เปิดทั้งหมด (มีแค่ Disallow: ว่าง) | 7 จาก 56 = 12.5% | 6.2–23.6% |
| ไฟล์ว่าง 0 ไบต์ | 2 จาก 56 = 3.6% | 1.0–12.1% |
| ยังมี Crawl-delay (Google ไม่ใช้) | 1 จาก 56 = 1.8% | 0.3–9.4% |
| มีบรรทัด noindex ใน robots.txt (เลิกรองรับ 2019) | 0 จาก 56 | 0–6.4% |
| ขนาดไฟล์ | มัธยฐาน 179 ไบต์ · ใหญ่สุด 1,626 ไบต์ | – |
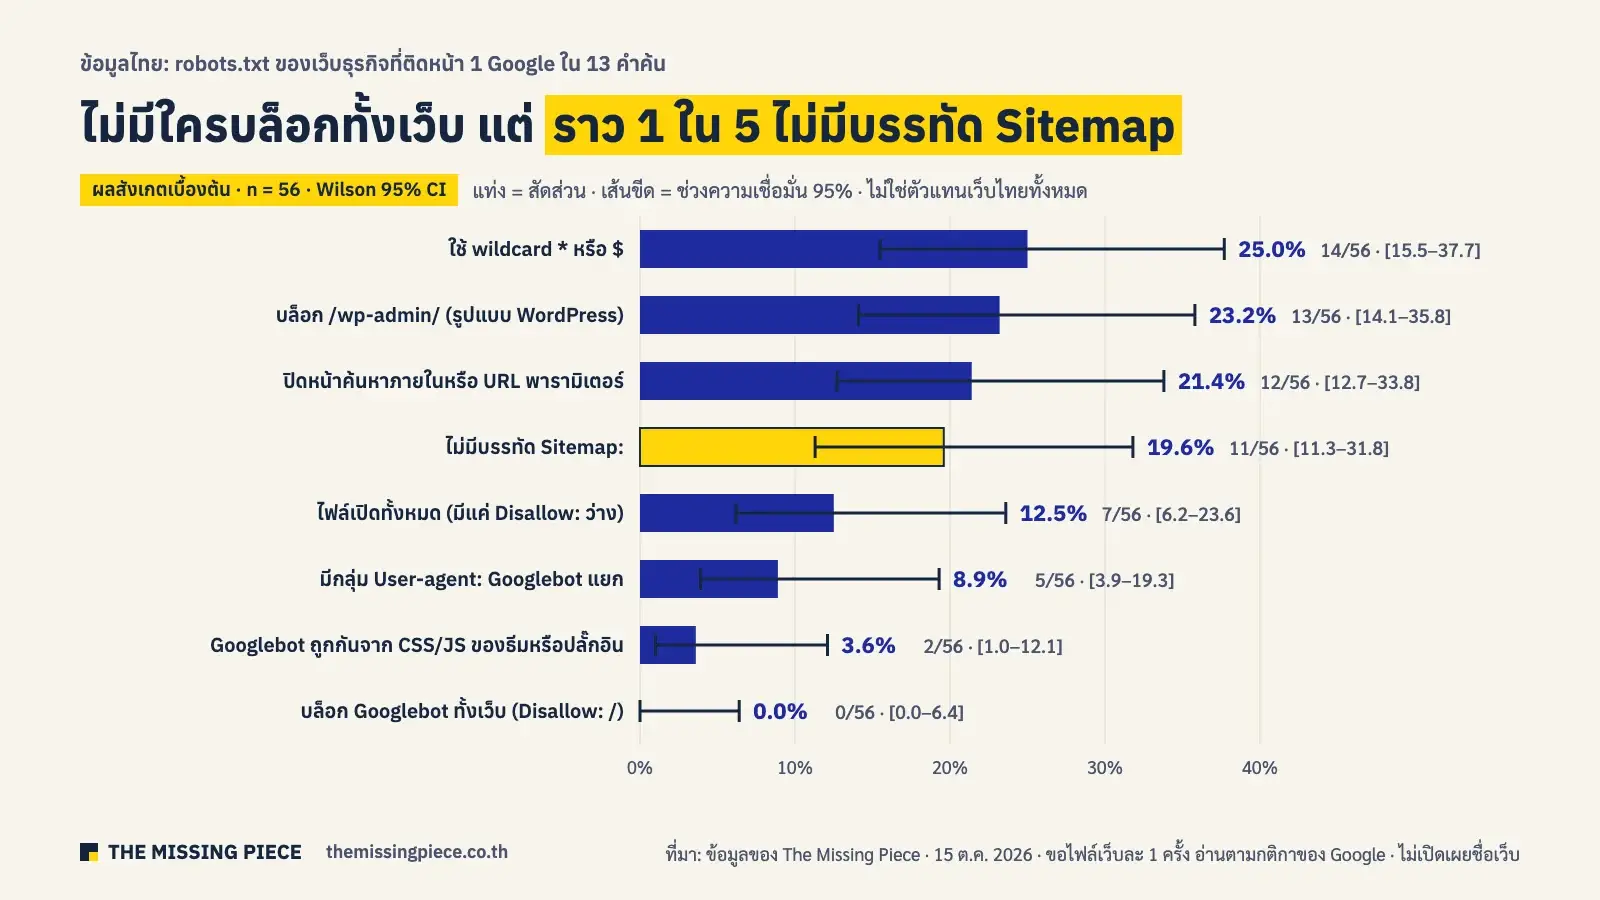
อ่านผลได้สามข้อ ข้อแรก ความผิดพลาดแบบที่ทุกคนกลัว คือ Disallow: / ที่ลืมไว้ ไม่เจอในตัวอย่างนี้เลย (0 จาก 56 ช่วงความเชื่อมั่นสูงสุด 6.4%) เว็บที่ติดหน้า 1 ส่วนใหญ่จึงไม่ได้มีปัญหาใหญ่ที่ robots.txt แต่ข้อนี้ยังเป็นเรื่องแรกที่ต้องเช็กหลังย้ายเว็บหรือขึ้นเว็บจาก staging
ข้อสอง ความผิดพลาดที่เจอจริงเป็นแบบเงียบ ราว 1 ใน 5 ไฟล์ไม่มีบรรทัด Sitemap ซึ่งแก้ง่ายที่สุดและสอดคล้องกับผลศึกษา sitemap ของเราใน Sitemap คืออะไร มี 2 ไฟล์ที่กัน CSS หรือ JavaScript ของธีมหรือปลั๊กอินจาก Googlebot ทำให้ Google อาจ render หน้าไม่ครบ และมี 1 ไฟล์ที่ยังมีบรรทัดตัวอย่างจากเอกสาร Google ติดมาด้วย
ข้อสาม กับดักกลุ่ม User-agent เกิดขึ้นจริง ในไฟล์ที่ตั้งกลุ่ม Googlebot แยก 5 ไฟล์ มี 4 ไฟล์ที่ไม่ได้คัดลอกกฎ Disallow ของกลุ่ม * ลงไป Googlebot จึงไม่ทำตามกฎที่เจ้าของเว็บตั้งใจให้ทุกบอททำตาม ฐาน 5 ไฟล์เล็กเกินกว่าจะสรุปเป็นอัตราของเว็บไทย ให้อ่านเป็นตัวอย่างที่เกิดขึ้นจริง ไม่ใช่สัดส่วน
ข้อจำกัดของข้อมูลชุดนี้:
- เป็นภาพถ่ายครั้งเดียวจากเว็บที่ติดหน้า 1 ใน 13 คำค้นธุรกิจที่เราเลือกเอง ไม่ได้สุ่ม และไม่ใช่ตัวแทนเว็บไทยทั้งหมด
- เราขอไฟล์ด้วยเครื่องมือของเรา ไม่ใช่ Googlebot จริง เว็บที่มี firewall อาจตอบบอทจริงต่างไป (1 เว็บตอบ 403 กับเครื่องมือของเรา จึงไม่นับเป็นความผิดของเว็บ)
- เราไม่เห็นข้อมูล Search Console ของเว็บเหล่านี้ จึงบอกไม่ได้ว่ากฎข้อไหนกระทบอันดับจริง เป็นข้อมูลเชิงบรรยายเท่านั้น
- เราไม่เปิดเผยชื่อเว็บ รายงานแค่ระดับกลุ่ม และตัวอย่างโค้ดในบทความเขียนใหม่ทั้งหมด
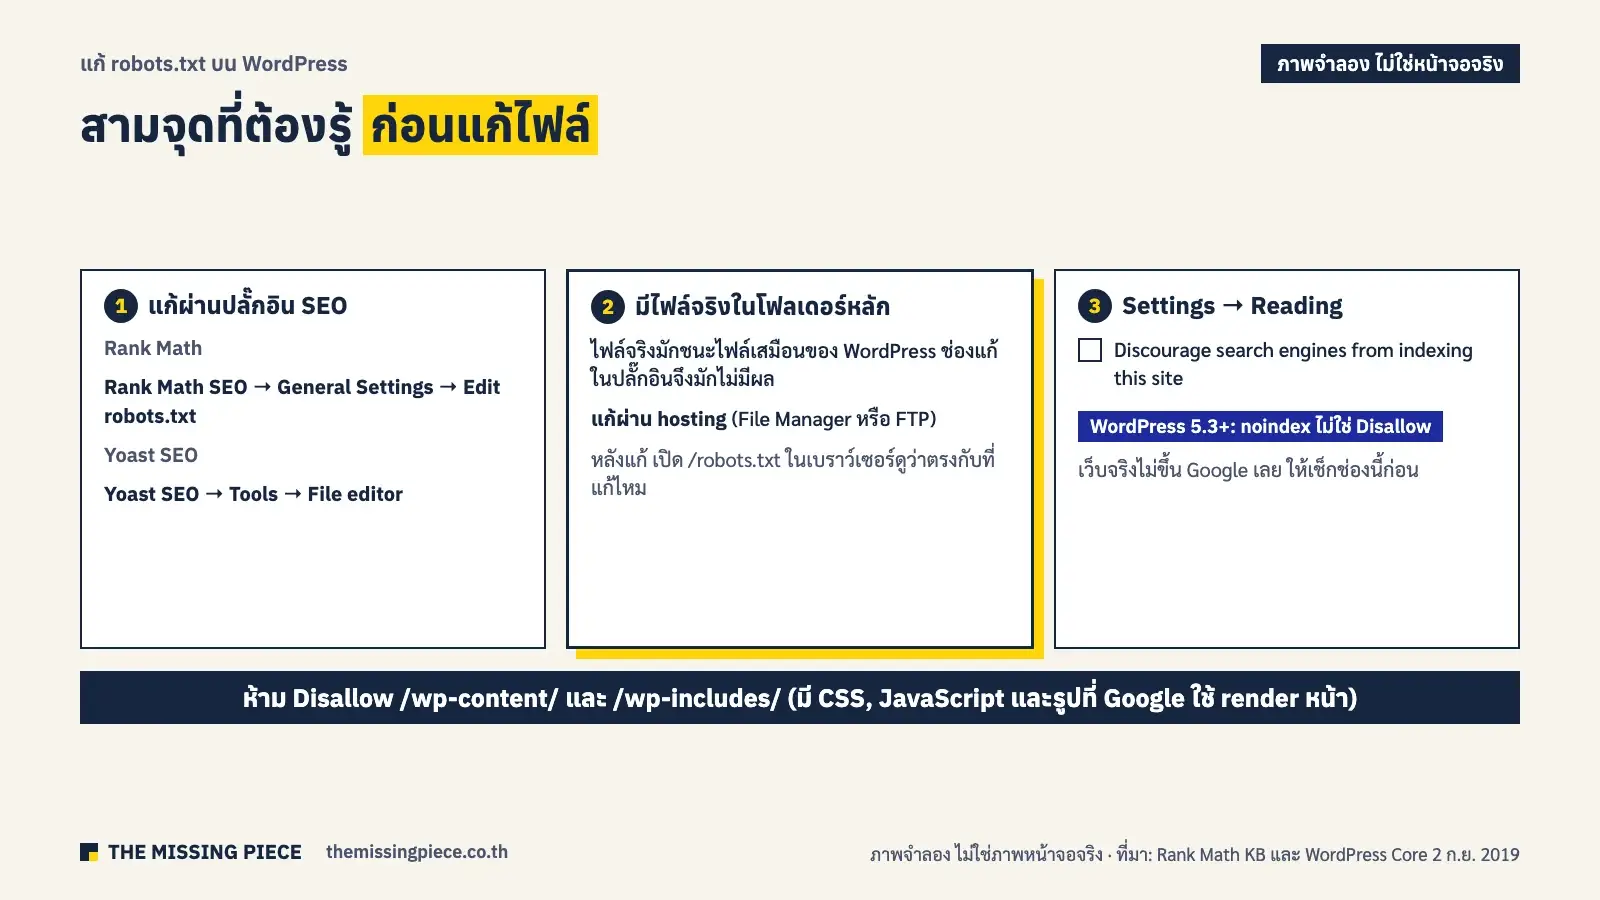
แก้ robots.txt บน WordPress (Rank Math, Yoast และไฟล์จริง)
WordPress สร้าง robots.txt แบบเสมือน (virtual) ให้อัตโนมัติ คือไม่มีไฟล์จริงในโฟลเดอร์เว็บ แต่ WordPress สร้างข้อความตอบกลับเมื่อมีคนขอ /robots.txt เจ้าของเว็บ WordPress ทั่วไปจึงแก้ผ่านปลั๊กอิน SEO ได้โดยไม่ต้องเข้า hosting ถ้าไม่มีเหตุผลเฉพาะ ไฟล์เริ่มต้นของ WordPress หรือของปลั๊กอินก็ใช้ได้แล้ว
- Rank Math: Rank Math SEO → General Settings → Edit robots.txt (ตามคู่มือของ Rank Math)
- Yoast SEO: Yoast SEO → Tools → File editor
- มีไฟล์ robots.txt จริงในโฟลเดอร์หลักของเว็บ: โดยทั่วไปเว็บเซิร์ฟเวอร์จะส่งไฟล์จริงก่อน ไฟล์เสมือนของ WordPress และช่องแก้ในปลั๊กอินจึงมักไม่มีผล หลังแก้ให้เปิด /robots.txt ในเบราว์เซอร์ดูว่าตรงกับที่แก้ไหม ต้องแก้ไฟล์ผ่าน File Manager ของ hosting หรือ FTP แทน
ช่อง “Discourage search engines from indexing this site” (ไม่สนับสนุนให้เครื่องมือค้นหาทำดัชนีเว็บไซต์นี้) ใน Settings → Reading ไม่ได้ใส่ Disallow: / แล้ว ตั้งแต่ WordPress 5.3 (ประกาศ 2 ก.ย. 2019) ช่องนี้ใส่ meta robots noindex, nofollow แทน เพราะทีม WordPress เห็นปัญหาเดียวกันว่า Disallow ไม่ได้กันหน้าออกจากผลค้นหา ถ้าเว็บจริงไม่ขึ้น Google เลย ให้เช็กช่องนี้เป็นอย่างแรก
ข้อห้ามบน WordPress มีข้อเดียวที่สำคัญ คืออย่า Disallow /wp-content/, /wp-content/themes/, /wp-content/plugins/ หรือ /wp-includes/ เพราะเป็นที่อยู่ของ CSS, JavaScript และรูป ที่ Google ใช้ render หน้า ในข้อมูลของเรายังเจอ 2 ไฟล์ที่ทำแบบนี้ ส่วนการเพิ่มกฎสำหรับบอท AI บน WordPress มีวิธีละเอียดใน robots.txt สำหรับ AI bots
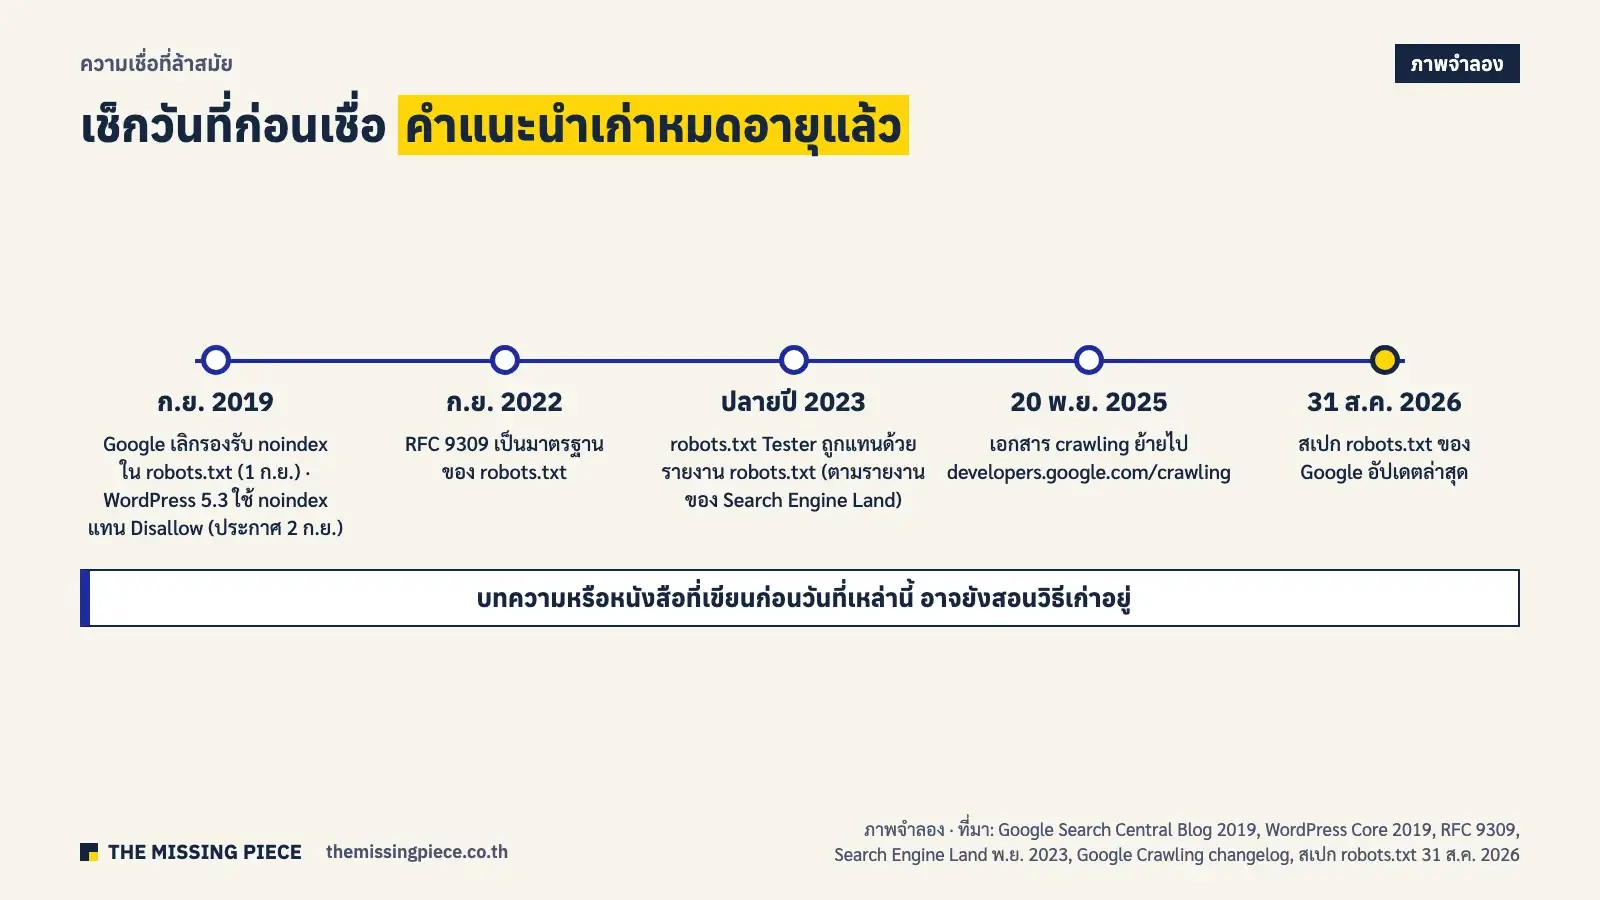
ความเชื่อเรื่อง robots.txt ที่ล้าสมัยแล้ว (เช็กวันที่ก่อนเชื่อ)
ความเชื่อเรื่อง robots.txt หลายข้อเคยถูกในอดีต หรือไม่เคยถูกเลยแต่ถูกคัดลอกต่อกันมา บทความไทยที่ติดอันดับหลายหน้ายังสอนข้อเหล่านี้อยู่ (เปิดอ่าน 8 หน้า 15 ต.ค. 2026) หนังสืออ้างอิงที่ออกปี 2023 อย่าง The Art of SEO ฉบับที่ 4 ก็ยังพูดถึง robots.txt Tester ซึ่งตอนนี้ต้องใช้รายงาน robots.txt แทน ตารางนี้ใส่วันที่ของการเปลี่ยนแปลงไว้ให้ตรวจเองได้
| ความเชื่อ | ความจริง (ณ ต.ค. 2026) | ที่มา |
|---|---|---|
| robots.txt กันหน้าไม่ให้ขึ้น Google | ไม่ใช่ URL ที่ถูกบล็อกยังติด index ได้ ใช้ noindex หรือรหัสผ่าน | Google robots intro (10 ธ.ค. 2025) |
| ใช้ robots.txt ซ่อนหน้า admin หรือข้อมูลลับ | ไฟล์เปิดให้ทุกคนอ่าน การเขียน path ลับลงไปยิ่งบอกที่อยู่ ไม่ใช่มาตรการความปลอดภัย | RFC 9309 (ก.ย. 2022) |
ใส่ Noindex: ใน robots.txt ได้ | Google เลิกรองรับ noindex, nofollow และ crawl-delay ใน robots.txt ตั้งแต่ 1 ก.ย. 2019 | Google Search Central Blog (2 ก.ค. 2019) |
Crawl-delay ทำให้ Googlebot ช้าลง | Google ไม่รองรับบรรทัดนี้ บอทเจ้าอื่นบางเจ้าอาจใช้ | สเปก Google (31 ส.ค. 2026) |
| ทดสอบด้วย robots.txt Tester ใน Search Console | Tester ถูกปลดเมื่อปลายปี 2023 ใช้รายงาน robots.txt + URL Inspection แทน | Search Engine Land (พ.ย. 2023, ไม่ใช่เอกสาร Google) · Search Console Help (รายงาน robots.txt) |
ติ๊ก Discourage ใน WordPress = Disallow: / | ตั้งแต่ WordPress 5.3 ใส่ meta noindex แทน | WordPress Core (2 ก.ย. 2019) |
| ทุกคำสั่งใน robots.txt สนตัวพิมพ์เล็กใหญ่ | ชื่อคำสั่งและชื่อบอทไม่สน แต่ path สน | สเปก Google (31 ส.ค. 2026) |
| robots.txt ช่วยเพิ่มอันดับ | ไม่มีผลกับอันดับโดยตรง เรื่อง crawl budget สำคัญกับเว็บขนาดใหญ่มากเป็นหลัก | Google: Optimize your crawl budget (ดู Technical SEO) |
| เอกสาร robots.txt ของ Google อยู่ที่ Search Central ทั้งหมด | เอกสาร crawling รวม robots.txt ย้ายไป developers.google.com/crawling/ เมื่อ 20 พ.ย. 2025 (เนื้อหาเดิม เปลี่ยนที่อยู่) | Google Crawling changelog |
แล้ว AI bot ล่ะ ต้องเขียนกฎแยกไหม
กฎสำหรับบอทของ AI ใช้ไวยากรณ์เดียวกับที่สอนในบทความนี้ทุกข้อ รวมถึงกับดักกลุ่ม User-agent แต่การเลือกว่าจะเปิดหรือปิดบอทตัวไหน ขึ้นกับว่าบอทนั้นใช้ข้อมูลไปค้นหาหรือฝึกโมเดล ในข้อมูลของเรามีแค่ 3 จาก 56 ไฟล์ที่พูดถึงบอท AI และไม่มีไฟล์ไหนปิดบอท AI ทั้งเว็บ AI SEO For Dummies บทที่ 22 มองว่าการบล็อกบอท AI แบบเหมารวมไม่ใช่ทางเลือกที่ฉลาดเสมอ รายชื่อบอท ตัวอย่างไฟล์ และวิธีตัดสินใจอยู่ที่ robots.txt สำหรับ AI bots ส่วนไฟล์อีกตัวที่คนสับสนบ่อยอยู่ที่ llms.txt คืออะไร
ใครต้องแก้ robots.txt และข้อควรระวัง
robots.txt เป็นไฟล์ที่เว็บส่วนใหญ่แก้น้อยครั้ง แต่ผิดครั้งเดียวกระทบทั้งเว็บ จึงควรรู้ว่าตัวเองอยู่กลุ่มไหน
- ไม่ต้องแตะเพิ่ม: เว็บ WordPress หรือเว็บสำเร็จรูปที่ใช้ไฟล์เริ่มต้น มีบรรทัด Sitemap และสถานะในรายงาน robots.txt เป็น Fetched
- ควรตั้งเพิ่ม: ร้านค้าออนไลน์ที่มีตัวกรองและหน้าค้นหาสร้าง URL จำนวนมาก เว็บที่มีหลายหมื่นหน้า หรือเว็บที่เห็นสถานะ “Discovered – currently not indexed” เยอะใน Search Console
- ข้อควรระวัง: แก้ทีละน้อยและจดวันที่แก้ไว้ เช็กไฟล์ทุกครั้งหลังย้ายเว็บ เปลี่ยนธีม หรือขึ้นเว็บจาก staging อย่าใช้ robots.txt แทน noindex รหัสผ่าน หรือ canonical และถ้าตั้งกลุ่มเฉพาะชื่อบอท ให้คัดลอกกฎของกลุ่ม
*ที่ต้องการลงไปด้วยทุกครั้ง
ถ้าอยากปูพื้นงานค้นหาทั้งระบบทีละขั้นก่อน เริ่มที่ เรียน SEO ฟรีทีละขั้น
robots.txt เป็นส่วนหนึ่งของ technical SEO ขั้นพื้นฐาน บทความนี้เขียนโดยทีม The Missing Piece นำโดย ไอซ์ ศิริพงษ์ จากสเปกและเอกสารทางการของ Google มาตรฐาน RFC 9309 และข้อมูลที่เราเก็บเองจาก robots.txt ของเว็บไทย 56 เว็บที่ติดหน้า 1
อยากให้การเช็ก robots.txt, สถานะ index และ technical SEO ทำงานต่อเองทุกสัปดาห์ ทั้งบน Google และในคำตอบ AI: คอร์ส Agentic SEO & AI Search สอนสด 2 วันด้วย Claude Code (จ. 21 – อ. 22 ธ.ค. 2026) สร้าง agent ที่วัดว่า ChatGPT กับ Gemini พูดถึงแบรนด์คุณไหม แล้วทำงานกับเว็บของคุณต่อทุกสัปดาห์
คำถามที่พบบ่อย
robots.txt คืออะไร
robots.txt คือไฟล์ข้อความที่วางไว้ที่รากของเว็บ เพื่อบอก crawler อย่าง Googlebot ว่า URL ไหนเข้าได้ URL ไหนไม่ควรเข้า ไฟล์นี้คุมการ crawl ไม่ได้คุมการ index ถ้าไม่อยากให้หน้าขึ้นผลค้นหา ให้ใช้ noindex หรือรหัสผ่าน
ไม่มีไฟล์ robots.txt ได้ไหม
ได้ ถ้า robots.txt ตอบ 404 Google ถือว่าไม่มีข้อห้ามและ crawl ได้ทุกหน้า แต่ควรมีไฟล์เพื่อใส่บรรทัด Sitemap และกันส่วนที่ไม่จำเป็น สิ่งที่อันตรายกว่าไม่มีไฟล์คือไฟล์ที่ตอบ 5xx เพราะ Google จะหยุด crawl ทั้งเว็บชั่วคราว
บล็อกหน้าใน robots.txt แล้ว ทำไมยังขึ้นใน Google
เพราะ robots.txt กันแค่การ crawl ถ้ามีลิงก์จากที่อื่นชี้มา Google ยัง index URL นั้นได้แบบไม่มีคำอธิบาย และขึ้นสถานะ “Indexed, though blocked by robots.txt” ใน Search Console ถ้าไม่อยากให้ติด ให้ปลด Disallow แล้วใส่ noindex ให้ Google เห็น ถ้าอยากให้ติด แค่ปลด Disallow
ใช้ robots.txt ซ่อนหน้า admin หรือข้อมูลลับได้ไหม
ไม่ได้ ไฟล์ robots.txt เปิดให้ทุกคนอ่าน และบอทที่ไม่ทำตามกติกาก็เข้าได้อยู่ดี มาตรฐาน RFC 9309 ระบุว่าไฟล์นี้ไม่ใช่มาตรการความปลอดภัย ข้อมูลลับต้องปิดด้วยรหัสผ่านหรือระบบล็อกอิน
robots.txt กับ noindex ต่างกันยังไง
robots.txt บอกว่าอย่าเข้ามาอ่าน ส่วน noindex บอกว่าอ่านได้แต่อย่าแสดงในผลค้นหา ห้ามใช้คู่กันกับหน้าเดียว เพราะถ้า Disallow ไว้ Google จะมองไม่เห็นแท็ก noindex และเพิกเฉยคำสั่งนั้น
แก้ robots.txt แล้วนานแค่ไหน Google ถึงเห็น
Google เก็บไฟล์ไว้และรีเฟรชราวทุก 24 ชั่วโมง ถ้าต้องการเร็วกว่านั้น ให้กด Request a recrawl ในรายงาน robots.txt ของ Search Console การ crawl หน้าที่เพิ่งปลดบล็อกอาจใช้เวลานานกว่านั้น Google ไม่รับประกันว่าจะ crawl ทันที
แหล่งอ้างอิง
- Google Search Central, Robots.txt Introduction and Guide (last updated 2025-12-10 ตรวจ 15 ต.ค. 2026: ใช้จัดการการ crawl, “not a mechanism for keeping a web page out of Google”, URL ที่ถูกบล็อกขึ้นผลค้นหาได้แบบไม่มีคำอธิบาย, ผลกับหน้า ไฟล์สื่อ และ resource, ไม่ใช่ทุกบอททำตาม)
- Google Crawling, How to write and submit a robots.txt file (last updated 2025-11-21 ตรวจ 15 ต.ค. 2026: ชื่อไฟล์ ตำแหน่งที่ราก 1 ไฟล์ต่อ protocol host port, UTF-8, path ขึ้นต้นด้วย /, คอมเมนต์ด้วย #,
*ไม่รวม AdsBot, ทดสอบด้วยรายงาน robots.txt และ open-source library, Wix และ Blogger) - Google Crawling, How Google interprets the robots.txt specification (last updated 2026-08-31 ตรวจ 15 ต.ค. 2026: 500 KiB, cache ไม่เกิน 24 ชั่วโมงโดยทั่วไป, 2xx/3xx/4xx/5xx, field ที่รองรับ 4 ตัว, crawl-delay ไม่รองรับ, กลุ่มเจาะจงที่สุดกลุ่มเดียวไม่รวมกับ *, กลุ่มชื่อซ้ำรวมกัน, path ยาวสุดชนะ เสมอใช้กฎที่จำกัดน้อยกว่า, path สนตัวพิมพ์,
*และ$) - Google Crawling, Update your robots.txt file (last updated 2025-11-21: รีเฟรชราวทุก 24 ชั่วโมง, Request a recrawl) · Useful robots.txt rules (last updated 2026-06-12) · Changelog (20 พ.ย. 2025: ย้ายเอกสาร crawling จาก Search Central)
- Google Search Central, Robots meta tag, data-nosnippet, and X-Robots-Tag specifications (last updated 2026-03-24 ตรวจ 15 ต.ค. 2026: noindex, X-Robots-Tag สำหรับ PDF และรูป, คำสั่งจะถูกเพิกเฉยถ้า URL ถูก Disallow, nosnippet และ max-snippet มีผลกับ AI Overviews และ AI Mode)
- Google Search Central Blog, A note on unsupported rules in robots.txt (2 ก.ค. 2019 เก่ากว่า 2024 แต่เป็นแหล่งต้นทางของกติกาที่ยังใช้: เลิกรองรับ noindex, nofollow และ crawl-delay ใน robots.txt ตั้งแต่ 1 ก.ย. 2019 พร้อมทางเลือก)
- Search Console Help: robots.txt report (ตรวจ 15 ต.ค. 2026: 20 host แรก, สถานะ fetch, ประวัติ 30 วัน, Request a recrawl, ใช้กับ Domain หรือ URL-prefix ระดับโดเมน) · Page indexing report (ตรวจ 15 ต.ค. 2026: Blocked by robots.txt, Indexed though blocked by robots.txt, Validate fix ราว 2 สัปดาห์) · ไม่สามารถเข้าถึง robots.txt
- Search Engine Land, Google Search Console adds robots.txt report (พ.ย. 2023: เปิดรายงาน robots.txt และปลด robots.txt Tester)
- IETF, RFC 9309 Robots Exclusion Protocol (ก.ย. 2022: มาตรฐานของไฟล์, 4xx = ไม่มีข้อห้าม, ไม่ใช่มาตรการความปลอดภัย)
- WordPress Core, Changes to prevent search engines indexing sites (2 ก.ย. 2019, WordPress 5.3: Discourage ใส่ meta noindex แทน Disallow) · Rank Math, Add sitemaps to robots.txt (เมนู Edit robots.txt)
- ข้อมูลของ The Missing Piece: robots.txt ของเว็บธุรกิจที่ติดผล organic หน้า 1 Google ประเทศไทยใน 13 คำค้นธุรกิจ (สถานะไฟล์และบรรทัด Sitemap n = 62 เก็บ 5 ต.ค. 2026 · อ่านกฎ n = 56 เก็บ 15 ต.ค. 2026 ขอไฟล์เว็บละ 1 ครั้ง) · Wilson 95% CI · ผลสังเกตเบื้องต้น ไม่เปิดเผยชื่อเว็บ · การเปิดอ่านบทความไทยที่ติดอันดับ 8 หน้า และสังเกต AI Overview คำ “robots.txt” และ “robots.txt คือ” อย่างละ 1 ครั้ง 15 ต.ค. 2026 · ปริมาณค้นหาจาก Ahrefs ประเทศไทย 15 ต.ค. 2026
- Nathan Gotch, AI SEO For Dummies (Wiley, 2026), บทที่ 2 (crawl → index → rank และไม่ใช่ทุกบอทที่ทำตาม robots.txt) · บทที่ 10 (crawl สองมุมแบบ Googlebot กับบอททั่วไป และหมวดปัญหา robots, noindex, resource ที่ถูกบล็อก) · บทที่ 22 (บล็อก AI crawler ไม่ใช่ทางเลือกที่ฉลาดเสมอ)
- Eric Enge, Stephan Spencer, Jessie Stricchiola, The Art of SEO, 4th ed. (O’Reilly, 2023), บทที่ 7 (robots.txt, meta robots และ canonical: แยกการคุม crawl ออกจากการคุม index) · บทที่ 10 (ลำดับไล่หน้าที่ไม่ถูก index) · เครื่องมือในเล่มที่ Google เปลี่ยนแล้ว (robots.txt Tester) เช็กกับเอกสารปัจจุบัน
ตรวจข้อมูลล่าสุด: 15 ต.ค. 2026